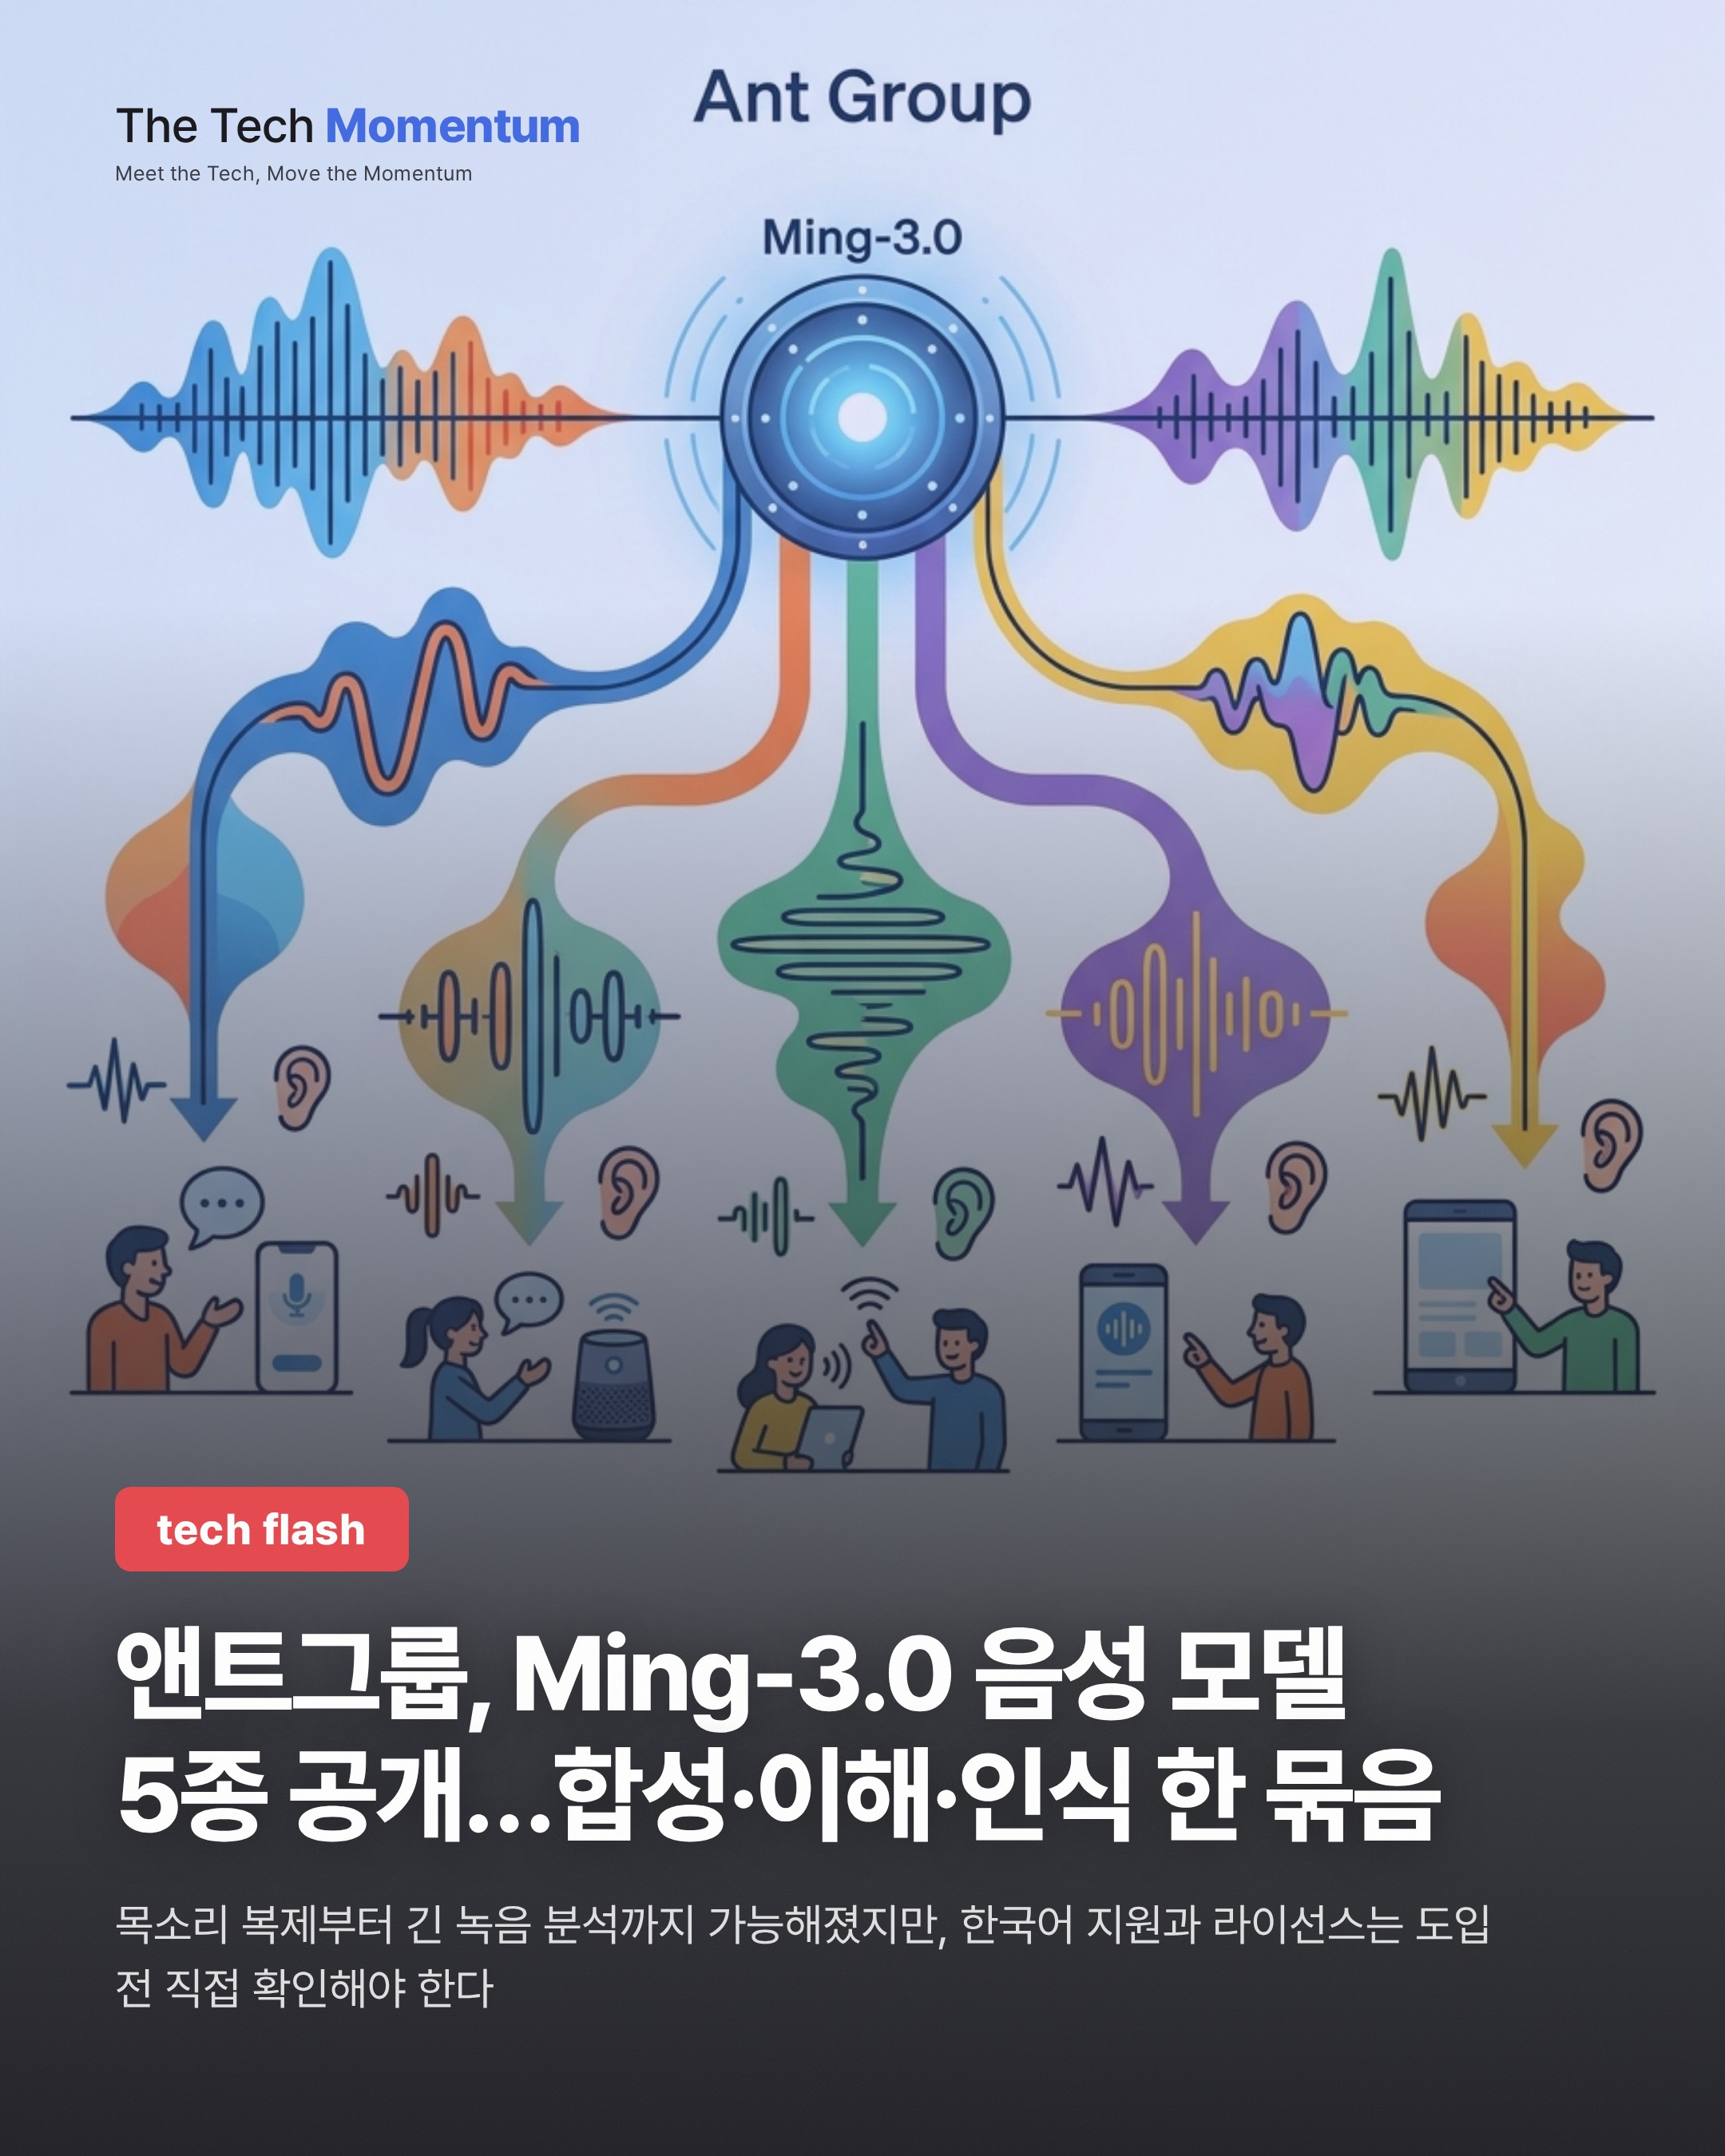
중국 핀테크 기업 앤트그룹(Ant Group)이 10월 20일 음성 모델군 Ming-3.0을 공개했다. 모델은 모두 5종이다. 음성 합성, 오디오 이해·대화, 음성 인식 세 분야로 나뉜다. 개발자는 모델을 하나씩 쓰거나 여러 개를 묶어 음성 기반 애플리케이션을 만들 수 있다.
기능별로 나눠 보면
▼ Ming-3.0 모델군 기능 정리 (출처: IT Home 보도)
| 분야 | 주요 기능 |
|---|---|
| 음성 합성(TTS) | 참조 녹음 기반 음성 복제, 자연어 설명으로 목소리 설계, 감정·강조·속도 지정 |
| 오디오 이해·대화 | 긴 녹음의 전사·요약·분석, 화자·감정·배경음 정보 유지 |
| 음성 인식 | 음성을 텍스트로 변환 |
음성 합성: 복제와 설계
텍스트 음성 변환(TTS) 모델은 두 가지 방식으로 목소리를 만든다. 하나는 참조 녹음을 바탕으로 한 음성 복제다. 다른 하나는 자연어 설명만으로 목소리를 만드는 음성 디자인이다. 감정, 강조, 속도를 지정해 말하는 방식도 직접 지시할 수 있다.
오디오 이해: 긴 녹음 처리
오디오 모델은 긴 녹음을 전사하고 요약하고 분석한다. 이때 화자, 감정, 배경음 정보를 함께 유지한다고 앤트는 밝혔다.
이미 쓰이는 곳
앤트는 이 모델들이 이미 자사 서비스에 쓰인다고 밝혔다. 건강 앱 아푸(Afu), 알리페이(Alipay) 검색, 내부 업무 도구가 해당한다.
한국 개발자가 볼 지점
이번 보도에는 모델별 성능 수치와 벤치마크가 없다. 라이선스 조건과 한국어 지원 여부도 확인되지 않는다. 한국 개발자가 도입을 검토한다면 공개 저장소의 모델별 설명과 라이선스를 직접 확인해야 한다.