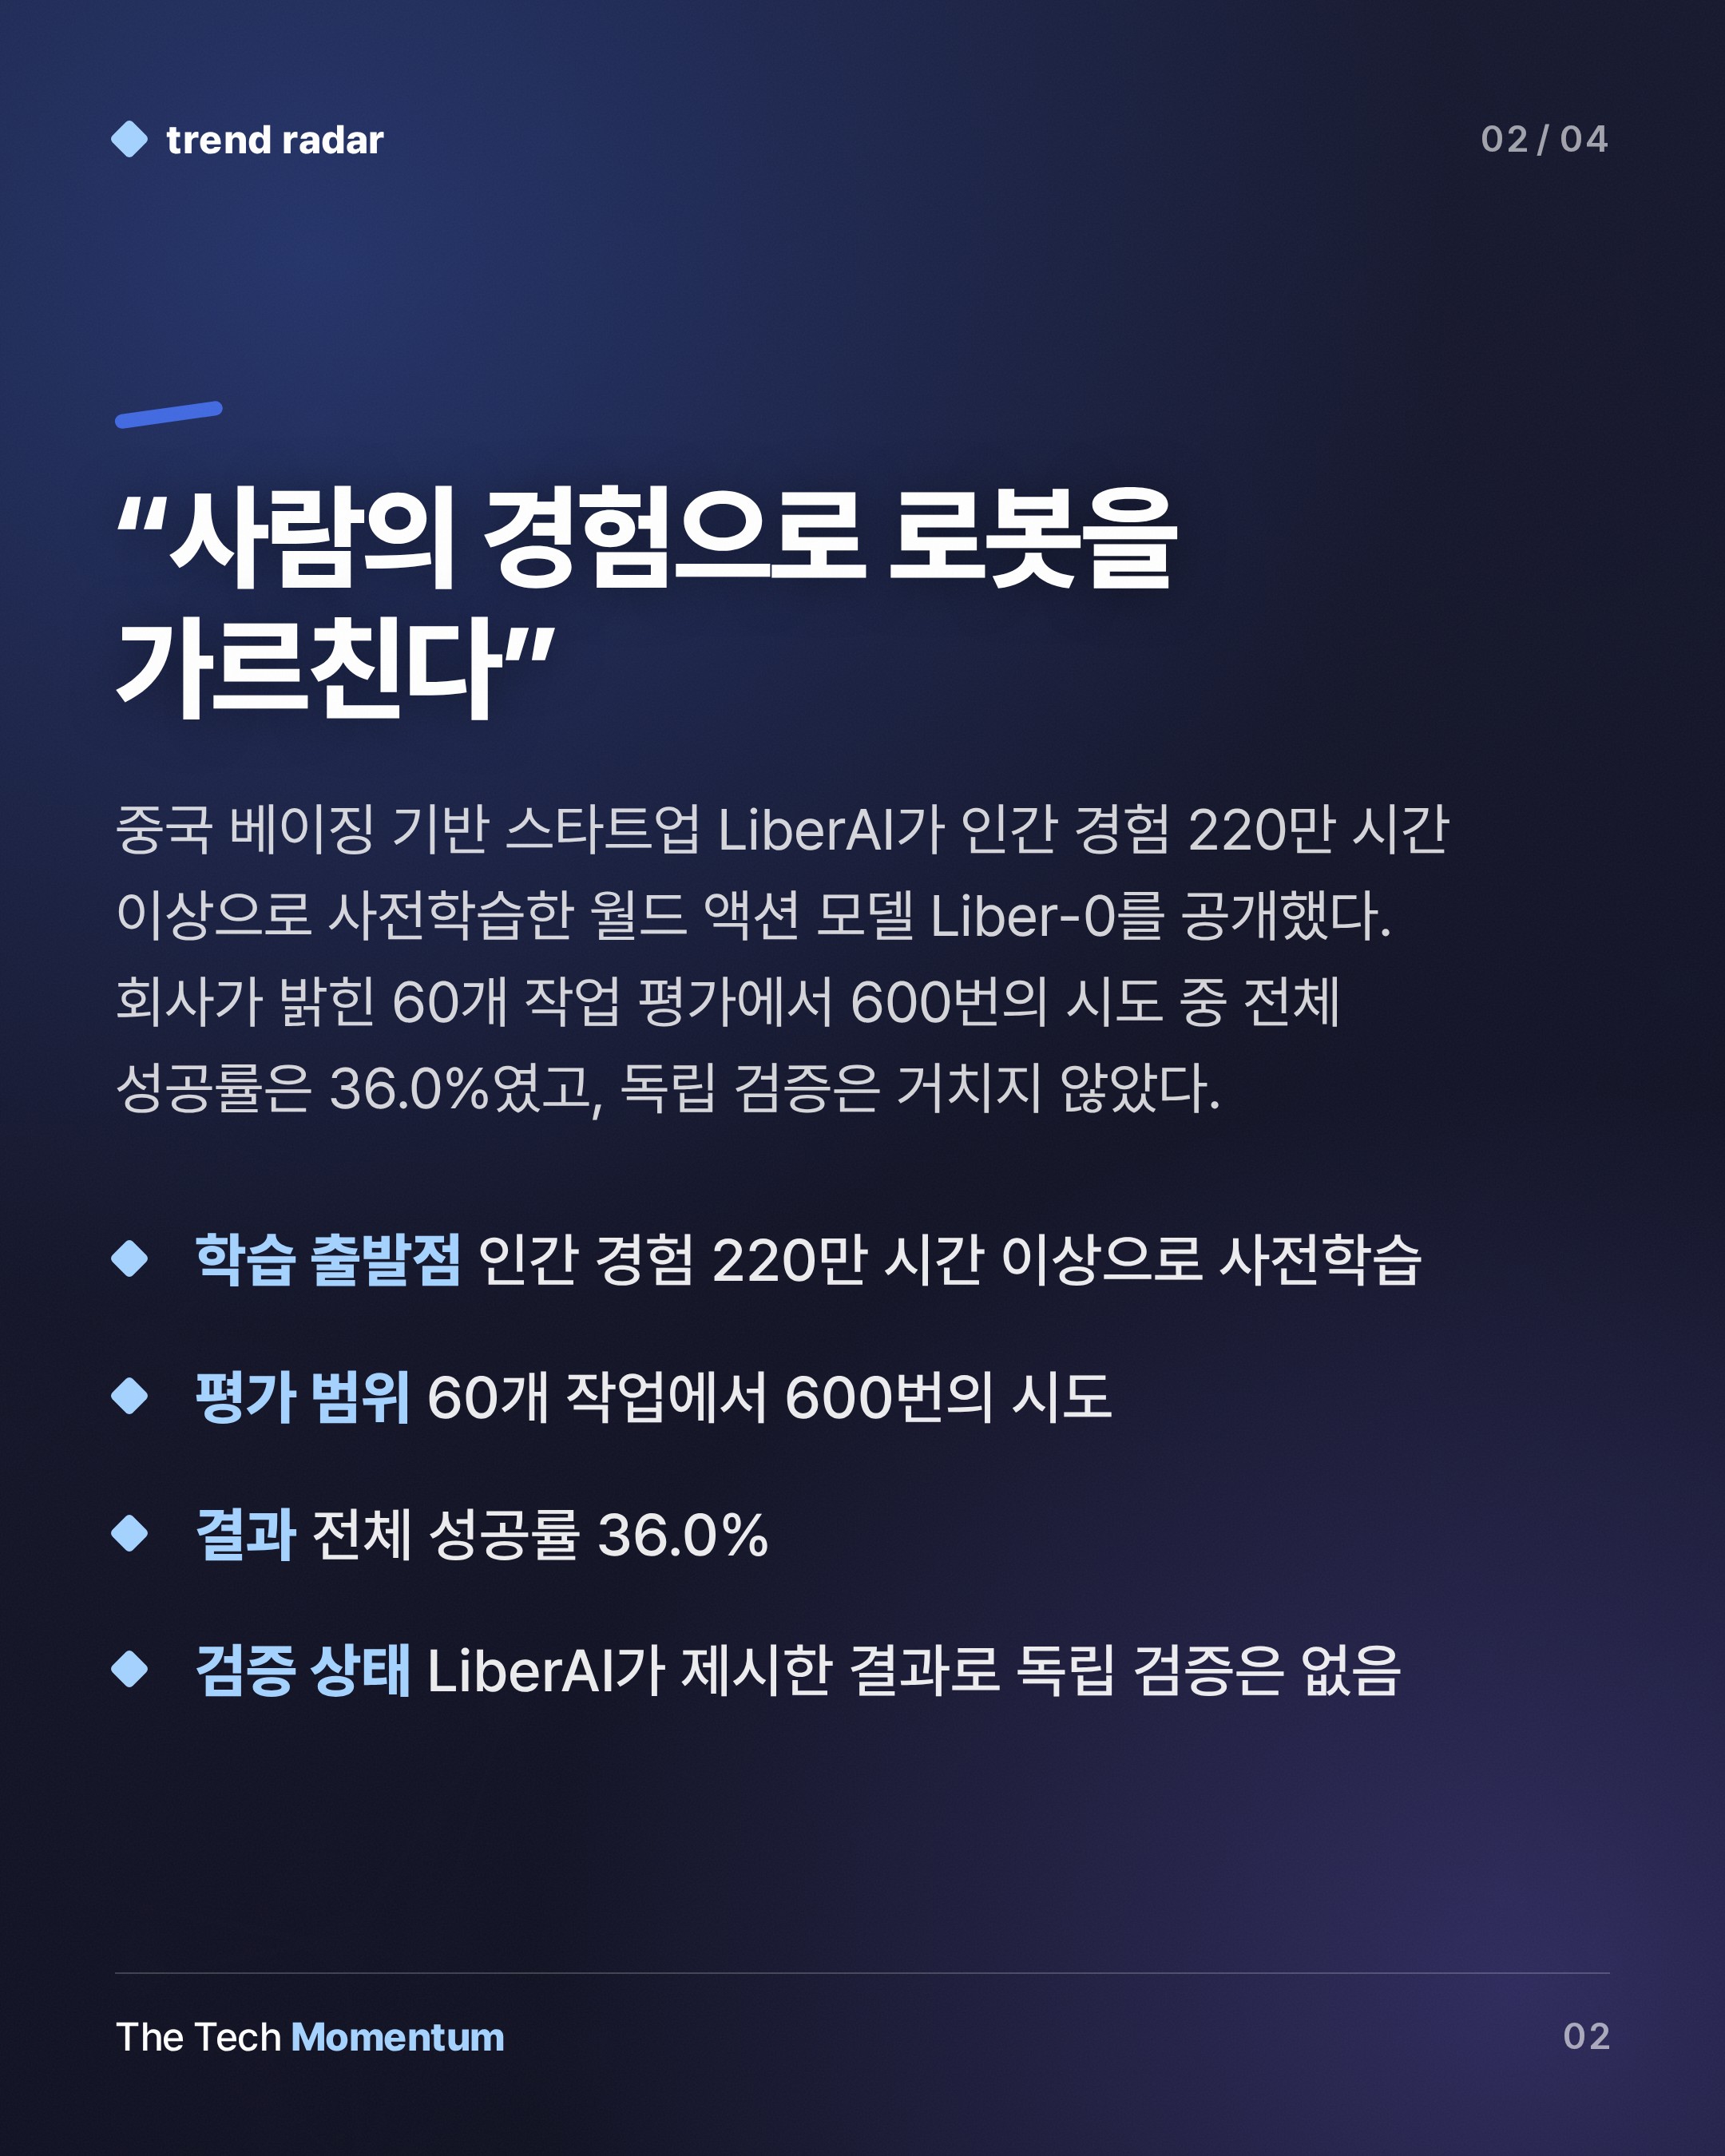
60개 작업, 600번의 시도. 그 결과가 전체 성공률 36.0%였다. 중국 베이징 기반 스타트업 LiberAI가 공개한 월드 액션 모델(WAM) Liber-0의 제로샷 평가 성적이다. 이 수치는 LiberAI가 직접 제시한 결과다. 독립 검증을 거친 것은 아니다.
로봇 데이터가 아니라 사람의 경험에서 출발
로봇 조작 학습은 지금까지 특정 로봇에서 특정 작업을 시연한 데이터에 크게 기대 왔다. 대개 사람이 로봇을 원격 조종해 얻는다. 실제 배치 환경과 잘 맞는다는 장점이 있다. 하지만 새 작업이나 새 로봇이 나올 때마다 시연을 다시 모아야 해서 느리고 비싸다. 반면 사람의 활동은 훨씬 풍부하고, 상당수가 이미 영상으로 남아 있다.
Liber-0는 이 점에서 출발했다. 인간 경험 220만 시간 이상으로 사전학습했다. LiberAI에 따르면 걸림돌은 영상이 곧바로 로봇 명령이 되지 않는다는 점이다. 카메라 위치가 다르고, 영상에서 추정한 손 자세에는 잡음이 많고, 사람과 로봇은 몸의 움직임이 다르다.
세 갈래로 잇는 인간과 로봇
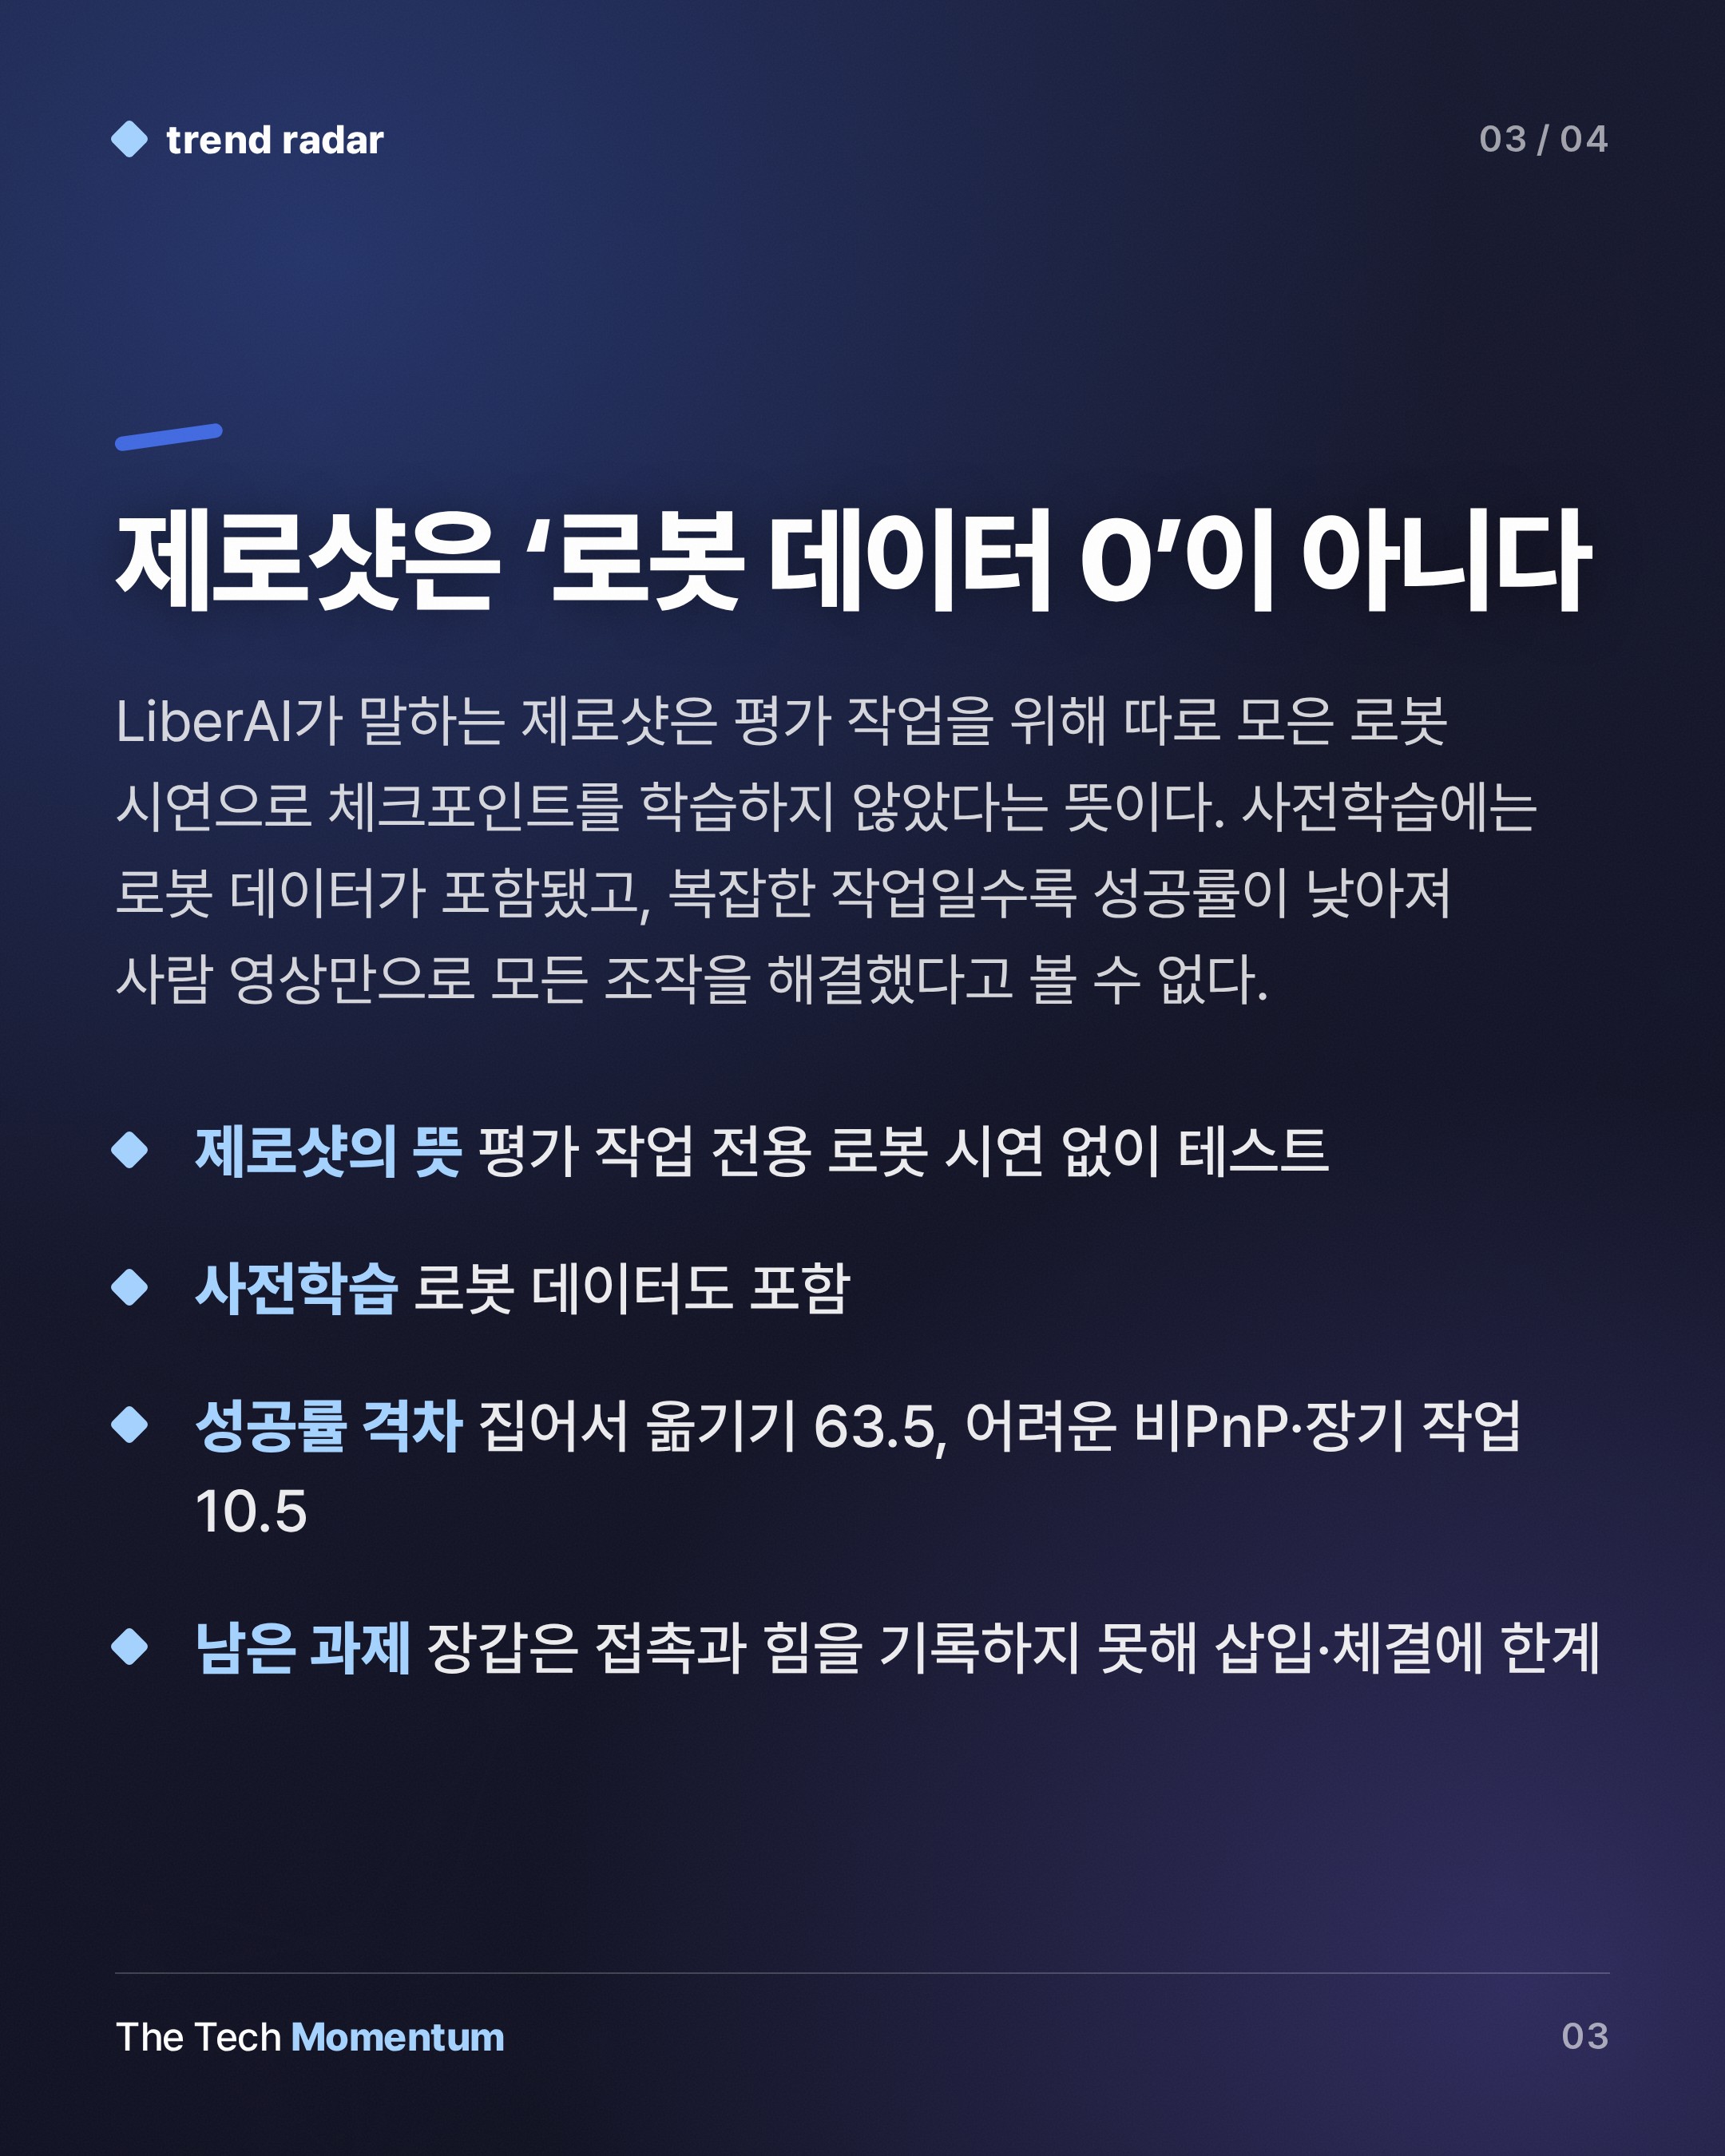
LiberAI가 내놓은 해법은 세 가지다.
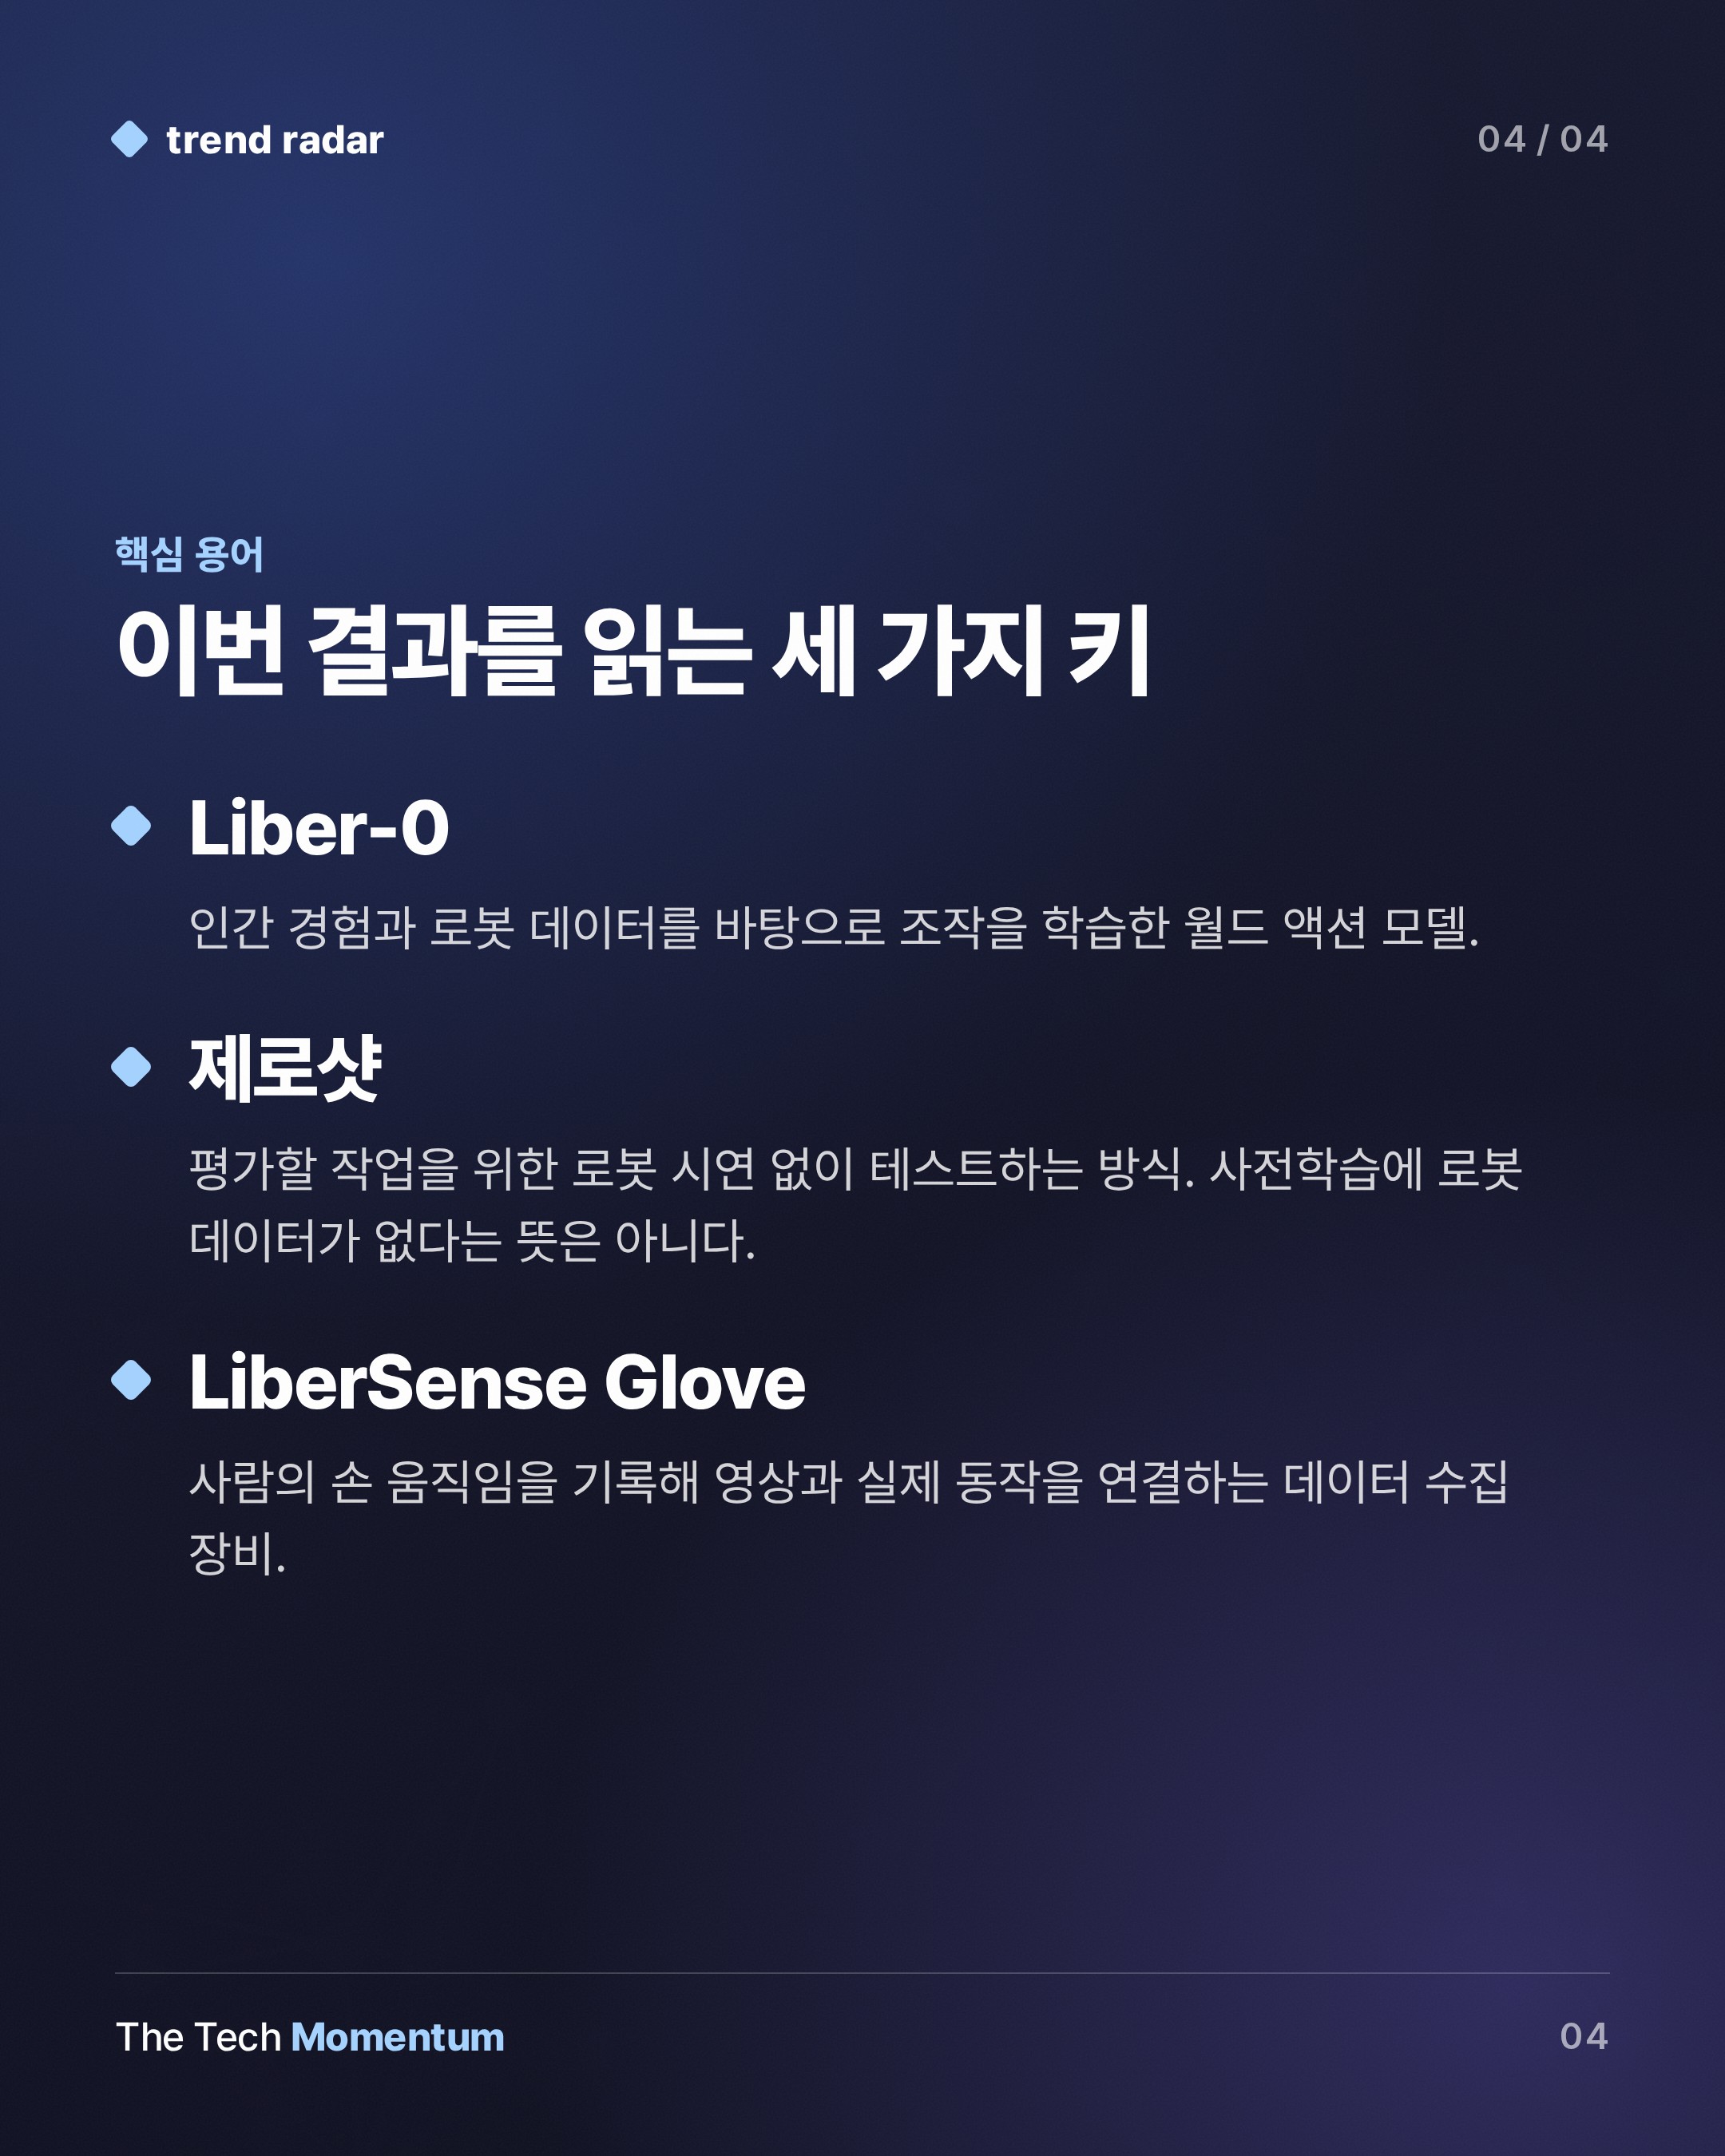
- LiberSense Glove: 손 움직임을 직접 기록하는 데이터 수집 장비다. 영상과 그 뒤의 실제 동작을 이어 준다.
- 로봇 플랫폼 설계: 카메라 시점과 손·손목·허리 움직임을 사람과 가깝게 맞췄다. 기술을 옮기기 쉽게 하려는 설계다.
- 통합 신체 표현(Unified Embodiment Representation): 몸의 형태와 관절 움직임 정보를 모델에 줘서, 동작을 수행하는 몸에 맞게 조정하게 한다.
또 Liber-0는 미래 영상 프레임과 동작을 함께 예측한다. 그래서 동작 라벨이 없는 일반 영상도 학습에 쓰고, 장갑·로봇 기록과 함께 활용할 수 있다.
60개 작업 평가 결과
평가는 GPT-6가 제안한 60개 작업으로 했다. 내부 확장성 벤치마크와는 별개다. 구성은 집어서 옮기기(PnP) 20개, PnP 아닌 조작 20개, 어려운 비PnP·장기 작업 20개다. 펜을 필통에 넣기, 서랍 밀어 닫기가 예시다. 펜을 파우치에 넣고 그 파우치를 서랍에 보관하는 긴 작업도 있다.
| 작업 유형 | 성공률 (%) |
|---|---|
| 집어서 옮기기 | 63.5 |
| 비PnP 조작 | 34.0 |
| 어려운 비PnP·장기 작업 | 10.5 |
| 전체 (600회 시도) | 36.0 |
여기서 제로샷은 평가한 체크포인트가 해당 작업을 위해 따로 수집한 로봇 시연으로 학습하지 않았다는 뜻이다. 사전학습에는 로봇 데이터가 여전히 포함됐다. 작업이 복잡해질수록 성공률이 63.5%에서 10.5%로 내려간다는 점도 같은 표에 드러난다.
장갑 데이터가 메운 빈자리
LiberAI는 별도 실험도 제시했다. 로봇 시연은 집어서 옮기기만 담고, 장갑 시연에는 접기·누르기·열기가 들어 있는 조건이다. 진행도 점수(부분 완료도 반영하는 0~100점)로 보면 로봇 데이터만 쓴 정책의 비PnP 점수는 2.2였다. 장갑 기록을 더하자 47.5로 올랐다. 장갑 세트에 집어서 옮기기까지 넣으면 54.6이다. 모든 동작을 로봇으로 시연해 학습한 정책은 56.3이었다. 앞의 60개 작업 평가와는 분리된 통제 실험이다.
로봇 데이터 절감 효과도 따졌다. 8개 작업 평가에서 로봇 시연의 25%와 장갑 시연 전체를 섞은 정책은 75.6점이었다. 로봇 시연 전체로 학습한 정책은 72.8점이다. LiberAI는 로봇 시연을 75% 줄이고도 비슷한 성능이 나왔다고 설명한다. 다만 절감은 로봇 시연에 한정된다. 섞은 정책은 장갑 데이터를 전부 썼다.
사전학습 체크포인트를 그대로 평가한 내부 벤치마크에서는 PnP 81.4점, 비PnP 72.3점이 나왔다. 로봇 후속학습을 더하면 83.6점과 73.8점으로 각각 2.2점, 1.5점 오르는 데 그쳤다.
남은 과제
LiberAI도 한계를 밝혔다. LiberSense Glove는 손 자세와 궤적은 기록하지만 접촉과 힘은 기록하지 못한다. 삽입, 체결, 부드러운 소재 다루기에는 이 정보가 중요하다. 촉각·힘 센싱과 더 다양한 가정에서의 데이터 수집은 앞으로의 연구 과제로 남았다.
이번 36.0%와 장갑 데이터 실험은 그 답을 가늠할 한 사례다. 일반화 성능 전반을 말해 주는 수치는 아니다. 이 글은 LiberAI의 스폰서 콘텐츠를 바탕으로 작성했다.