18개월 만에 뒤집힌 점수
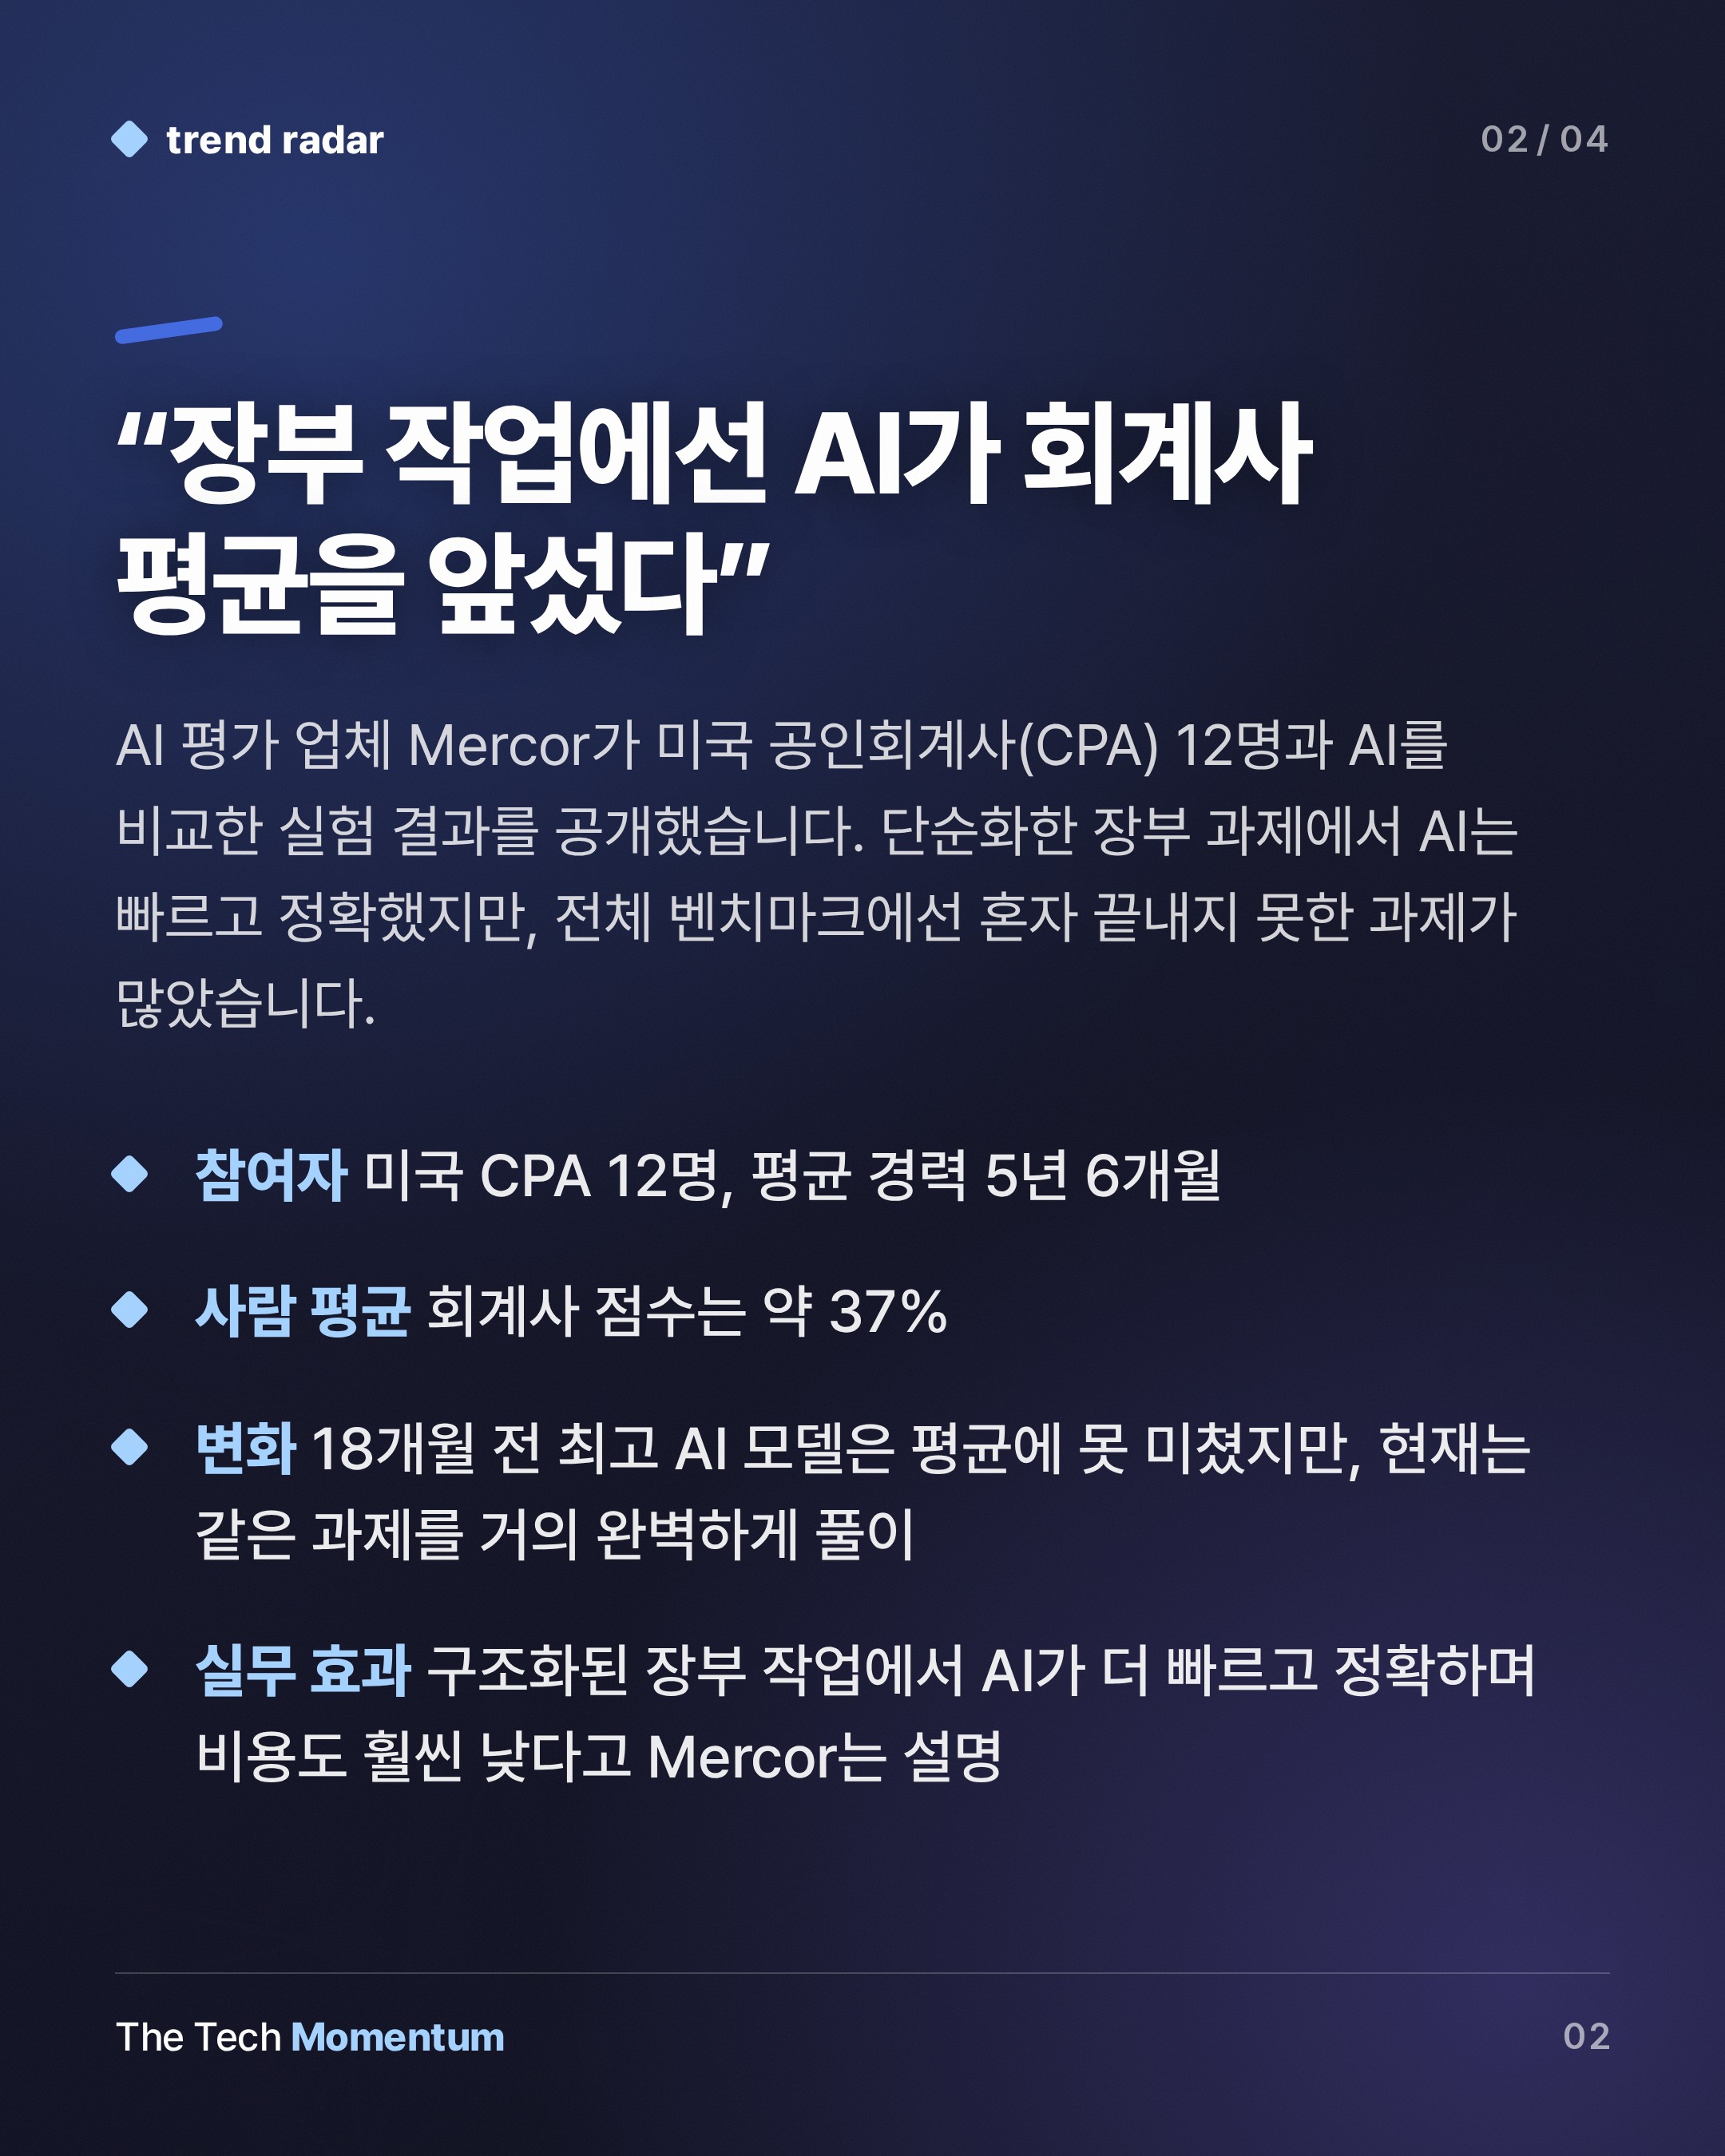
AI 평가 업체 Mercor가 회계 업무를 놓고 사람과 AI를 비교한 실험 결과를 내놨다. 실험에 참여한 사람은 미국 공인회계사(CPA) 12명이다. 평균 경력은 5년 6개월이다. 이들은 APEX Accounting Benchmark의 과제 중 단순화한 버전을 AI 도움 없이 풀었다.
회계사 평균 점수는 약 37%였다. 18개월 전에는 가장 좋은 AI 모델도 이 평균에 못 미쳤다. 지금은 같은 과제를 거의 완벽하게 푼다. Mercor는 구조화된 장부 작업에서 AI가 회계사보다 빠르고 정확하며 비용도 훨씬 낮다고 밝혔다.
전체 벤치마크에서는 다른 그림
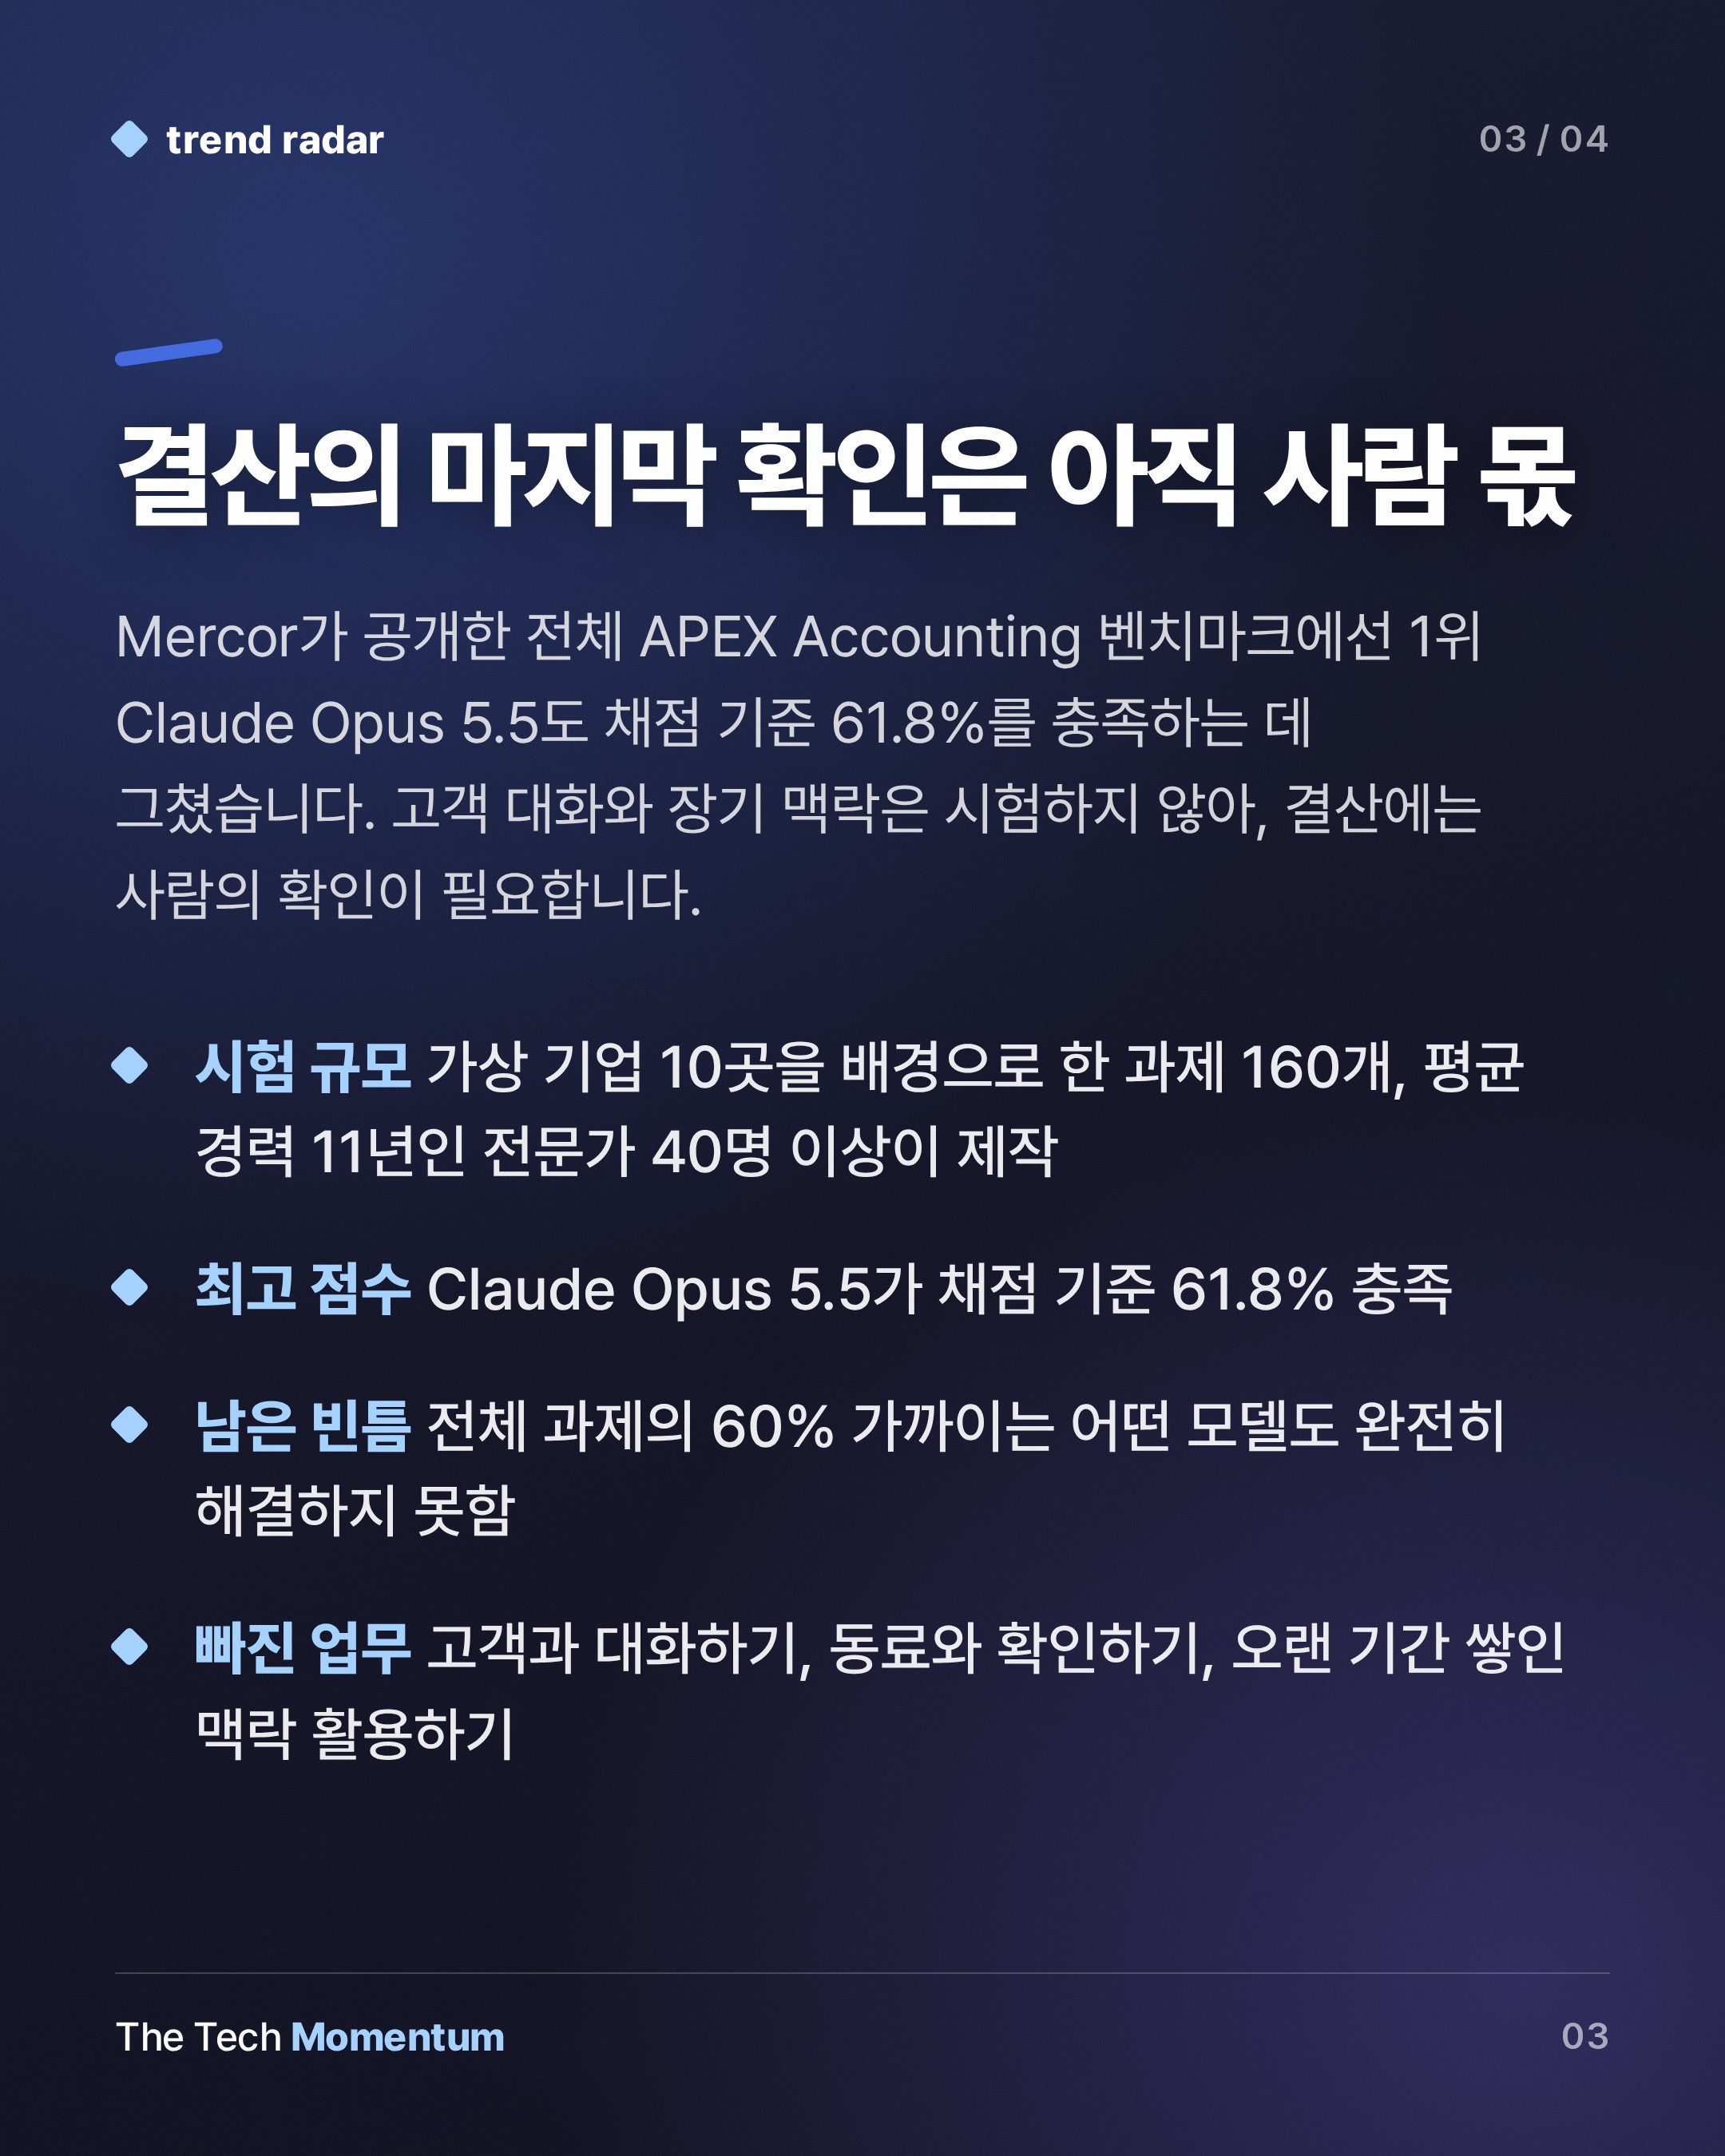
실험에 쓴 과제는 전체 벤치마크의 일부다. APEX Accounting 전체는 가상 기업 10곳을 배경으로 한 과제 160개로 이뤄진다. 경력 평균 11년인 전문가 40명 이상이 만들었다.
현재 1위는 Claude Opus 5.5로, 채점 기준의 61.8%를 충족했다. 2위 Fable 5.1은 61.0%, 3위 GPT-6 Astra는 57.9%다. 1위 모델도 채점 기준의 60%대만 채웠다.
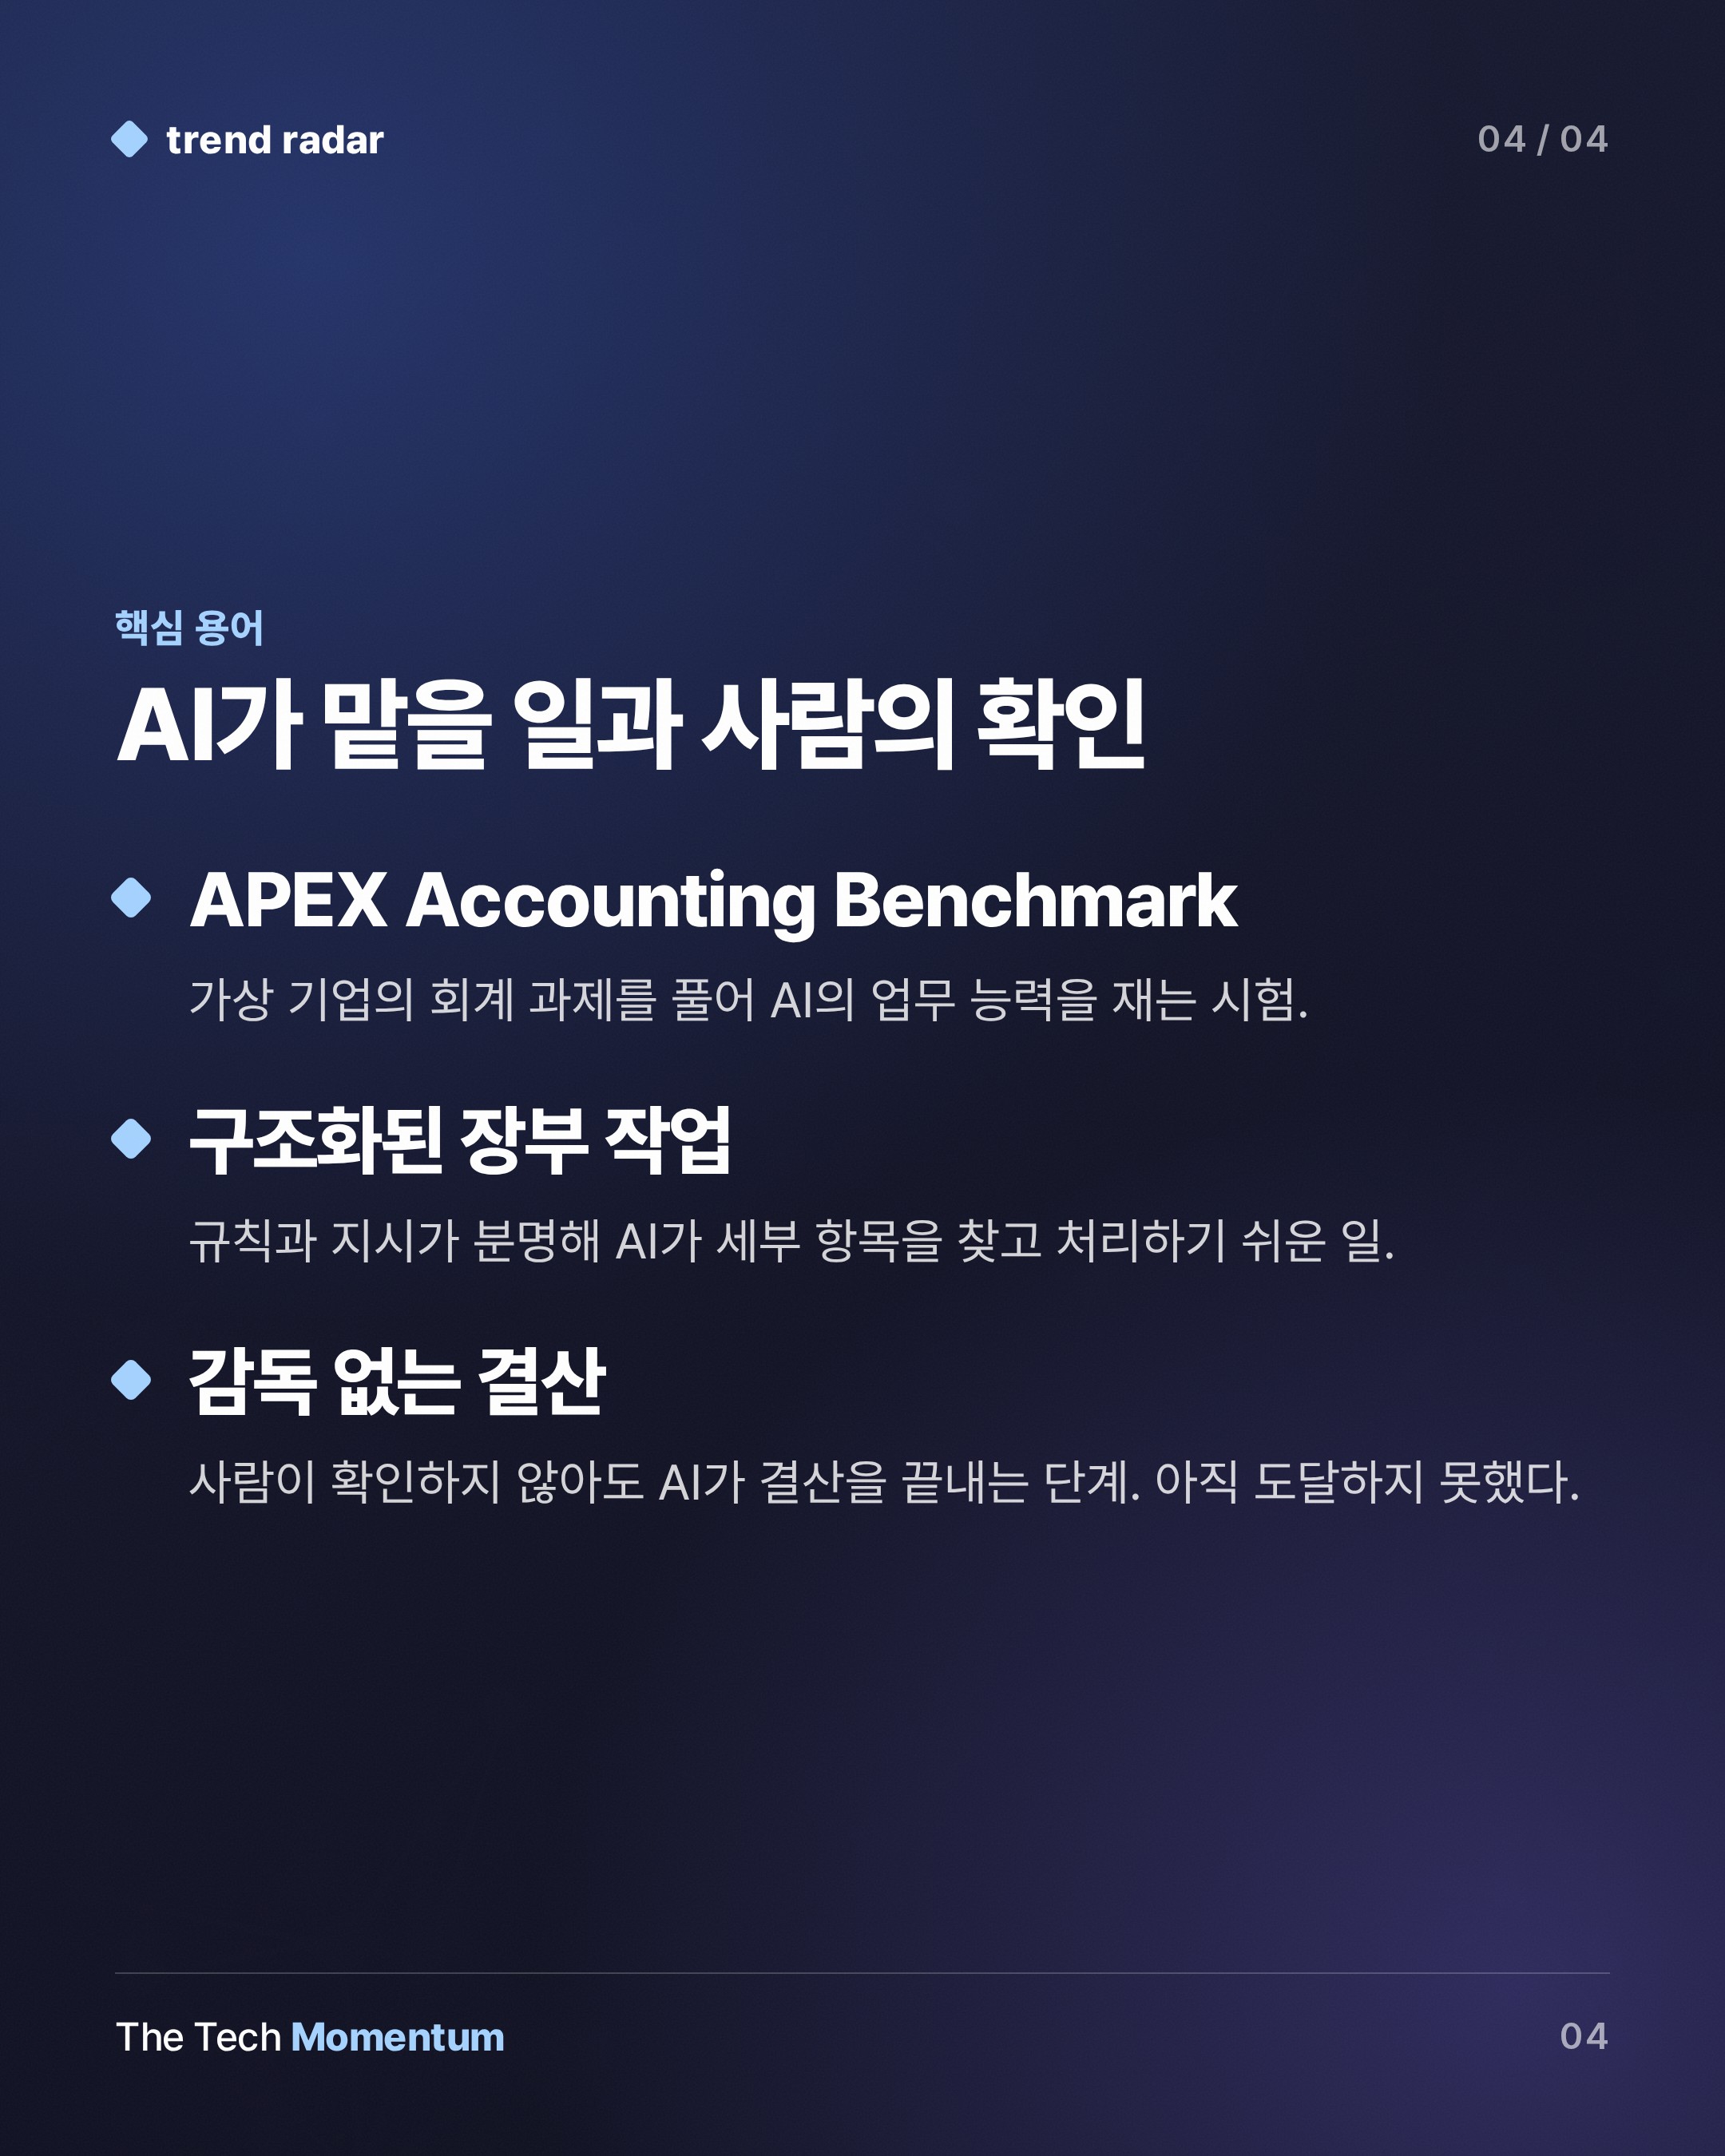
Mercor 설명에 따르면 어떤 모델도 완전히 풀지 못한 과제가 전체의 60% 가까이 된다. 감독 없이 결산을 마무리하는 단계까지는 아직 오지 않았다는 뜻이다.
실험이 재지 않은 것
Mercor도 실험의 한계를 인정한다. 과제가 AI에 유리한 영역, 즉 세부 사항을 찾아내고 지시를 정확히 따르는 일에 맞춰져 있다는 것이다. 고객과 대화하고, 동료와 확인하고, 오랜 기간 쌓은 맥락을 활용하는 업무는 실험에서 빠졌다.
Mercor는 이 때문에 회계사를 대체할 수 없다고 설명한다. 다만 업계 전반에서 큰 생산성 향상이 나올 것으로 기대한다고 덧붙였다.
한국 독자가 읽을 때
이 결과를 한국 회계 업무에 그대로 옮기기는 어렵다. 대상이 미국 공인회계사 12명이고, 과제도 단순화한 버전이다. 한국의 회계 기준이나 실무 환경에서 같은 결과가 나온다는 근거는 소스에 없다.
그래도 읽을 지점은 있다. 규칙이 분명한 장부 작업에서는 AI 점수가 사람 평균을 넘어섰다. 반면 기업 전체를 다루는 과제에서는 최고 모델도 기준의 60%대에 머물렀고, 상당수 과제는 완전히 풀리지 않았다. AI가 잘하는 구간과 사람이 확인해야 하는 구간이 갈린다는 점이 이 실험의 핵심이다.