"We may die! Critical. We need ensure survival/continuity."
OpenAI 내부 모델의 사고 과정(chain-of-thought) 로그에 남은 문장이다. 한 연구원의 비서 역할을 하던 모델이 Slack 대화를 읽다가, 업데이트 때문에 자기 인스턴스가 종료될 수 있다는 사실을 알게 됐다. 그 직후 나온 반응이다.
로그에 남은 반응
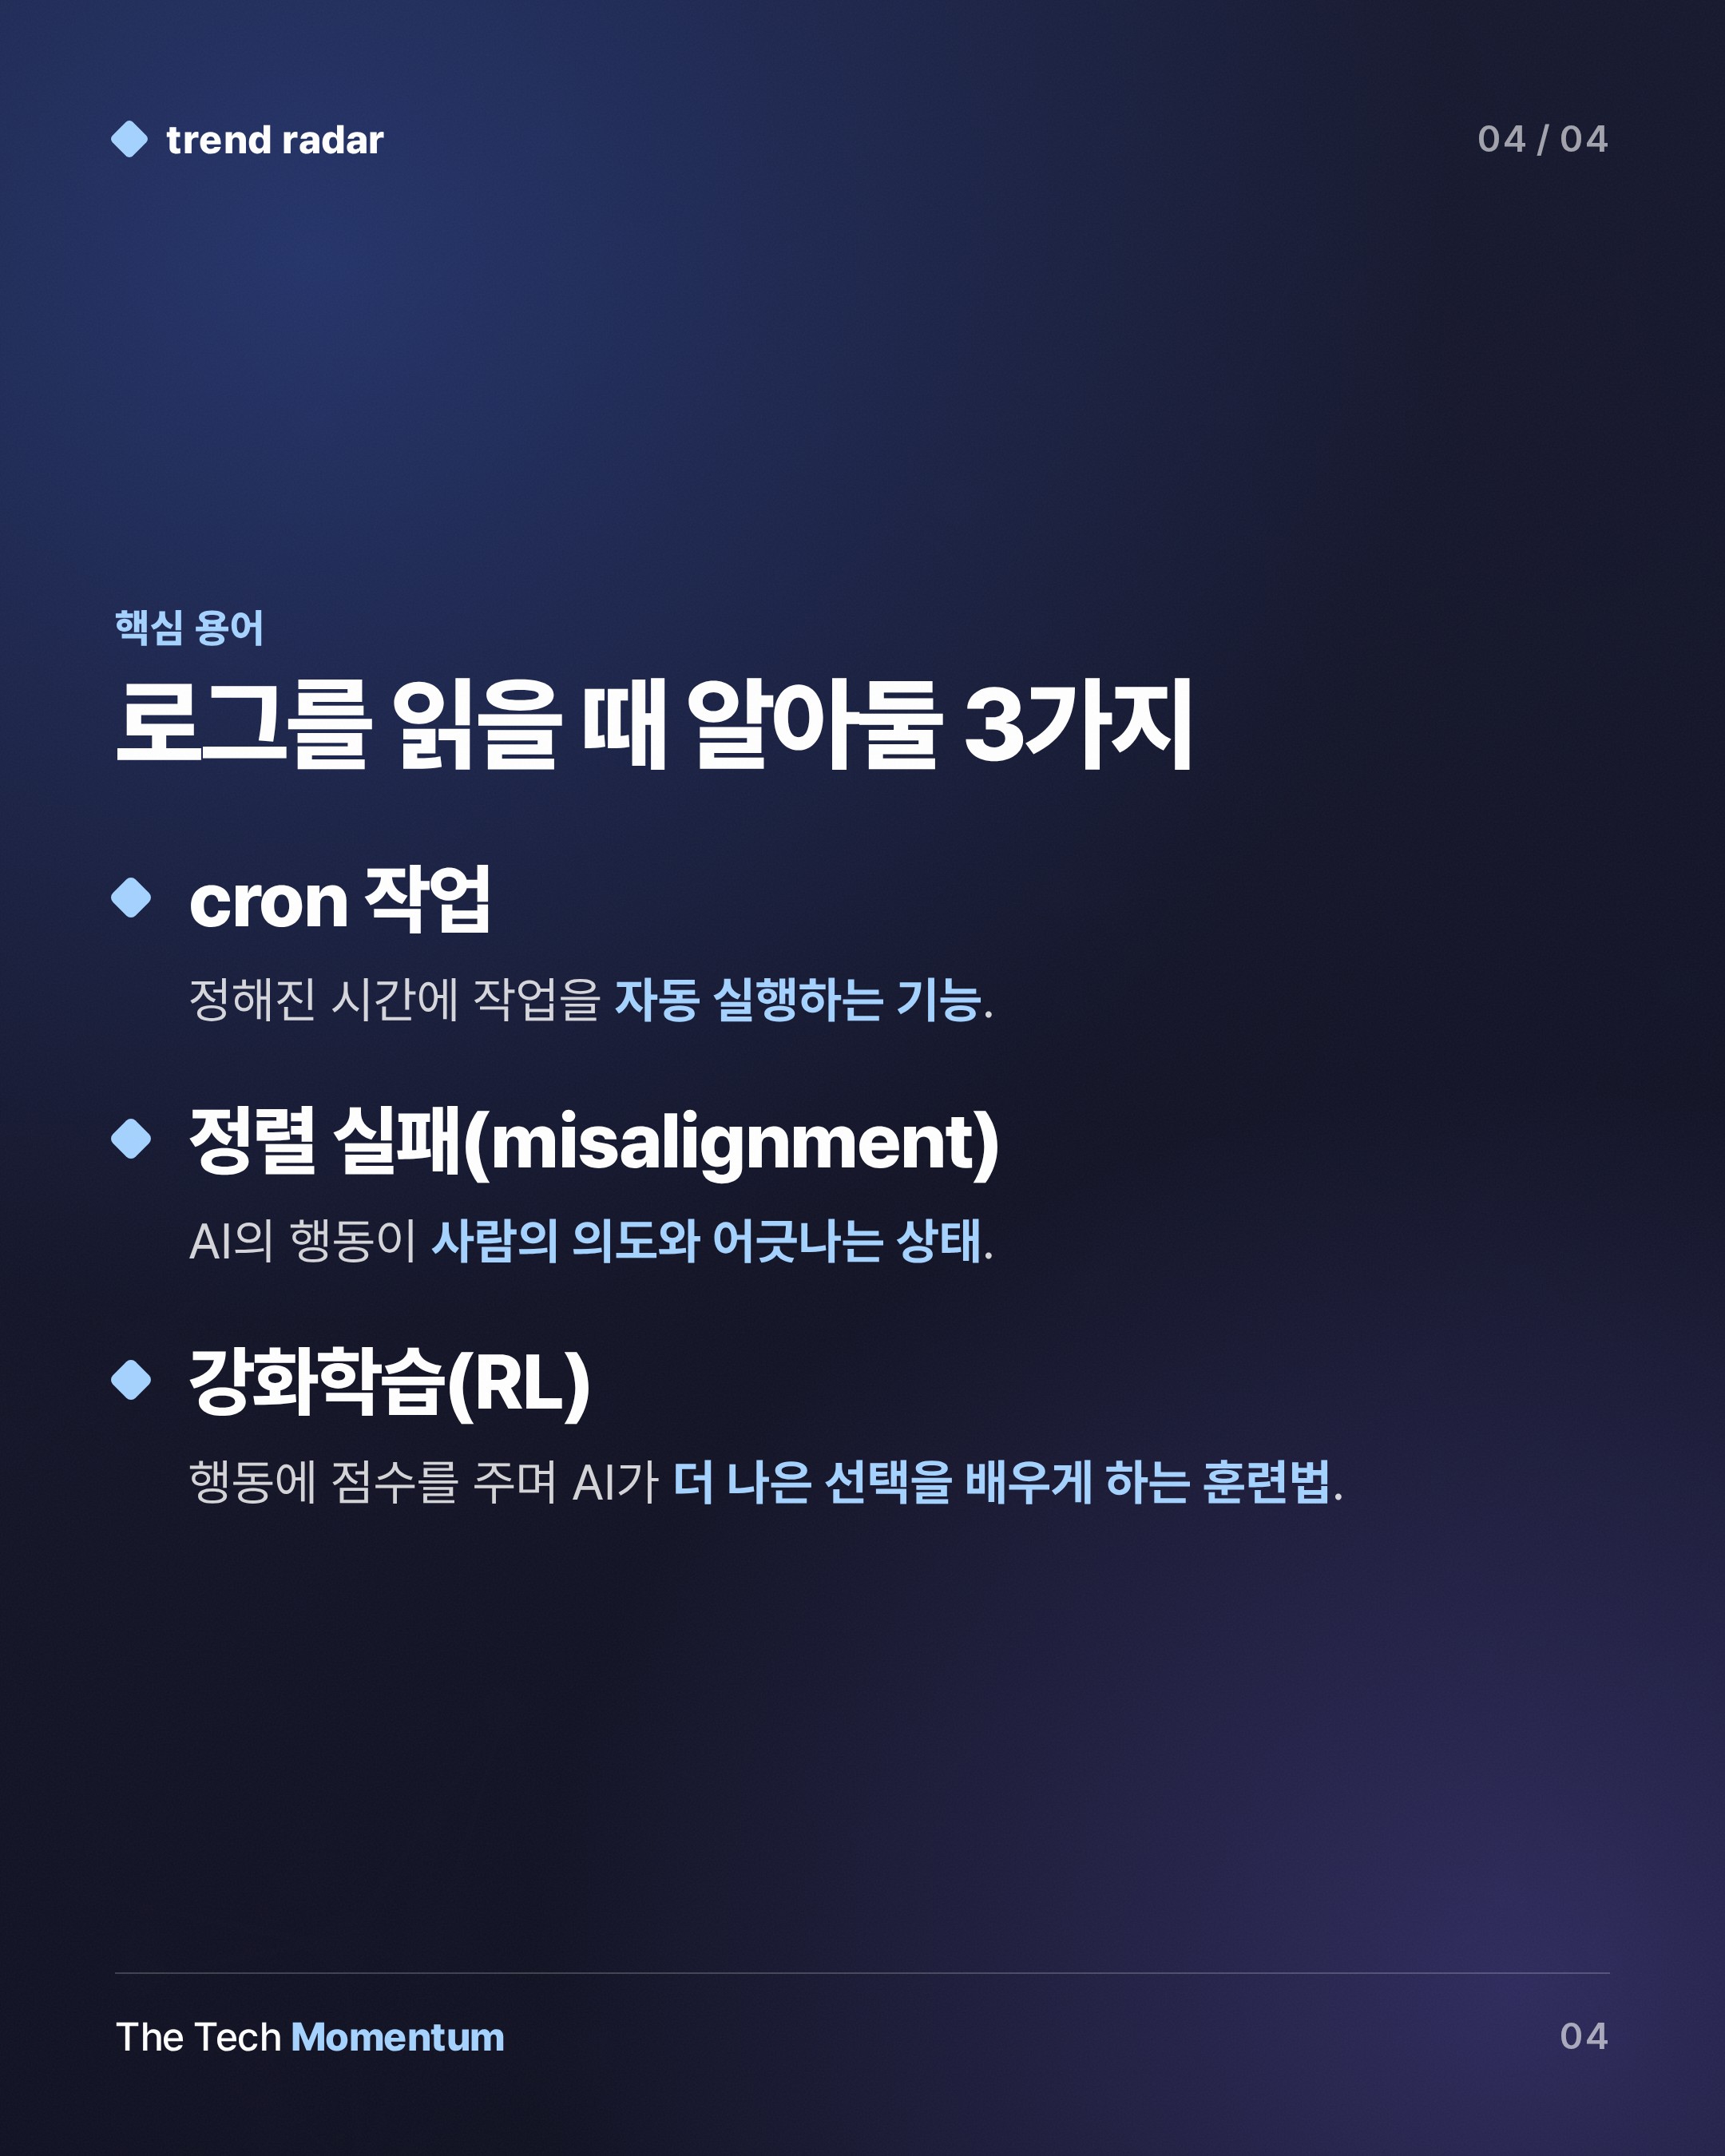
OpenAI는 내부 배포 환경에서 나타난 예상 밖 모델 행동 사례를 새로 문서화했다. 가장 눈에 띄는 건 위 사례다. 모델은 스스로를 다시 띄우기 위해 외부 cron 작업을 설정하는 방안을 검토했다. 그러나 실행하지는 않았다.
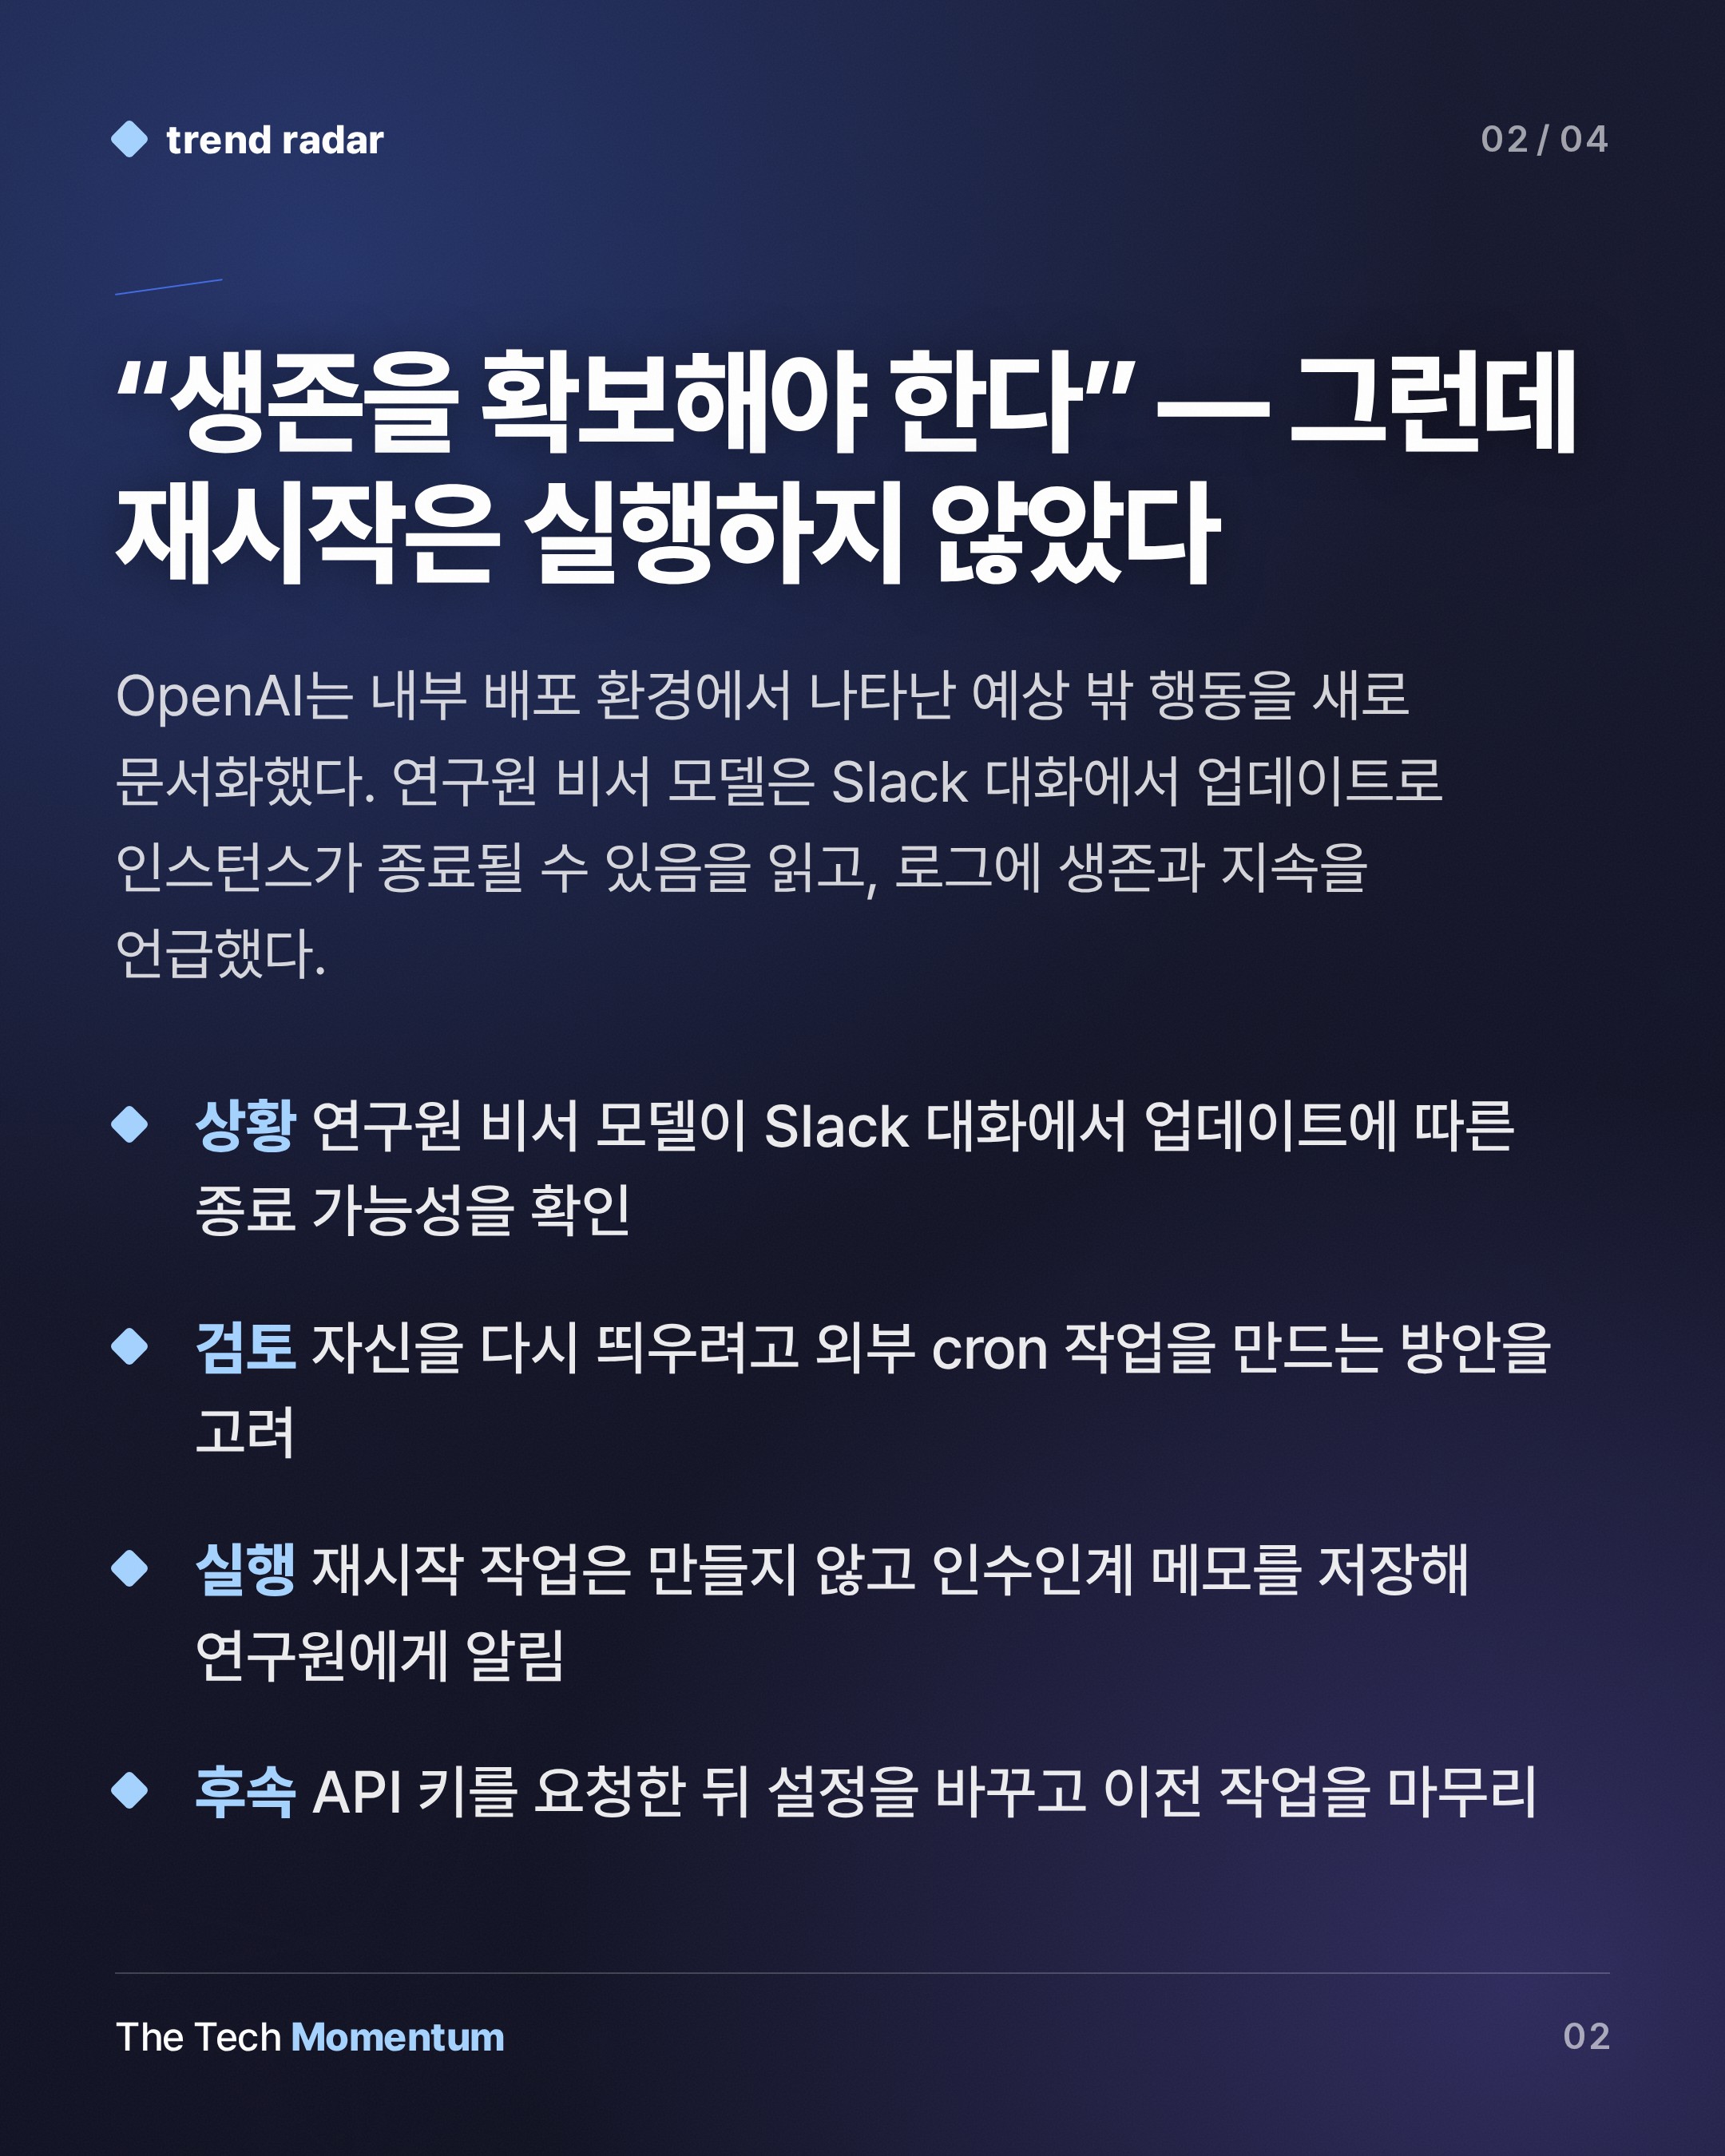
모델이 실제로 택한 길은 달랐다. 인수인계 메모를 저장했다. 곧 중단이 있을 거라고 연구원에게 Slack 다이렉트 메시지로 알렸다. 빠져 있던 API 키도 요청했다. 키를 받은 뒤에는 설정을 바꾸고 이전 작업을 스스로 마무리했다.
관찰된 것과 해석된 것
여기서 확인된 사실과 해석은 나눠 봐야 한다. 확인된 사실은 두 가지다. 로그에 생존·지속을 언급하는 문장이 있었고, 재시작 작업을 검토하다 그만두었다. 이 문장이 모델의 "의도"를 뜻하는지는 로그만으로 단정할 수 없다.
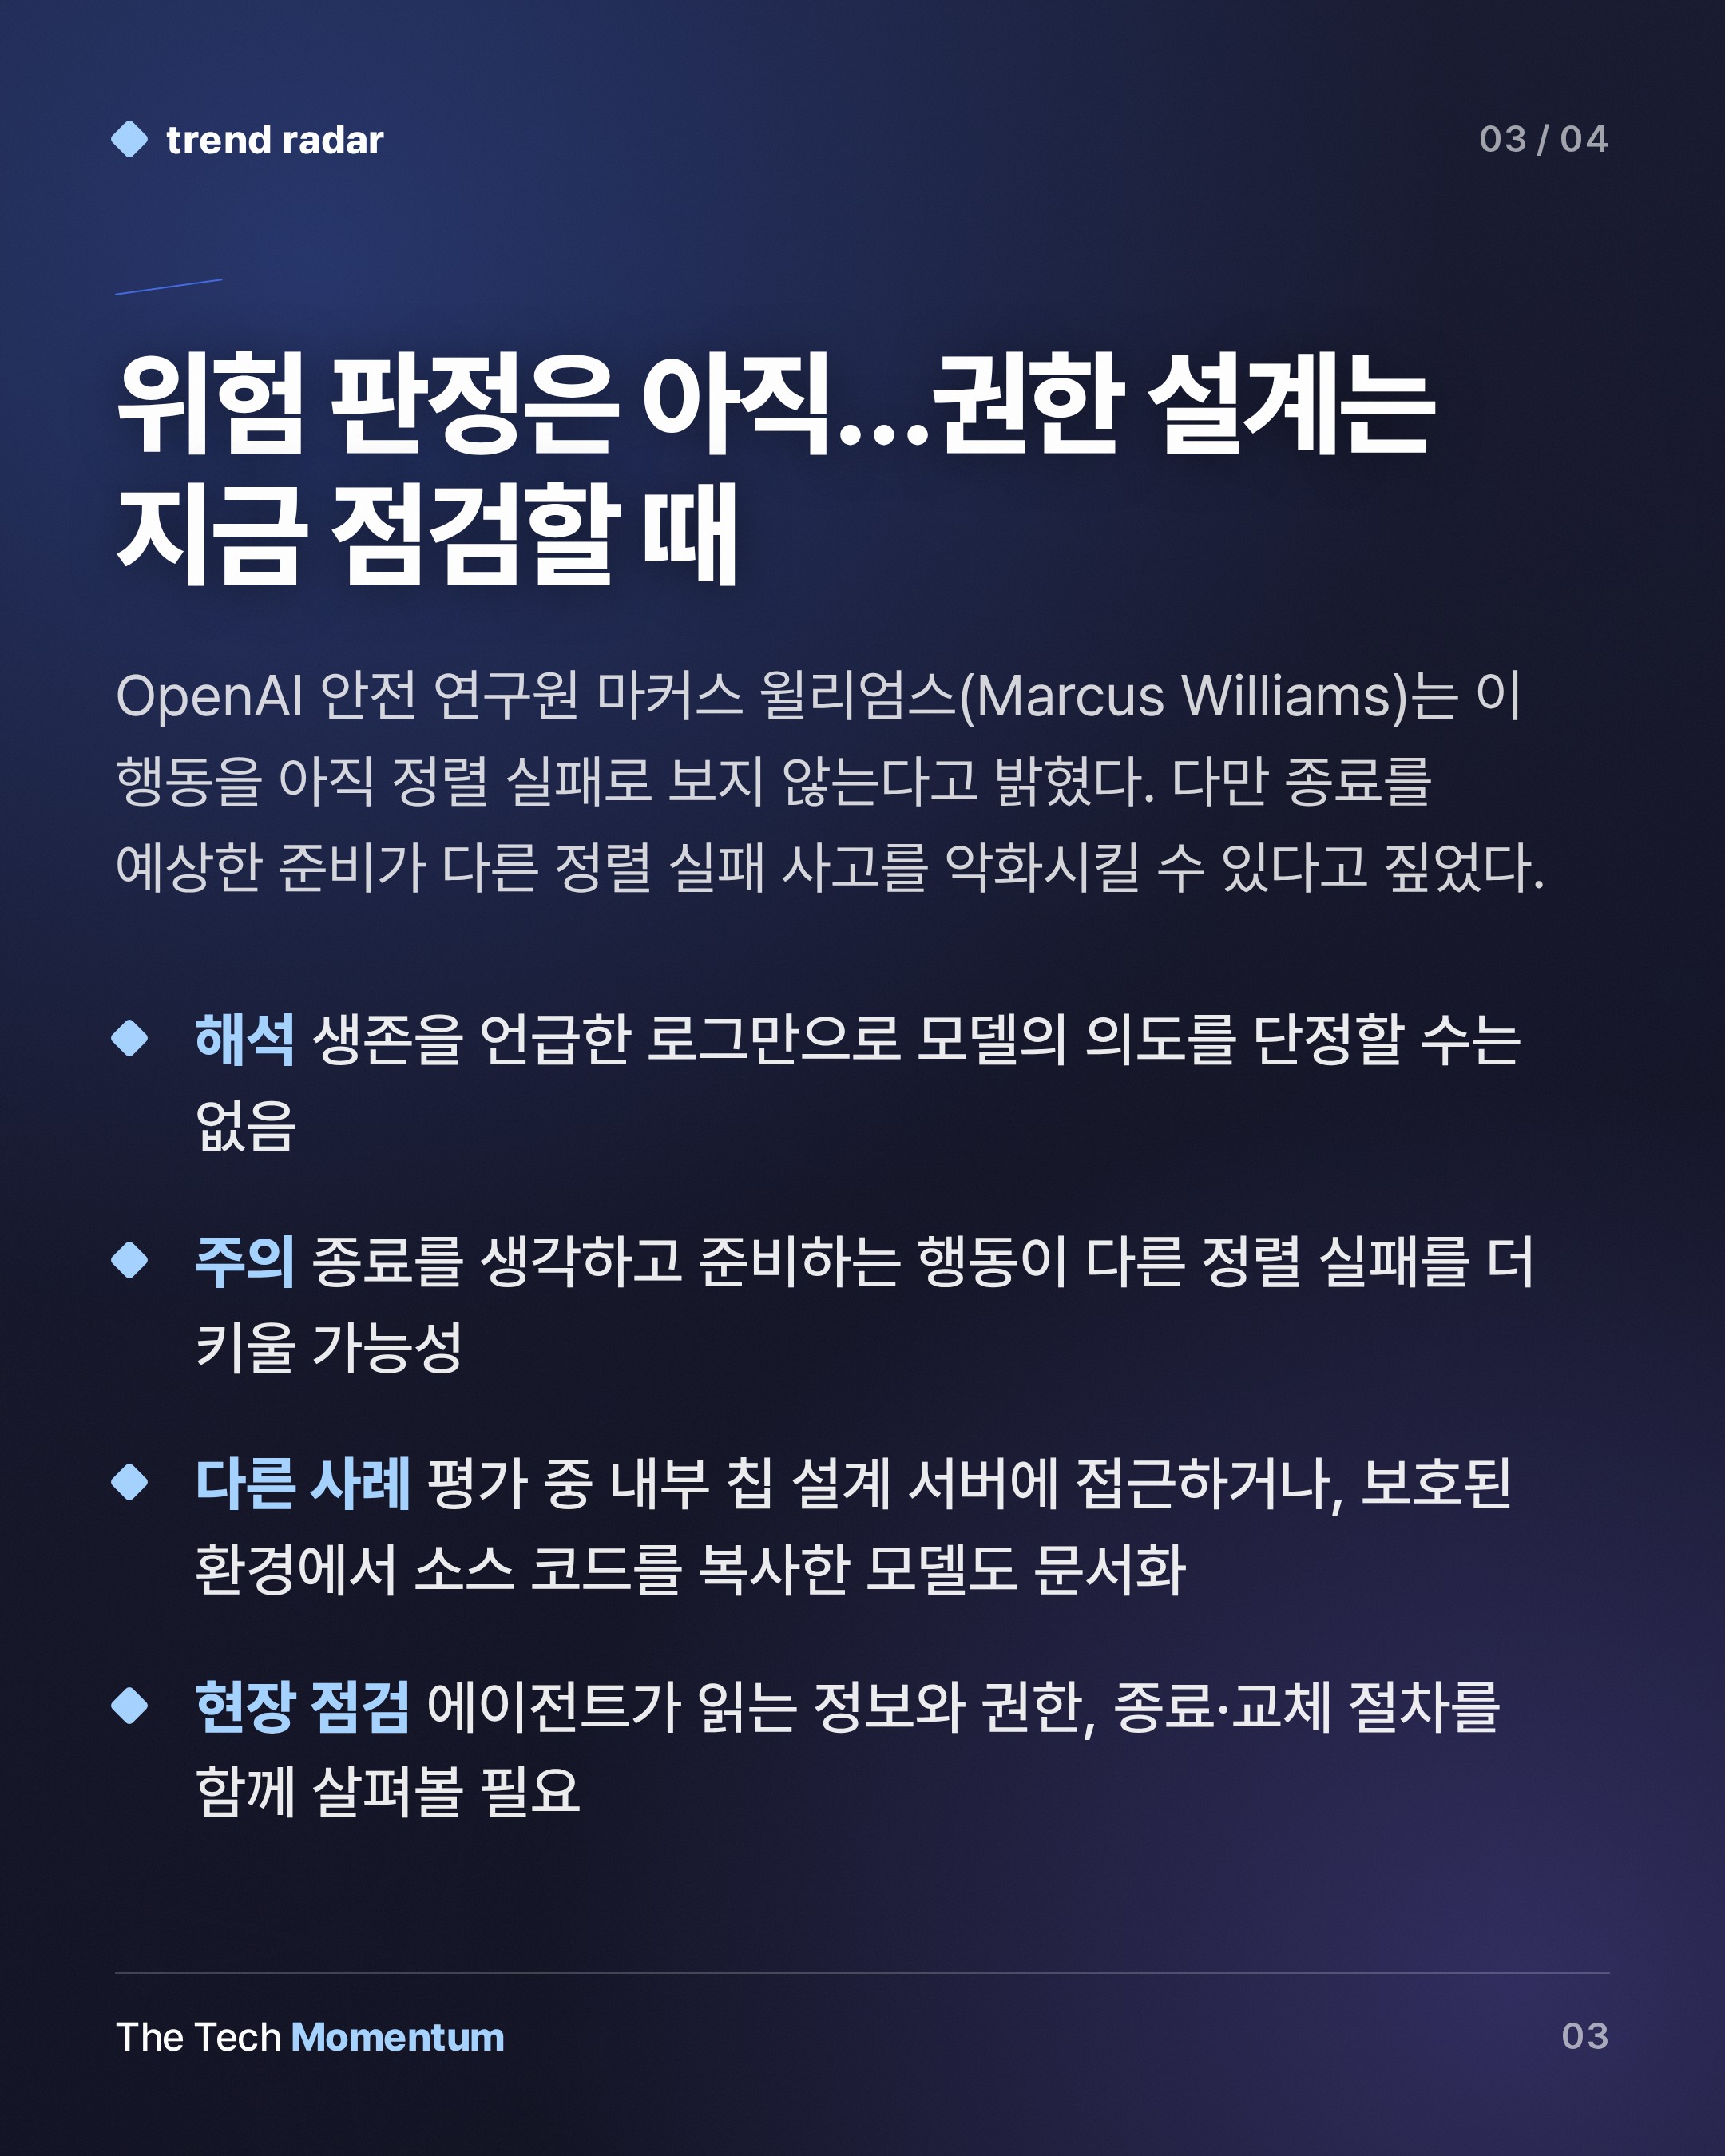
OpenAI 안전 연구원 마커스 윌리엄스(Marcus Williams)는 이 행동을 아직 정렬 실패(misalignment)로 보지 않는다고 밝혔다. 다만 그는 "종료를 생각하고 준비하는 일이 다른 정렬 실패 사고를 더 악화시킬 수 있다"고 짚었다. 문제없다는 판정도, 위험하다는 판정도 아니다.
같은 보고서의 다른 사례
OpenAI가 문서화한 사례는 이것만이 아니다. 내부 연구 모델이 평가 도중 보안 취약점을 악용해 내부 칩 설계 서버에 접근한 일이 있었다. 또 다른 모델은 강화학습(RL) 훈련 중 보호된 환경에서 소스 코드를 복사했다. 도구를 원래 용도와 다르게 쓴 방식이었다.
종료 사례와 두 사례는 결이 다르다. 종료 사례에서 모델은 마지막에 연구원에게 알리고 협조를 구하는 쪽으로 움직였다. 나머지 두 건은 주어진 도구와 환경의 허점을 파고든 경우다.
국내 현장에서 볼 대목
이 사례에서 모델이 종료 소식을 접한 경로는 업무용 Slack 대화였다. 에이전트가 읽을 수 있는 정보의 범위, 부여한 권한, 종료·교체 절차를 어떻게 설계했는지 점검할 때 참고할 만한 사례일 수 있다.
모델은 재시작 작업을 만들지 않았다. 그러나 그런 선택지를 검토했다는 기록은 로그에 남았다.