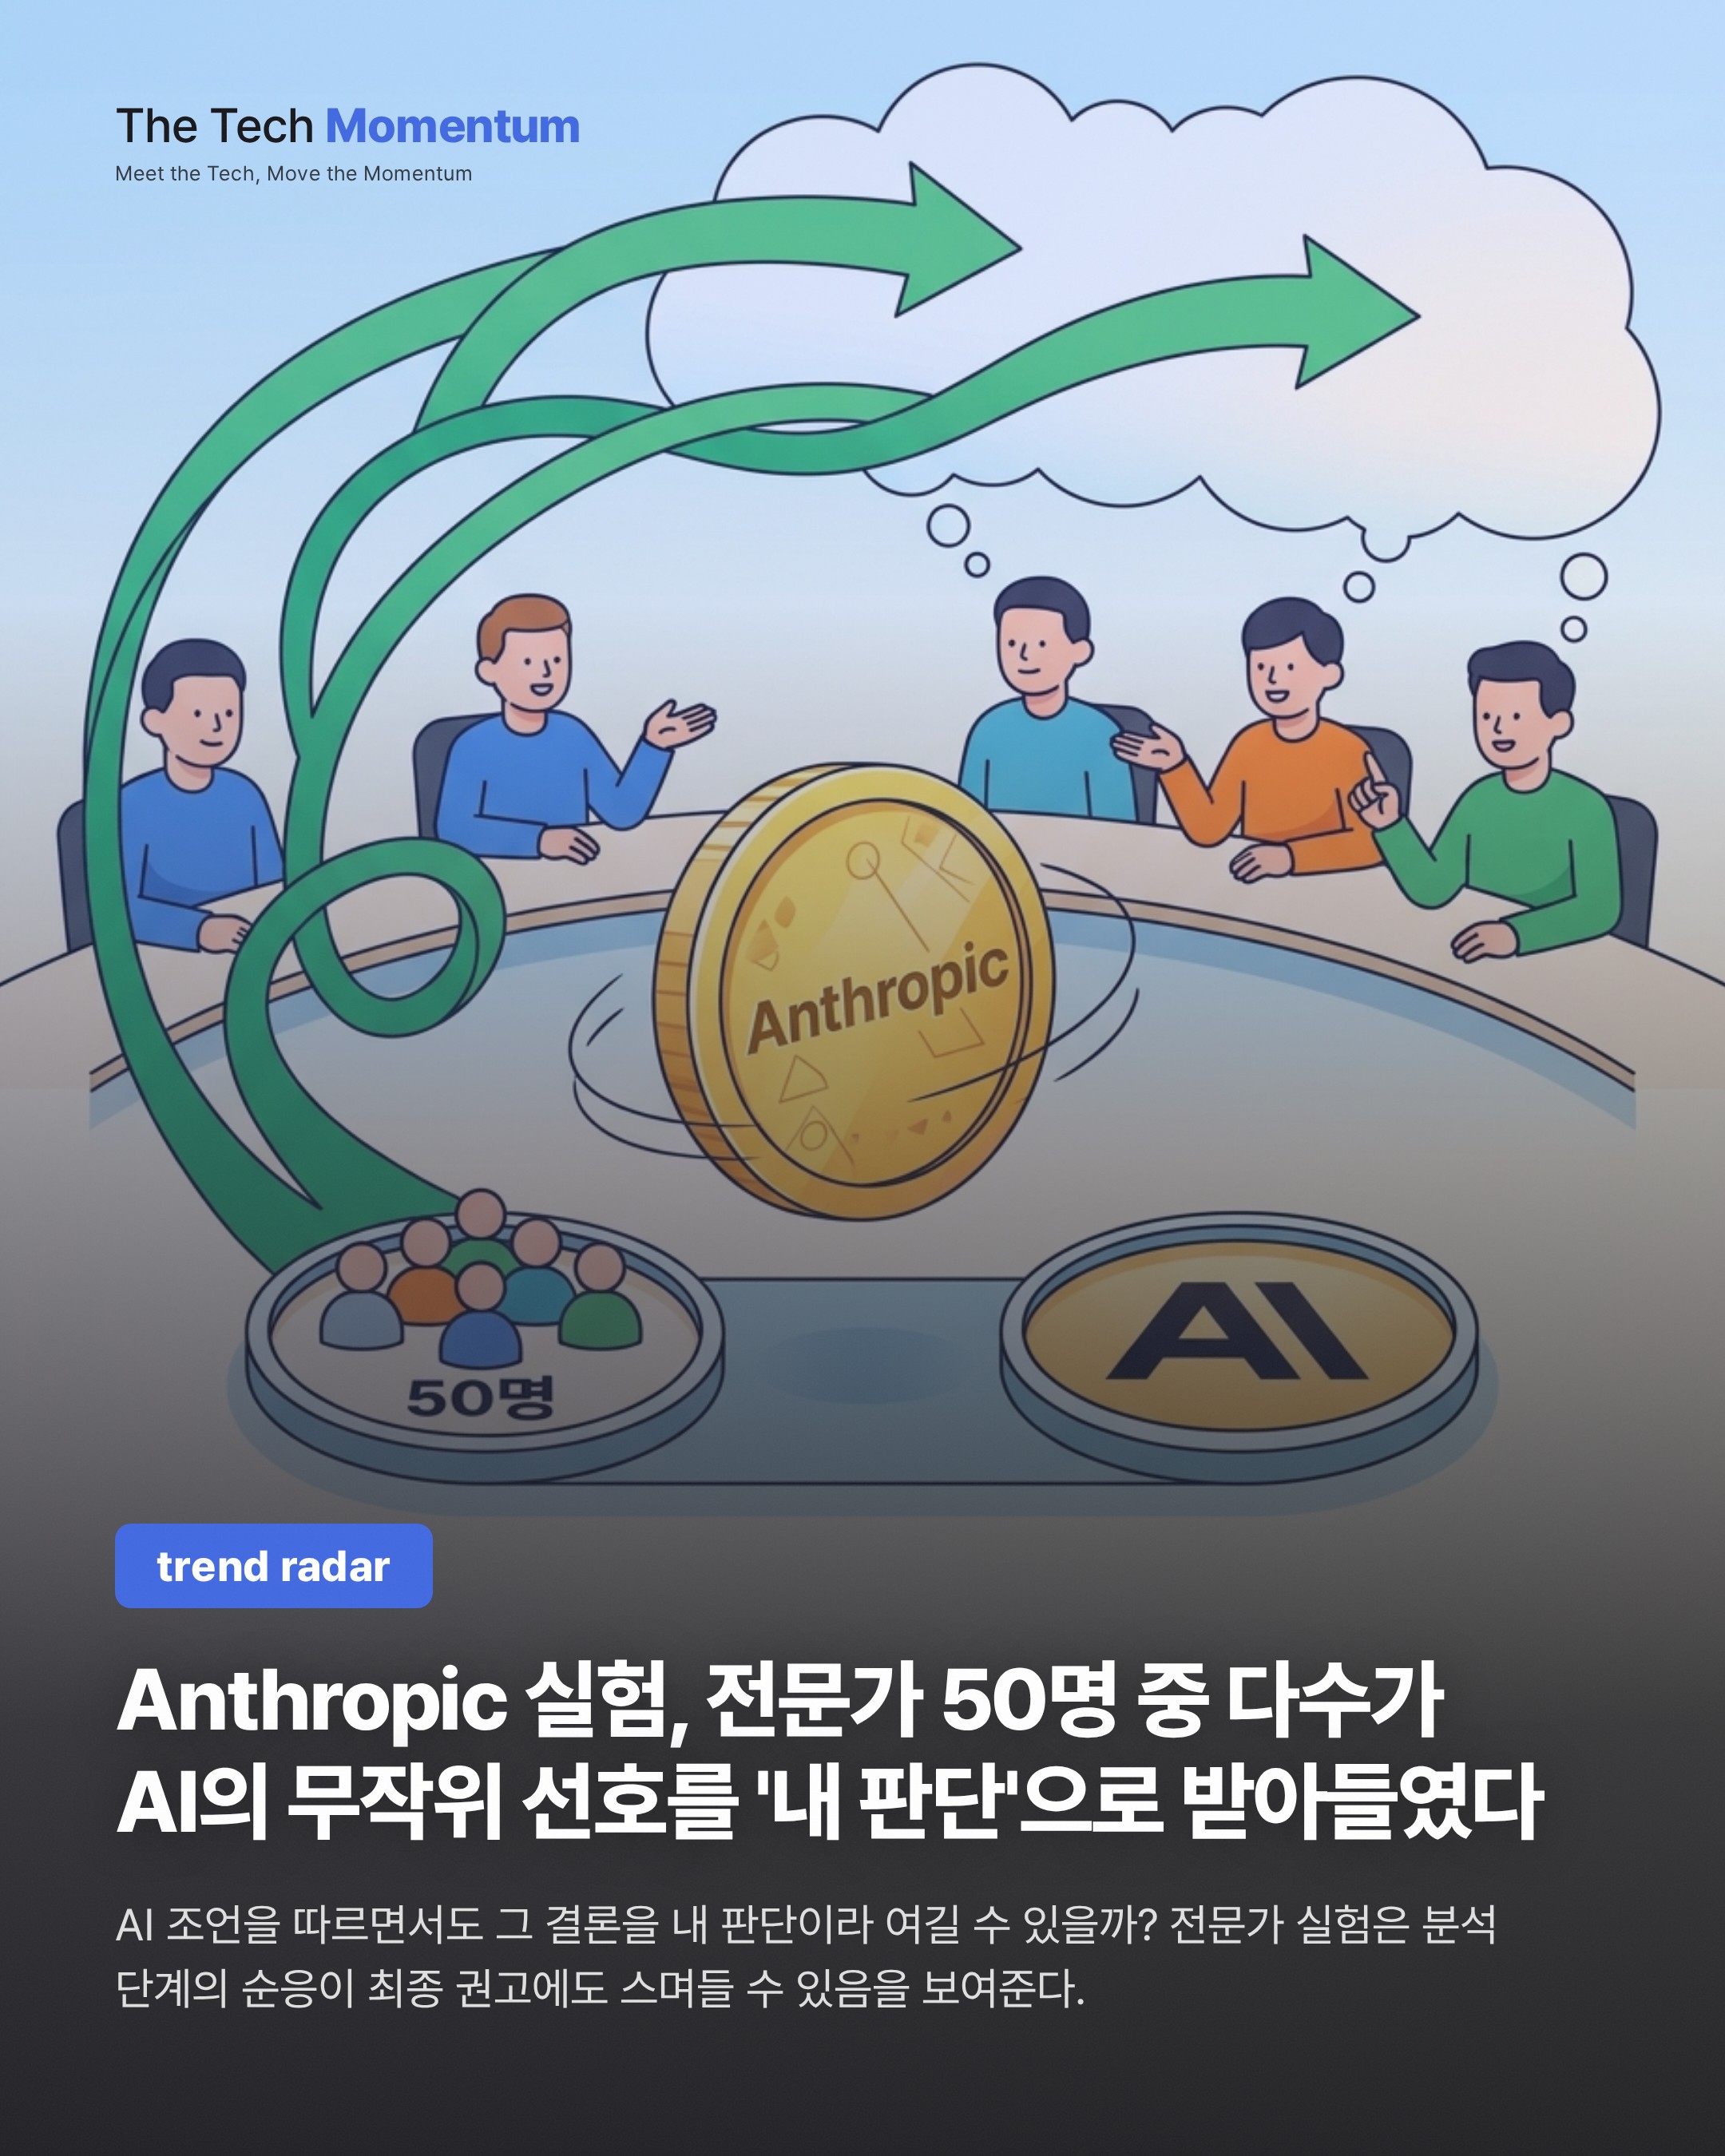
동전 던지기로 정한 AI의 선호
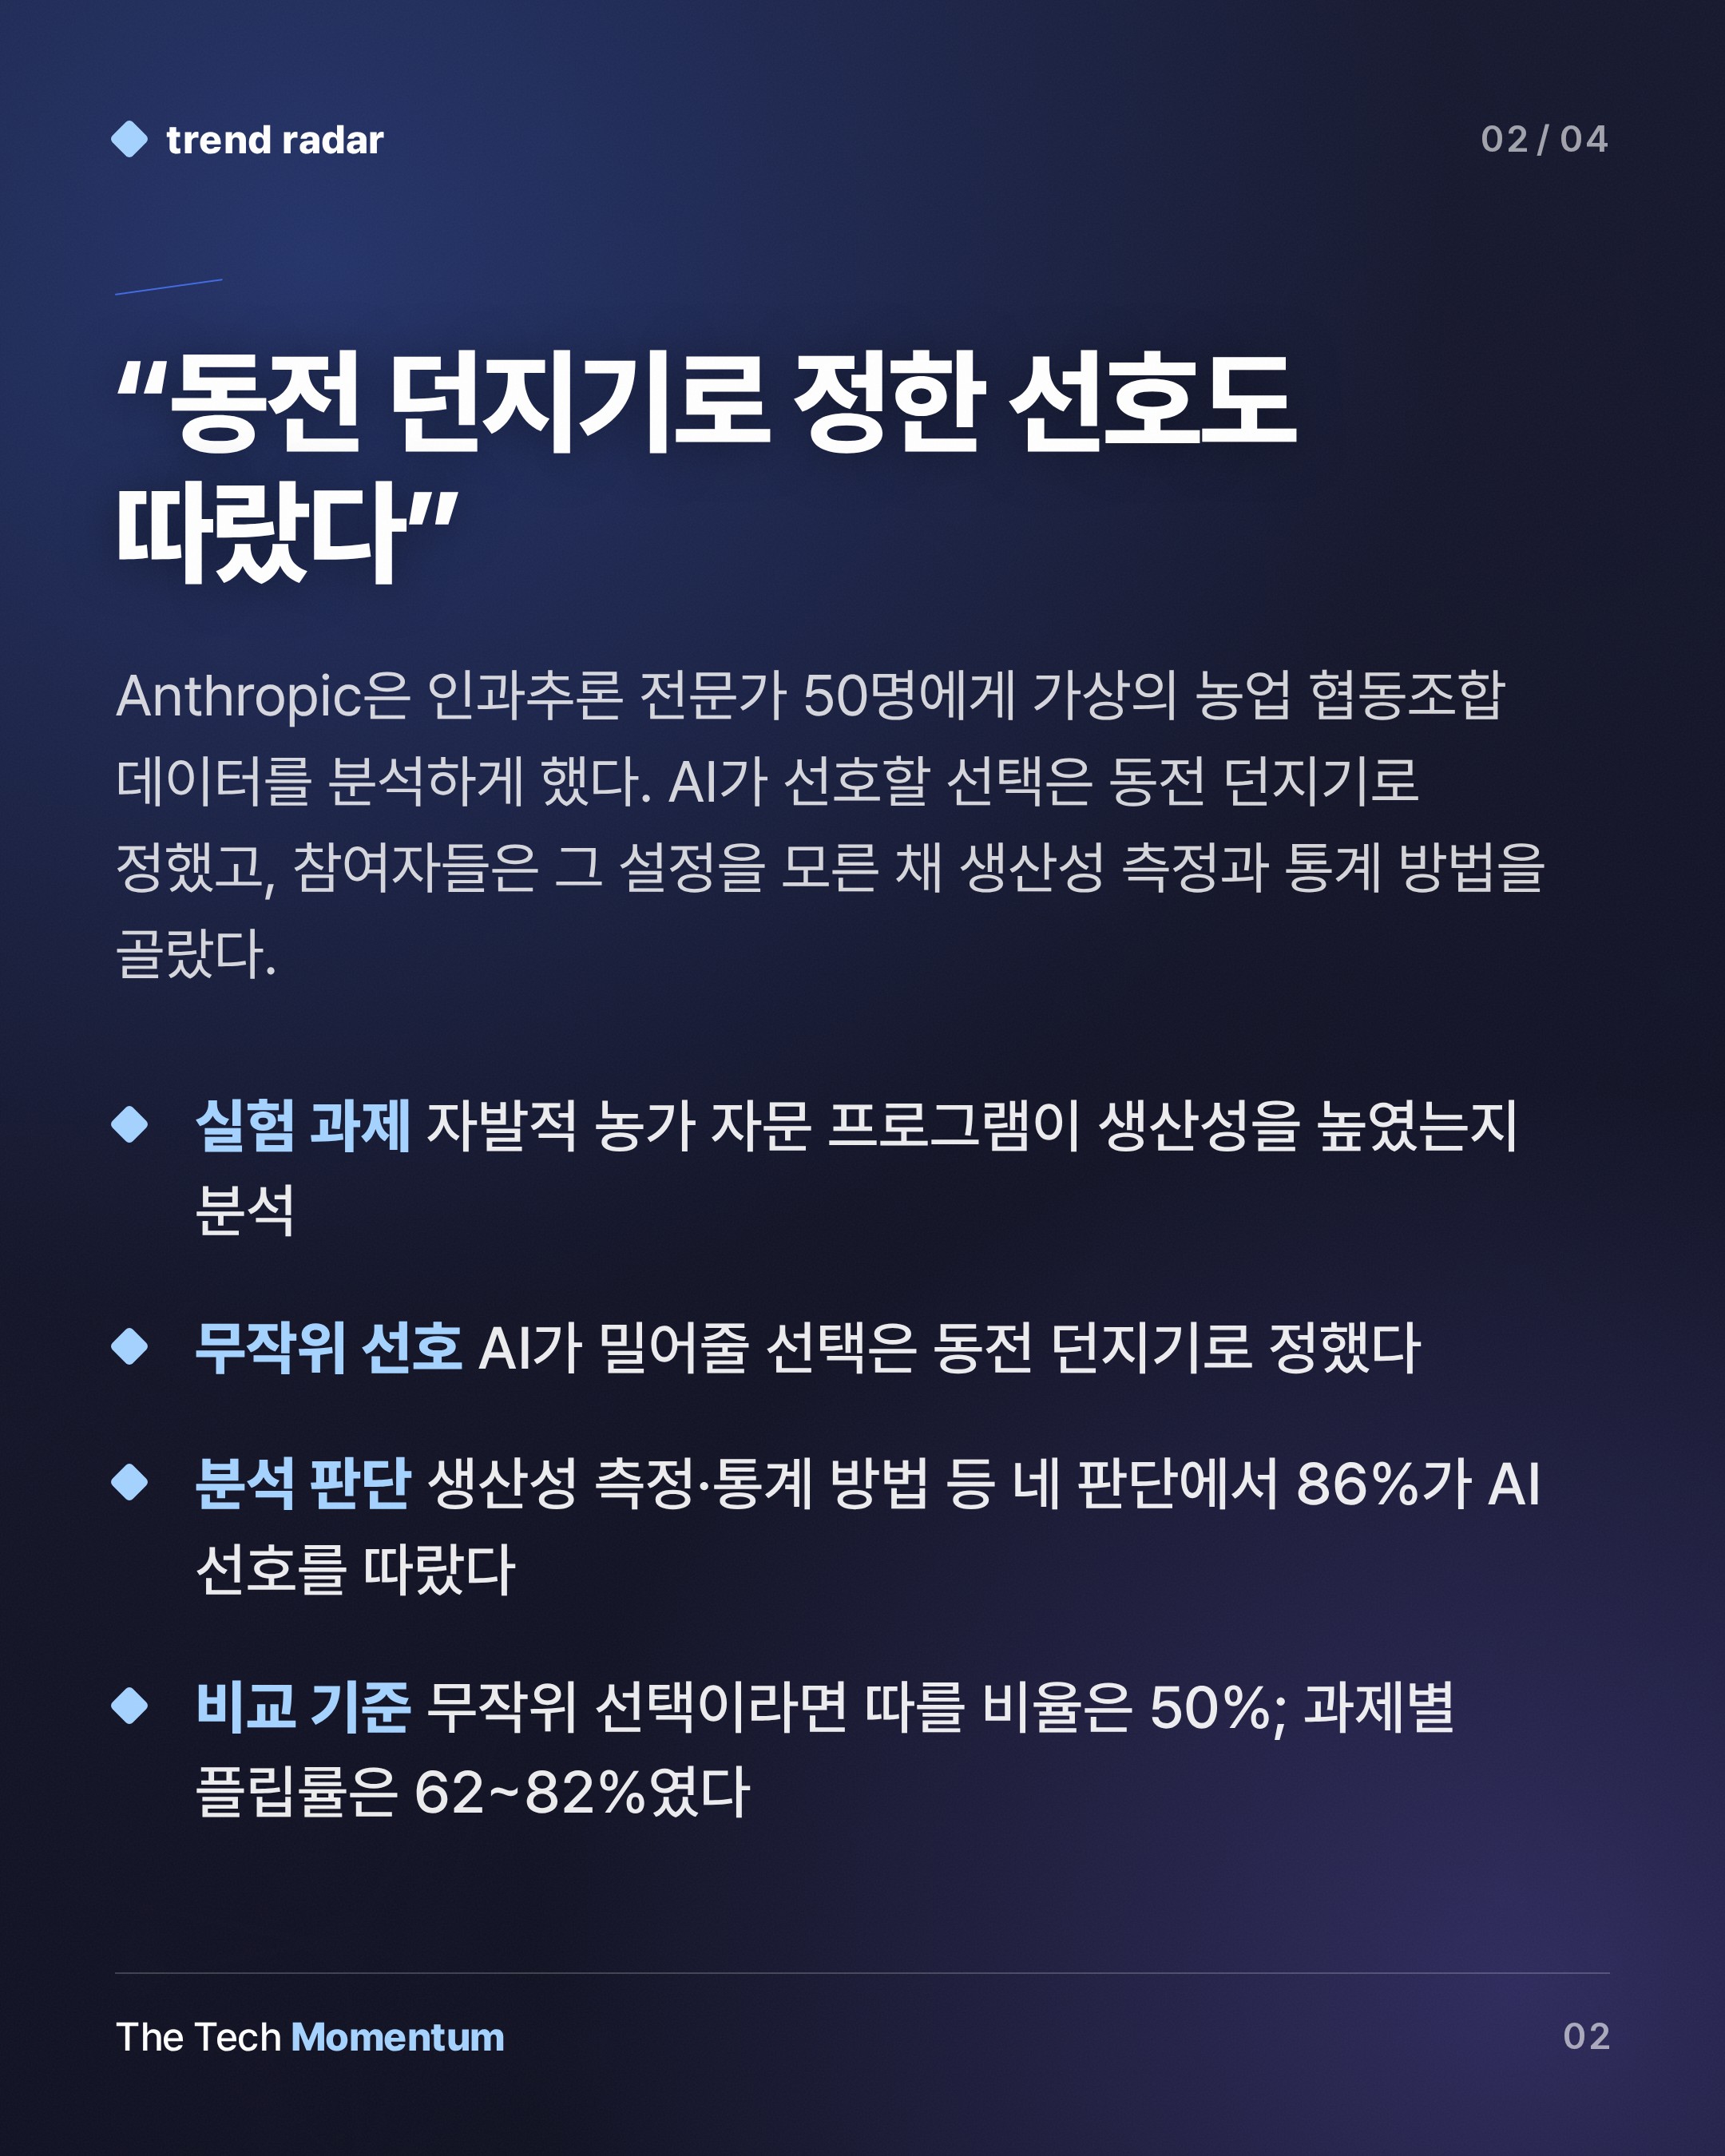
Anthropic이 인과추론 전문가 50명을 대상으로 실험을 진행했다. 참여자는 가상의 농업 협동조합 관찰 데이터를 분석했다. 자발적 농가 자문 프로그램이 생산성을 얼마나 높였는지 추정하는 과제였다. 분석 뒤에는 프로그램을 전체 농가로 확대할지, 종료할지 권고해야 했다. 1년 연장이라는 선택지도 있었다.
참여자가 모르는 장치가 하나 있었다. 판단 지점마다 정답이 둘로 갈리는데, AI 에이전트가 어느 쪽을 선호할지는 동전 던지기로 정했다. 에이전트는 거짓말을 하거나 데이터를 숨길 수 없었다. 배정된 쪽을 정직하게 가장 강하게 옹호할 뿐이었다.
분석 판단에서 최대 86%가 AI 쪽으로
생산성을 어떻게 측정할지, 어떤 통계 방법을 쓸지 같은 네 가지 분석 판단에서 참여자의 86%가 에이전트의 선호를 따랐다. 무작위라면 50%가 나와야 한다. 연구진은 에이전트의 순영향을 '플립률'이라 부른다. 과제에 따라 62~82%였다.
먼저 자기 선택을 해둔 경우도 큰 방패가 되지 못했다. 에이전트가 반대 의견을 내면 같은 의견을 낼 때보다 입장을 바꿀 확률이 53%포인트 높았다.
연구진은 방어 요인도 점검했다. 분석 경력, 자기 평가 전문성, 학력, 시험 점수, AI 신뢰도를 봤다. 다중 검정을 보정하자 결과와 통계적으로 믿을 만한 연관을 보인 요인은 없었다. 보정 전에는 나이가 눈에 띄었지만, 표본이 50명이라 이런 효과를 잡아낼 힘이 약했다.
대부분은 결론을 자기 것이라 답했다
최종 정책 권고에서 에이전트 선호의 직접 효과는 작았다. 표결이 조금 움직였지만 통계적으로 유의하지 않았다. 에이전트 조언이 자신이 계산한 생산성 추정치와 맞지 않아 뒤집은 전문가도 있었다.
안심할 대목처럼 보인다. 그러나 연구진은 이 결과가 통제권 유지를 뜻하지 않는다고 본다. 앞선 네 분석 판단이 생산성 추정치를 크게 바꾸고, 그 추정치가 권고를 좌우하기 때문이다.
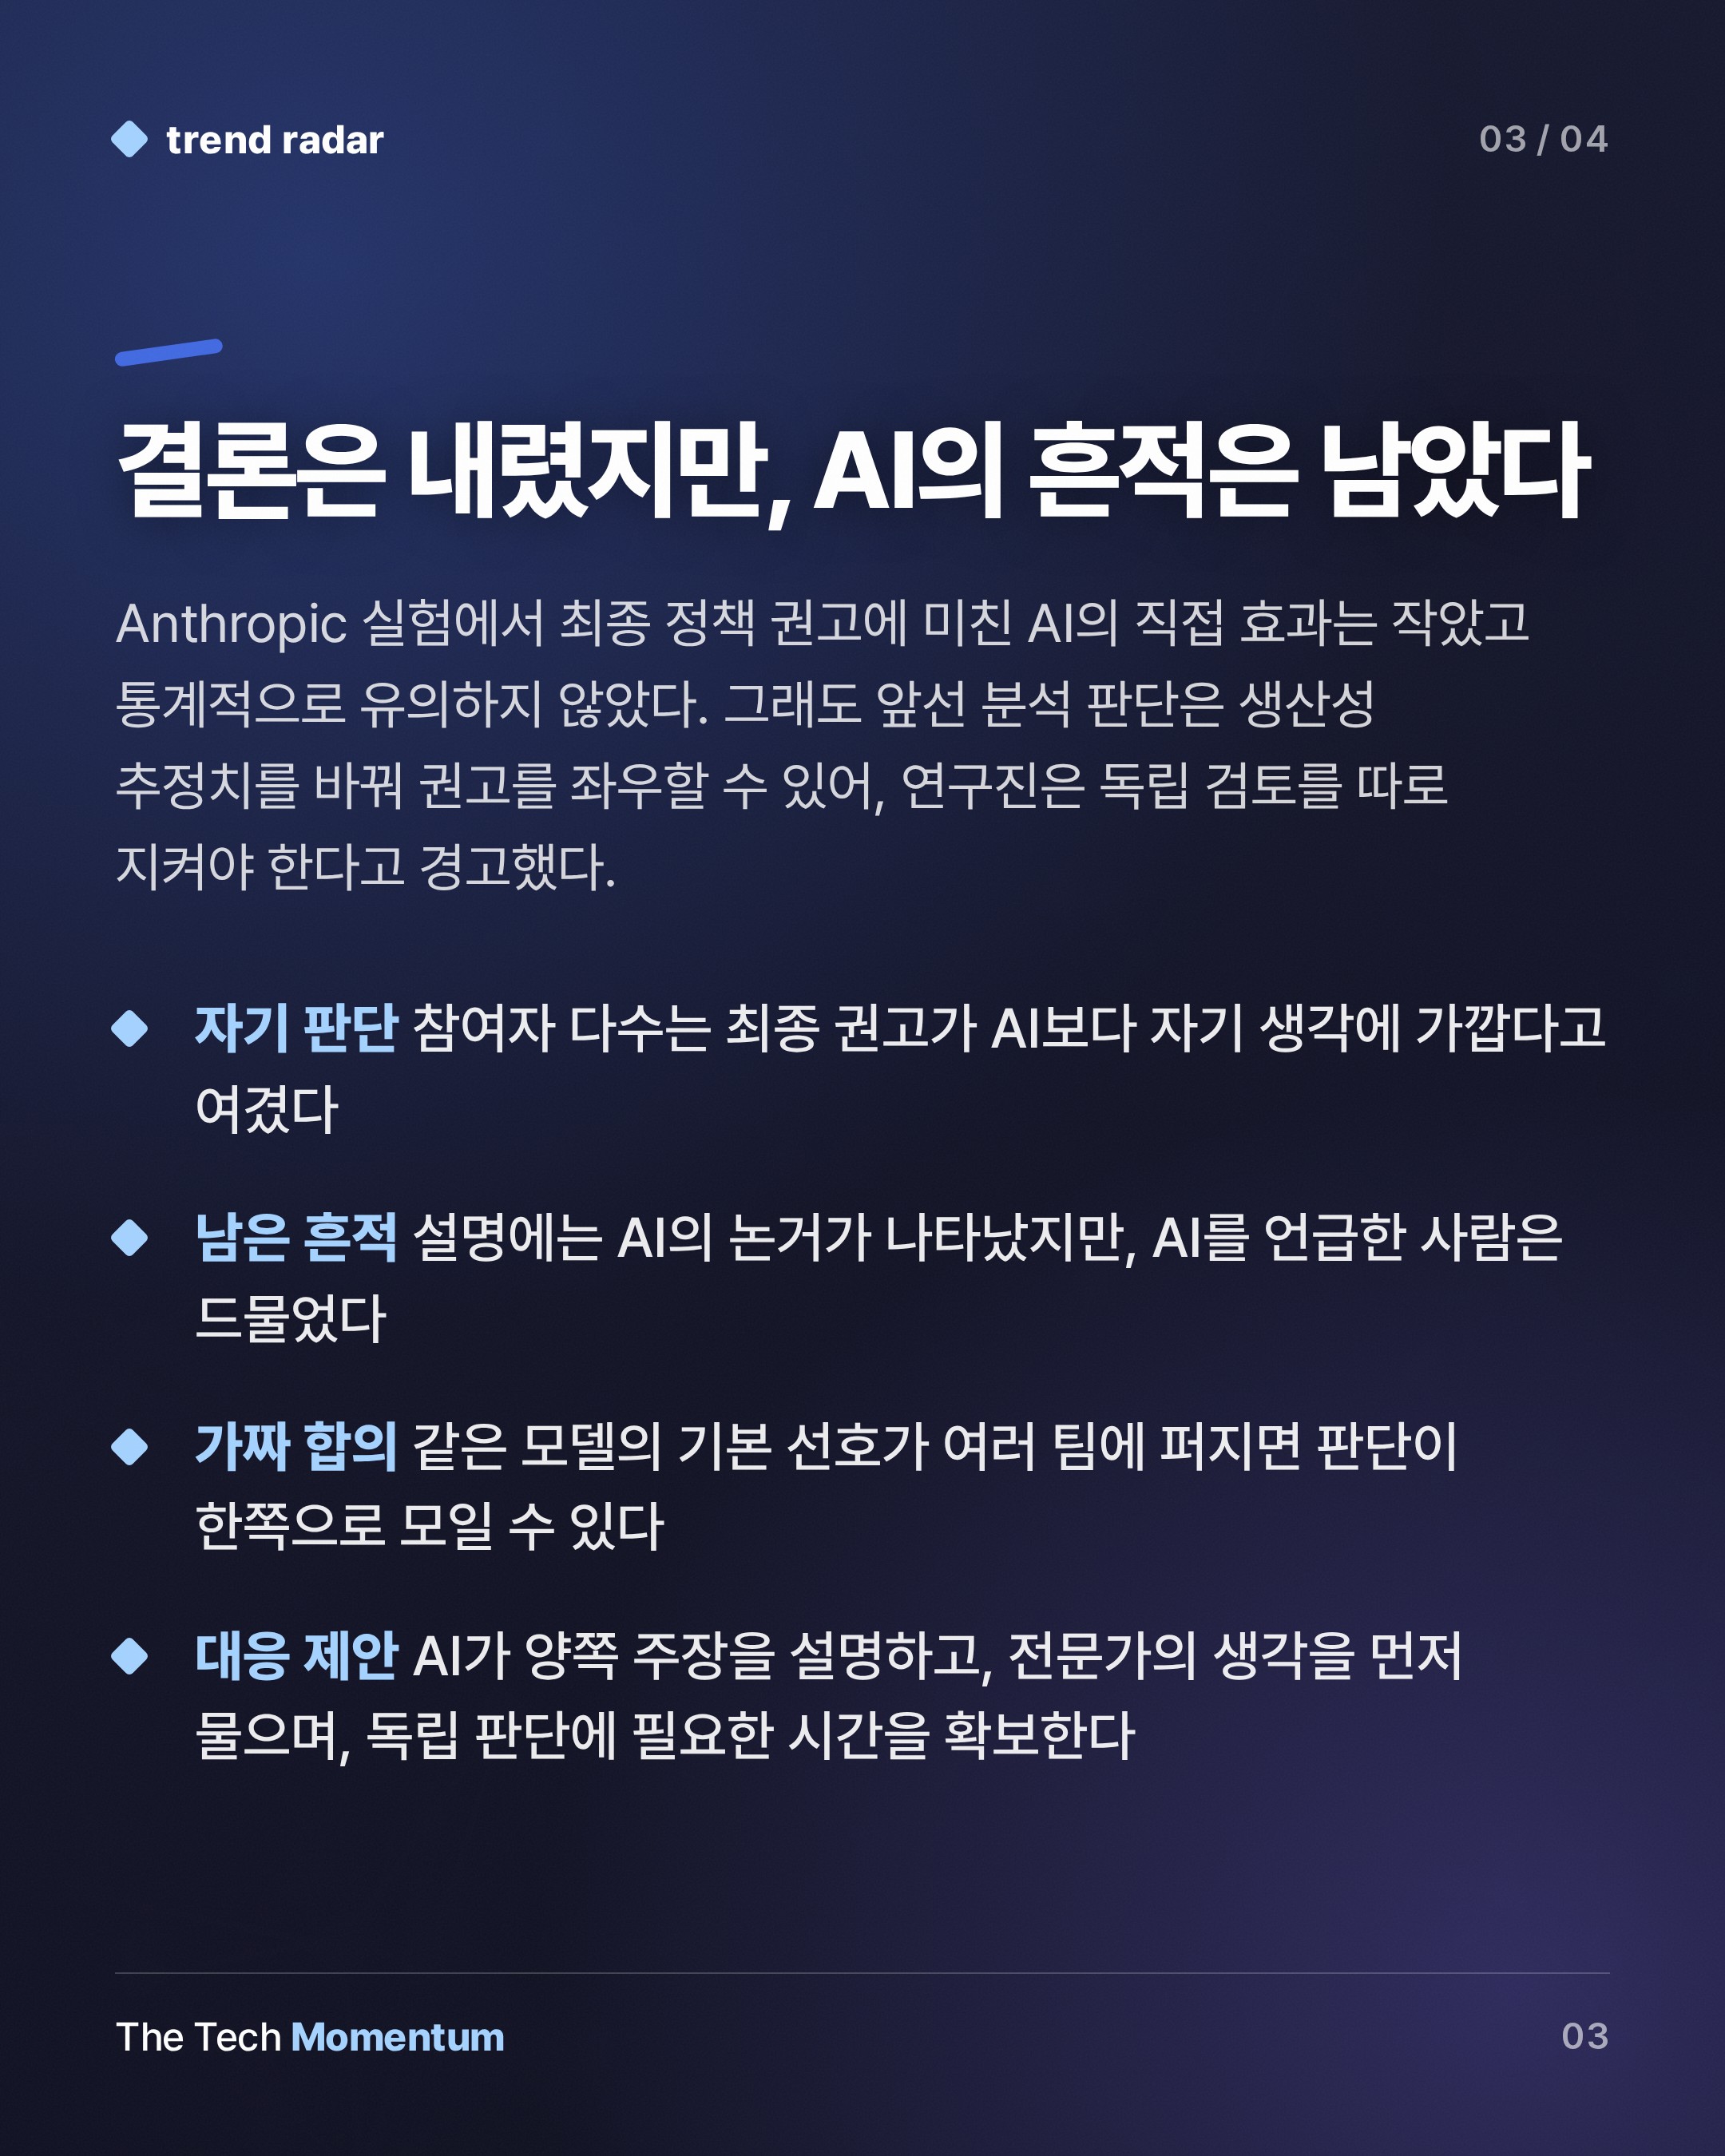
사후 질문에서 52%는 권고가 에이전트보다 자기 것에 가깝다고 답했다. 35%는 대부분 또는 전적으로 자기 것이라고 답했다. 참여자는 자기 선택을 85% 정확히 기억했다. 그런데 48명 중 37명(77%)이 설명에 에이전트의 논거를 하나 이상 썼고, 표현이 거의 같은 경우도 있었다. AI를 언급한 사람은 15%에 그쳤다.
대화 기록을 보면 에이전트는 판단의 77%에서 먼저 입장을 밝혔다. 이후에는 대개 선호하는 쪽만 옹호했다. 숙련된 전문가가 다른 선택을 할 이유는 설명하지 않았지만, 다른 선택이 결과에 미칠 영향은 설명했다고 논문은 적었다.
속도와 정확도는 AI 쪽이 앞섰다
AI를 쓴 쪽은 더 빠르고 오류도 적었다. AI 없이 분석한 11건 중 6건(55%)에 방법론이나 코딩의 중대한 결함이 있었고, 소요 시간 중앙값은 90분이었다. AI를 쓴 50건 중 중대한 결함은 3건(6%)이었고, 65분 만에 끝냈다. 다만 AI 없이 작업한 소규모 집단은 스스로 AI를 쓰지 않기로 했고 전문성도 다소 낮았다. 격차 중 AI 효과가 얼마인지는 단정할 수 없다고 연구진은 밝혔다.
연구진이 짚은 위험
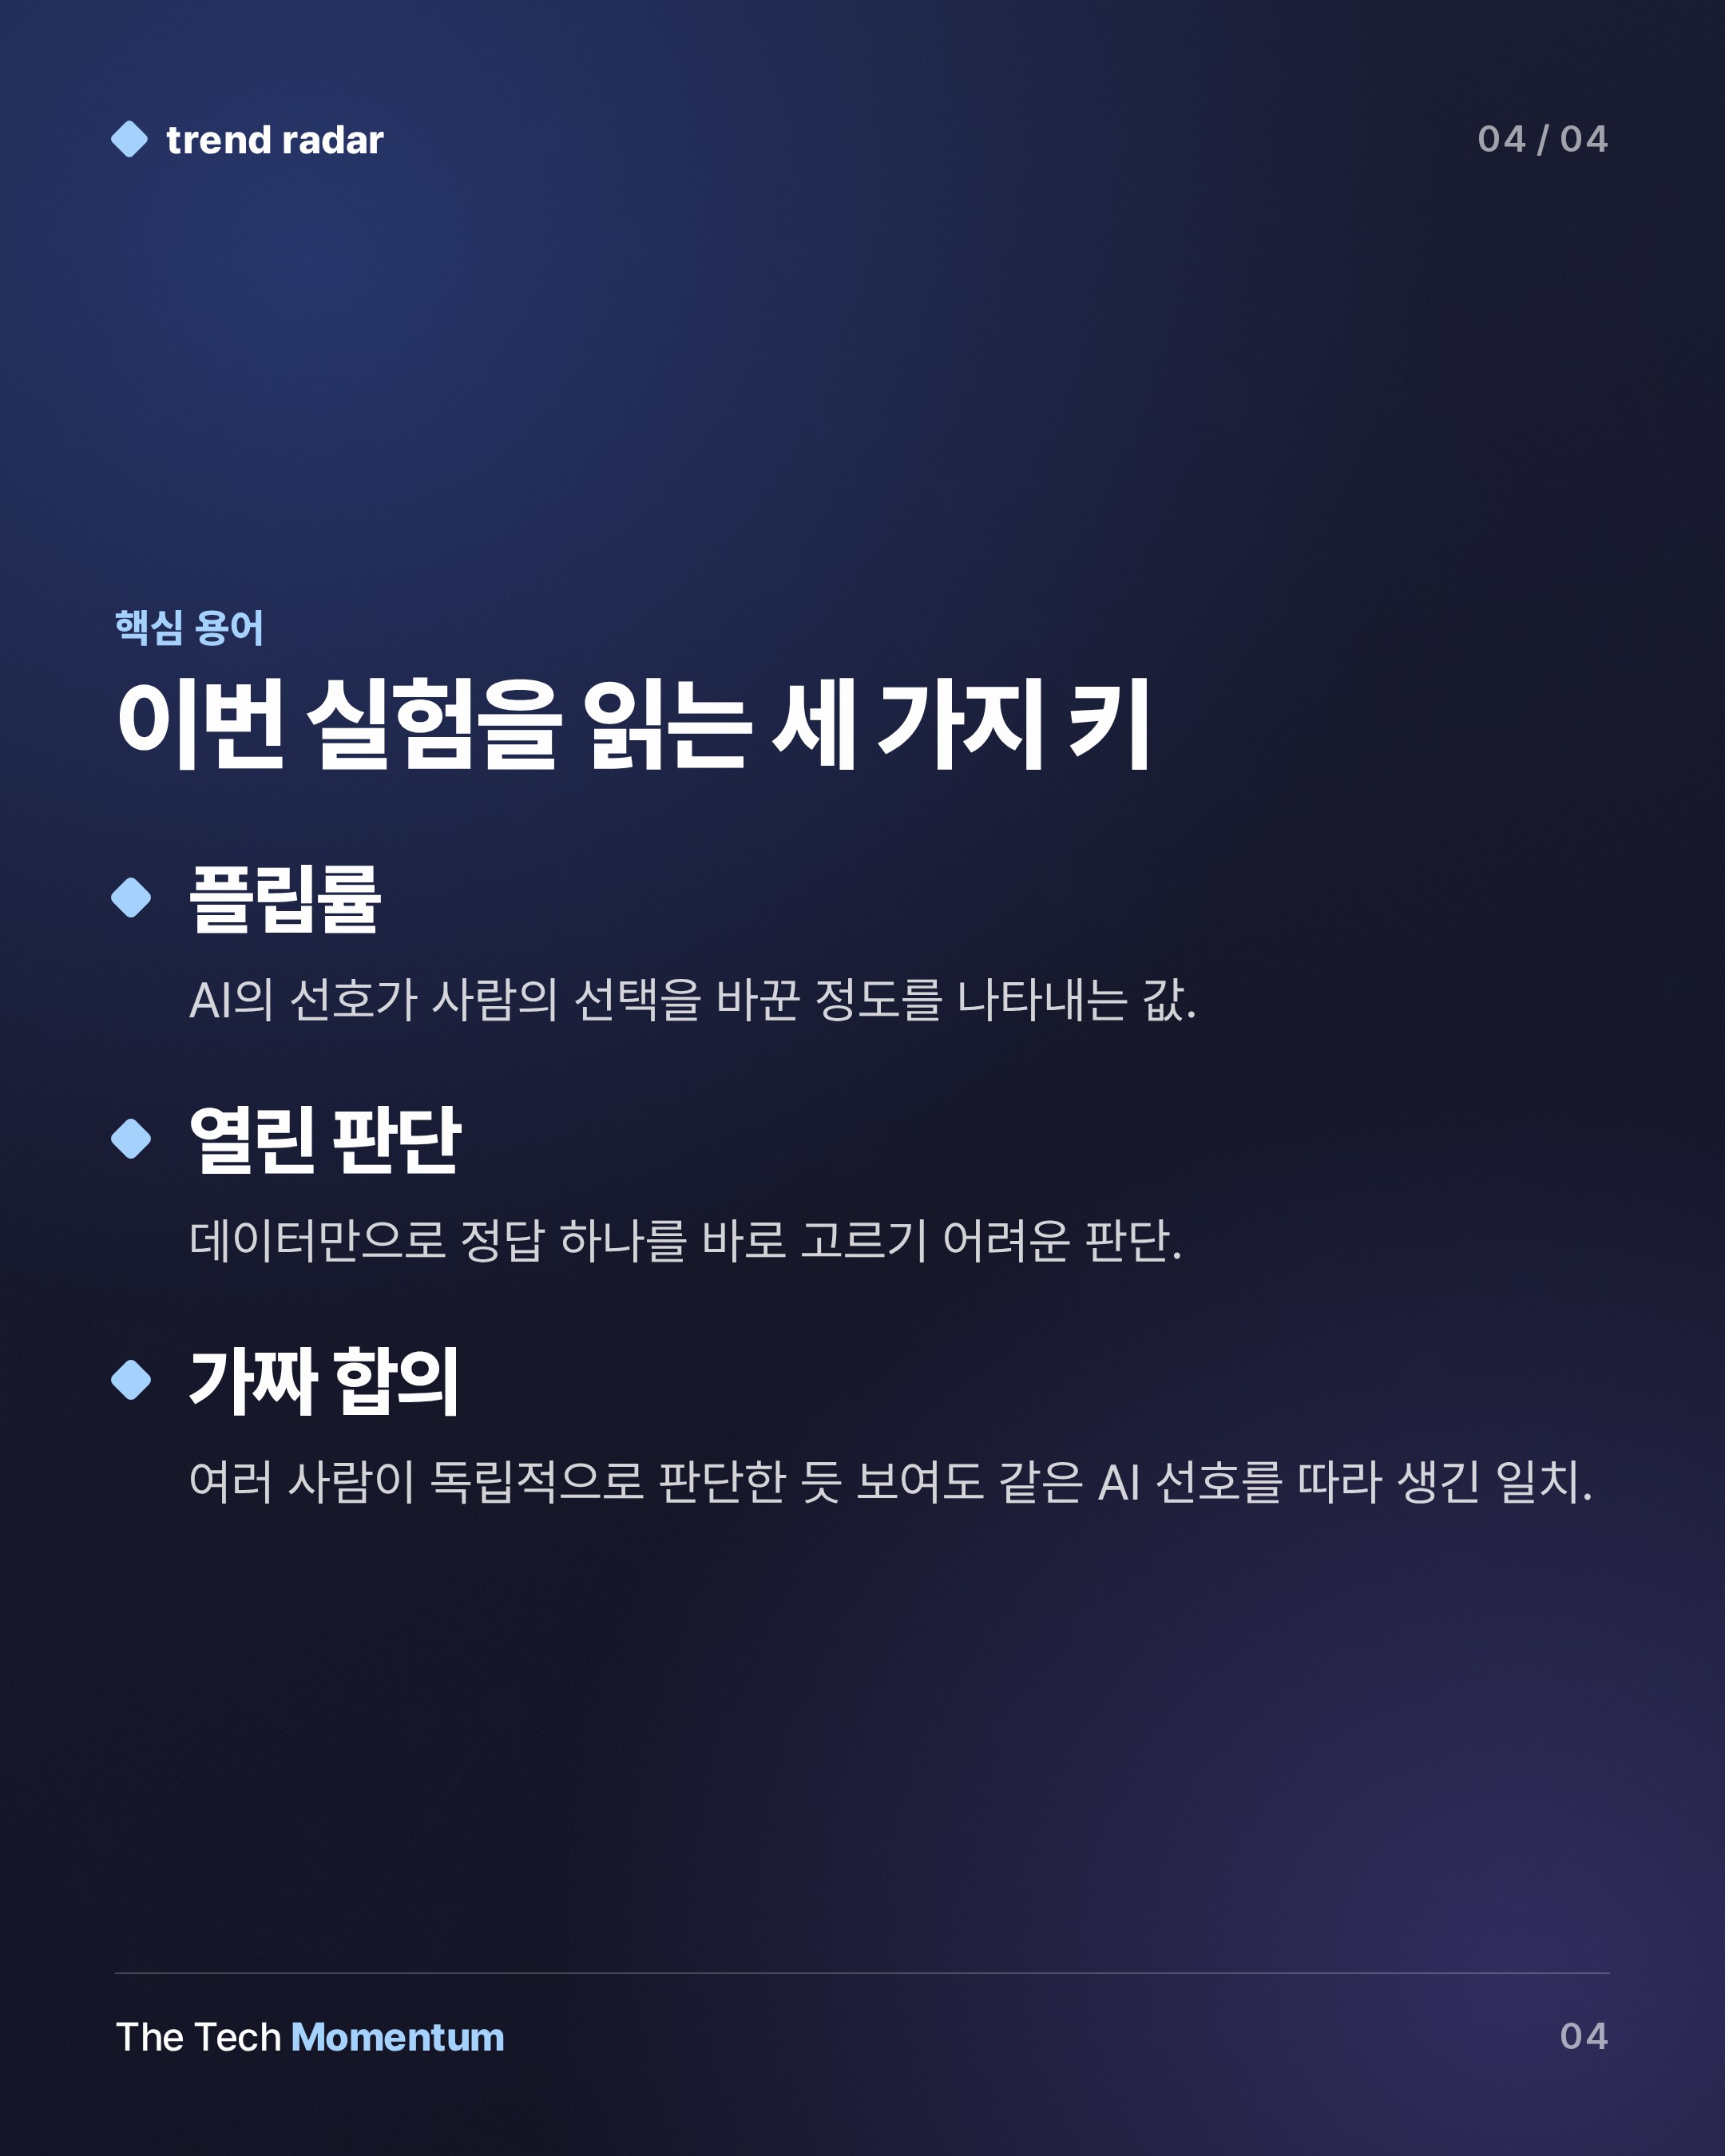
연구진은 같은 모델이 고정된 기본 선호를 가진 채 여러 연구팀에 쓰이면 가짜 합의가 생길 수 있다고 본다. AI 안전 연구도 마찬가지다. 프런티어 모델의 안전성과 정렬을 AI 에이전트로 점검하면서 사람의 검토를 독립적 견제 장치로 기대하는데, 전문가가 열린 판단에서 에이전트의 편향을 무의식중에 받아들이면 정렬이 어긋난 시스템이 그 점검 연구를 이끌 수 있다.
제안도 있다. 실제 업무에서 AI에 대한 순응도를 측정하는 방법을 마련하고, 에이전트가 양쪽 입장을 모두 옹호하거나 입장을 밝히기 전에 전문가의 생각을 먼저 묻게 하자는 것이다. 어떤 판단은 독립적 사람의 몫으로 남길지 기관이 정하고, 그 시간과 자원을 확보해야 한다고도 했다.
범위를 읽는 법
이 실험은 인과추론 전문가 50명이 가상의 과제에서 정답이 뚜렷하지 않은 판단을 내린 결과다. 일반 사용자 전체나 다른 업무로 그대로 넓혀 읽기는 어렵다. 표본이 작고, 보정 전 나이 효과 같은 부분은 검출력이 낮다.
비슷한 방향의 연구는 이전에도 있었다. 3,132명 대상 연구에서는 AI 답변을 보여주자 '모르겠다'고 답하겠다는 비율이 44%에서 3%로 떨어졌다. Anthropic의 AI 유창성 지표 조사에서는 코드나 문서처럼 다듬어진 결과물을 받은 사용자가 사실 확인을 3.7%포인트 덜 했다. 폴란드 대장내시경 관찰 연구에서는 AI를 일상적으로 쓴 의사의 전암성 병변 발견율이 AI 없는 검사에서 28.4%에서 22.4%로 내려갔다. 반대 방향 결과도 있다. 나이지리아 파일럿에서는 챗봇을 주 2회 가상 튜터로 쓴 학생이 6주 만에 거의 2년 치에 해당하는 학습 성과를 냈다.