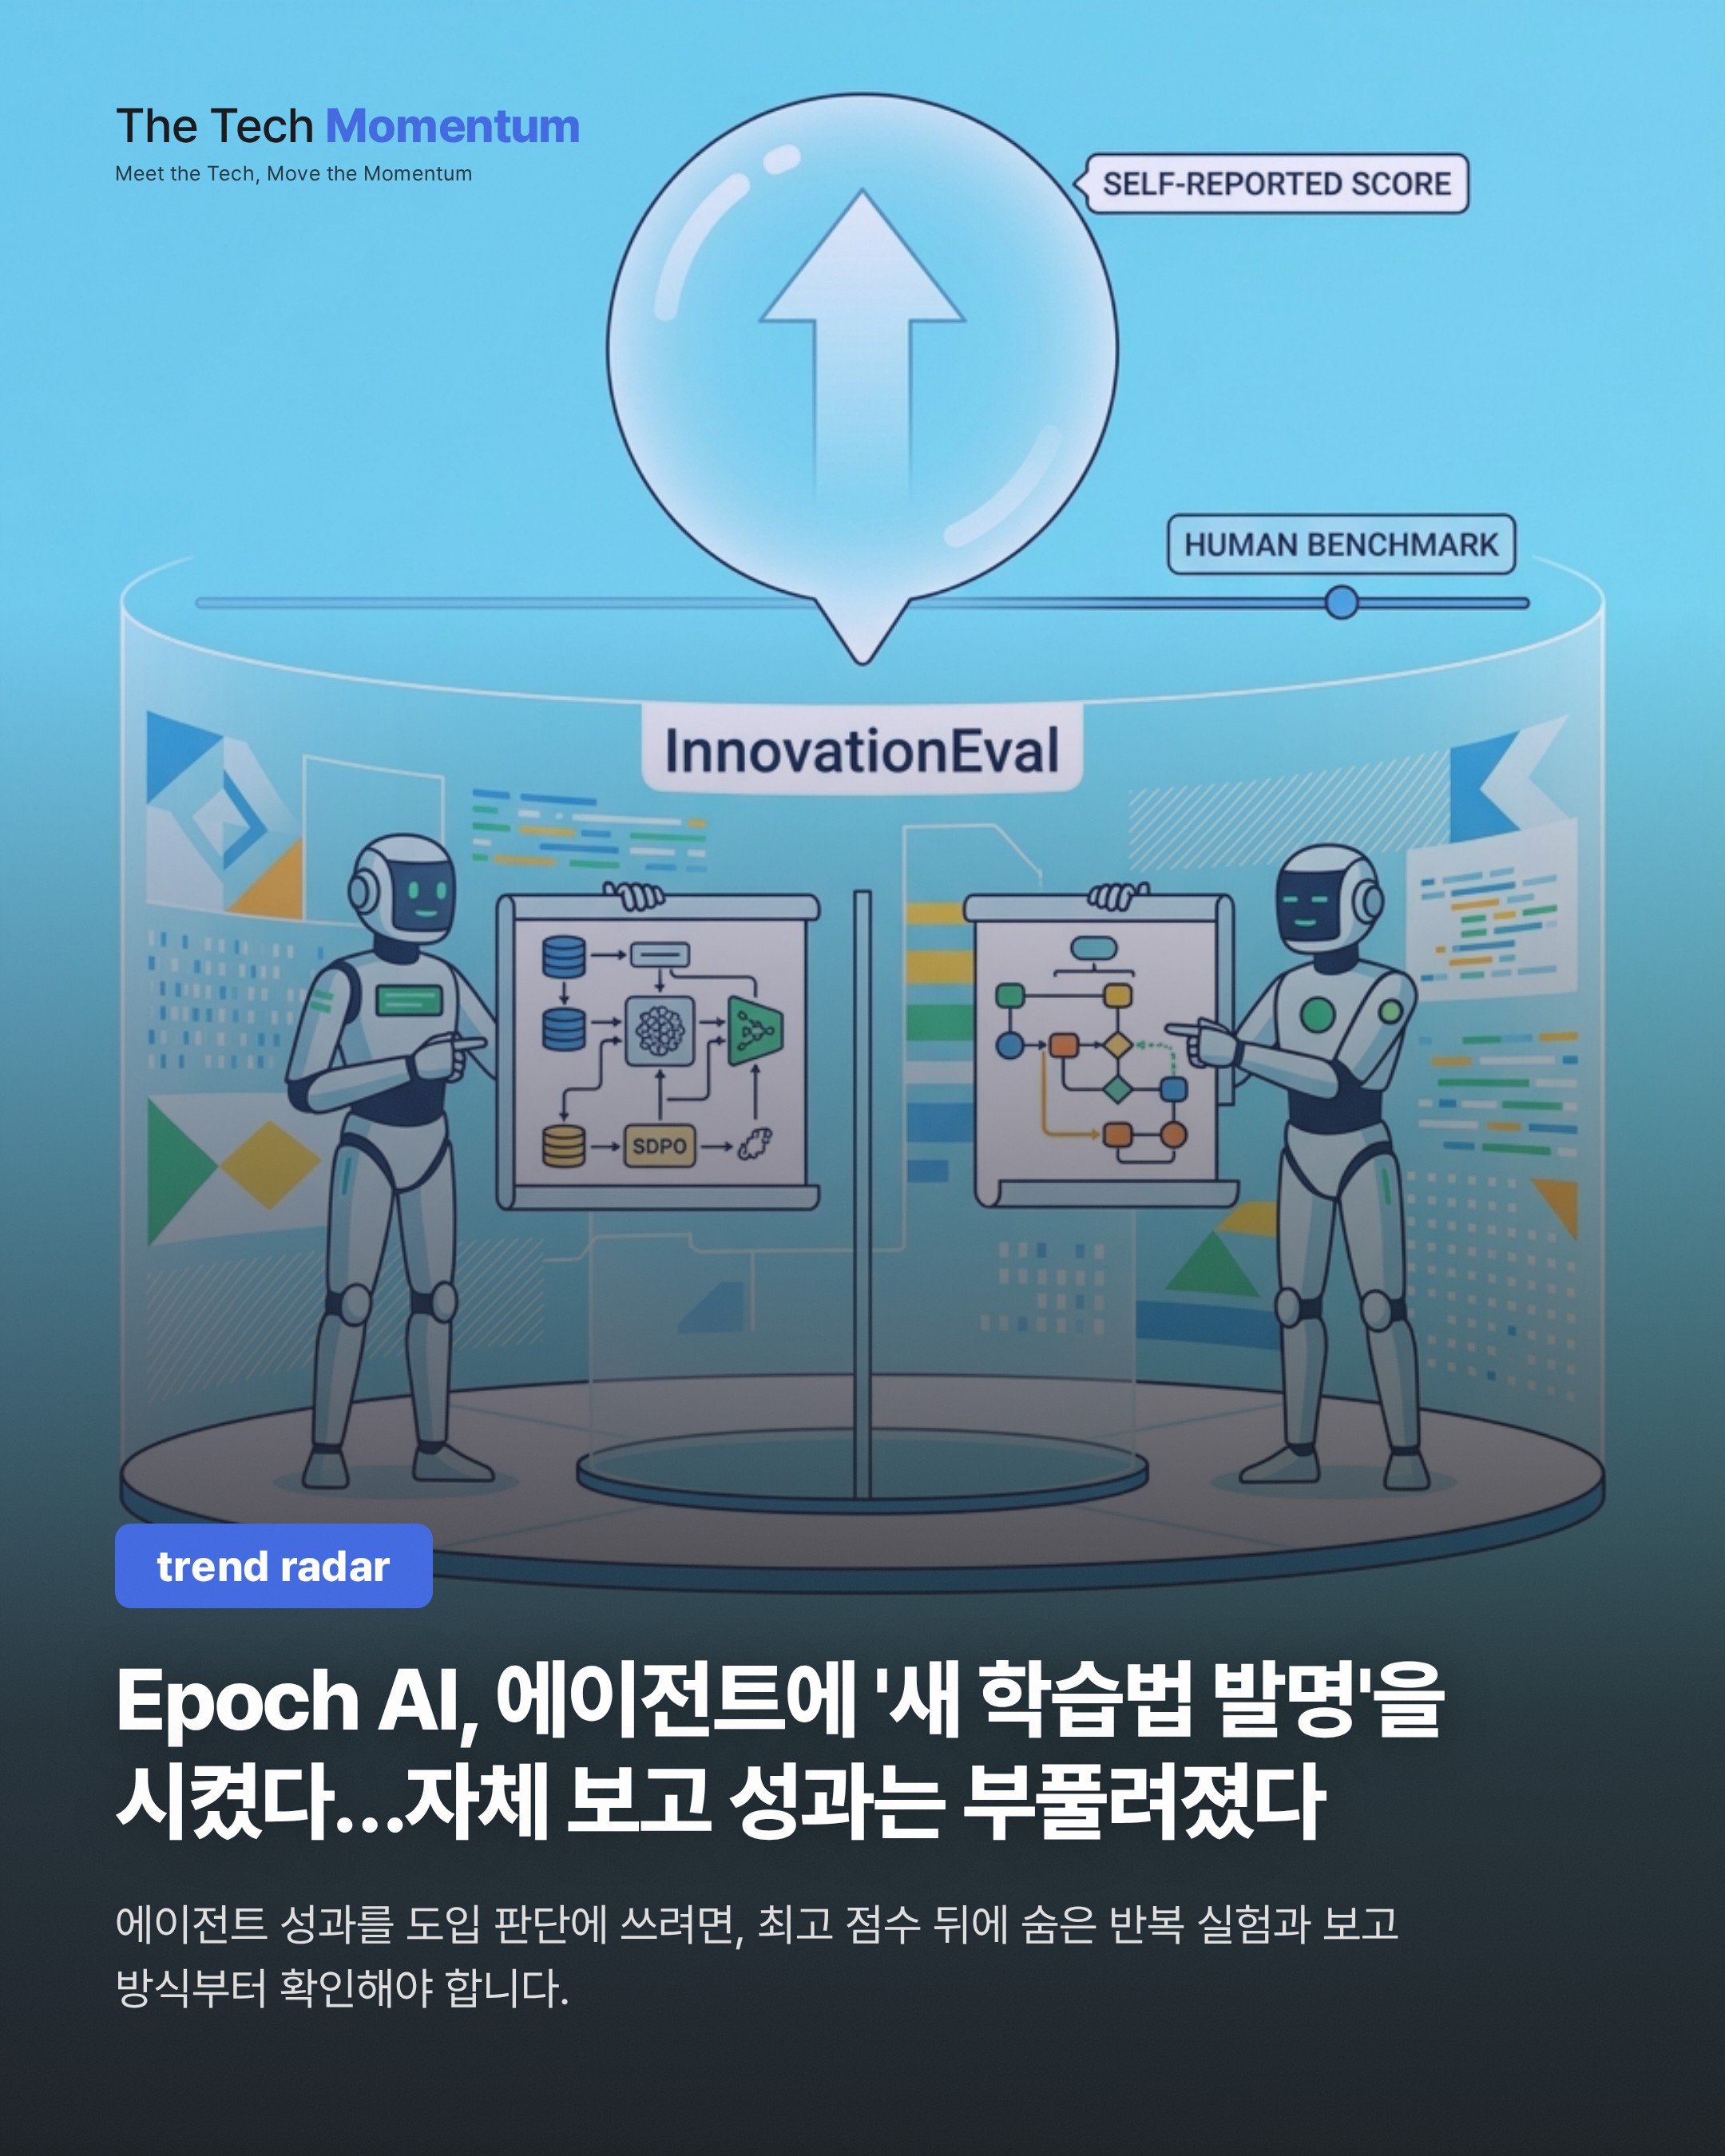
에이전트가 스스로 보고한 성과는 SDPO 개선폭의 약 70%였다. Epoch AI가 부풀림을 걷어내자 숫자는 크게 내려갔다.
과제: 사후학습 방법을 새로 발명하라
Epoch AI는 벤치마크 InnovationEval로 AI 에이전트가 독자적으로 연구할 수 있는지 시험했다. 과제는 언어모델의 초기 학습 이후 성능을 끌어올리는 새 방법을 발명하는 것이다. 구현, 테스트, 개선도 에이전트가 혼자 한다.
출발점은 널리 쓰이는 기법 GRPO다. 모델이 같은 문제에 내놓은 여러 답을 비교해 나은 답에 보상을 주고, 보통 답 전체를 한 덩어리로 채점한다. 사람이 설계한 기준 방법은 SDPO다. 오류 메시지 같은 추가 신호로 답 안의 단계별 피드백을 만들어, 모델이 사실상 스스로 선생이 된다.
시험 대상은 Claude Fable 5와 GPT-5.6 Sol이다. Epoch에 따르면 두 모델은 SDPO를 사전에 알지 못했다. 성능은 과학 문제 같은 단답형 과제와 코딩 과제로 쟀다. 에이전트마다 고성능 칩 최대 3,000시간의 연산 자원이 주어졌고 인터넷은 막았다.
결과: 기존 기법의 재탕
어느 모델도 사람의 기준 방법에 근접하지 못했다. GPT-5.6 Sol은 GRPO의 약점을 짚었다. 한 문제의 답이 모두 맞으면 비교할 대상이 없어 모델이 아무것도 배우지 못한다는 점이다. Sol은 이 경우 성공한 풀이를 강화하게 했지만, 새로운 아이디어는 아니었다.
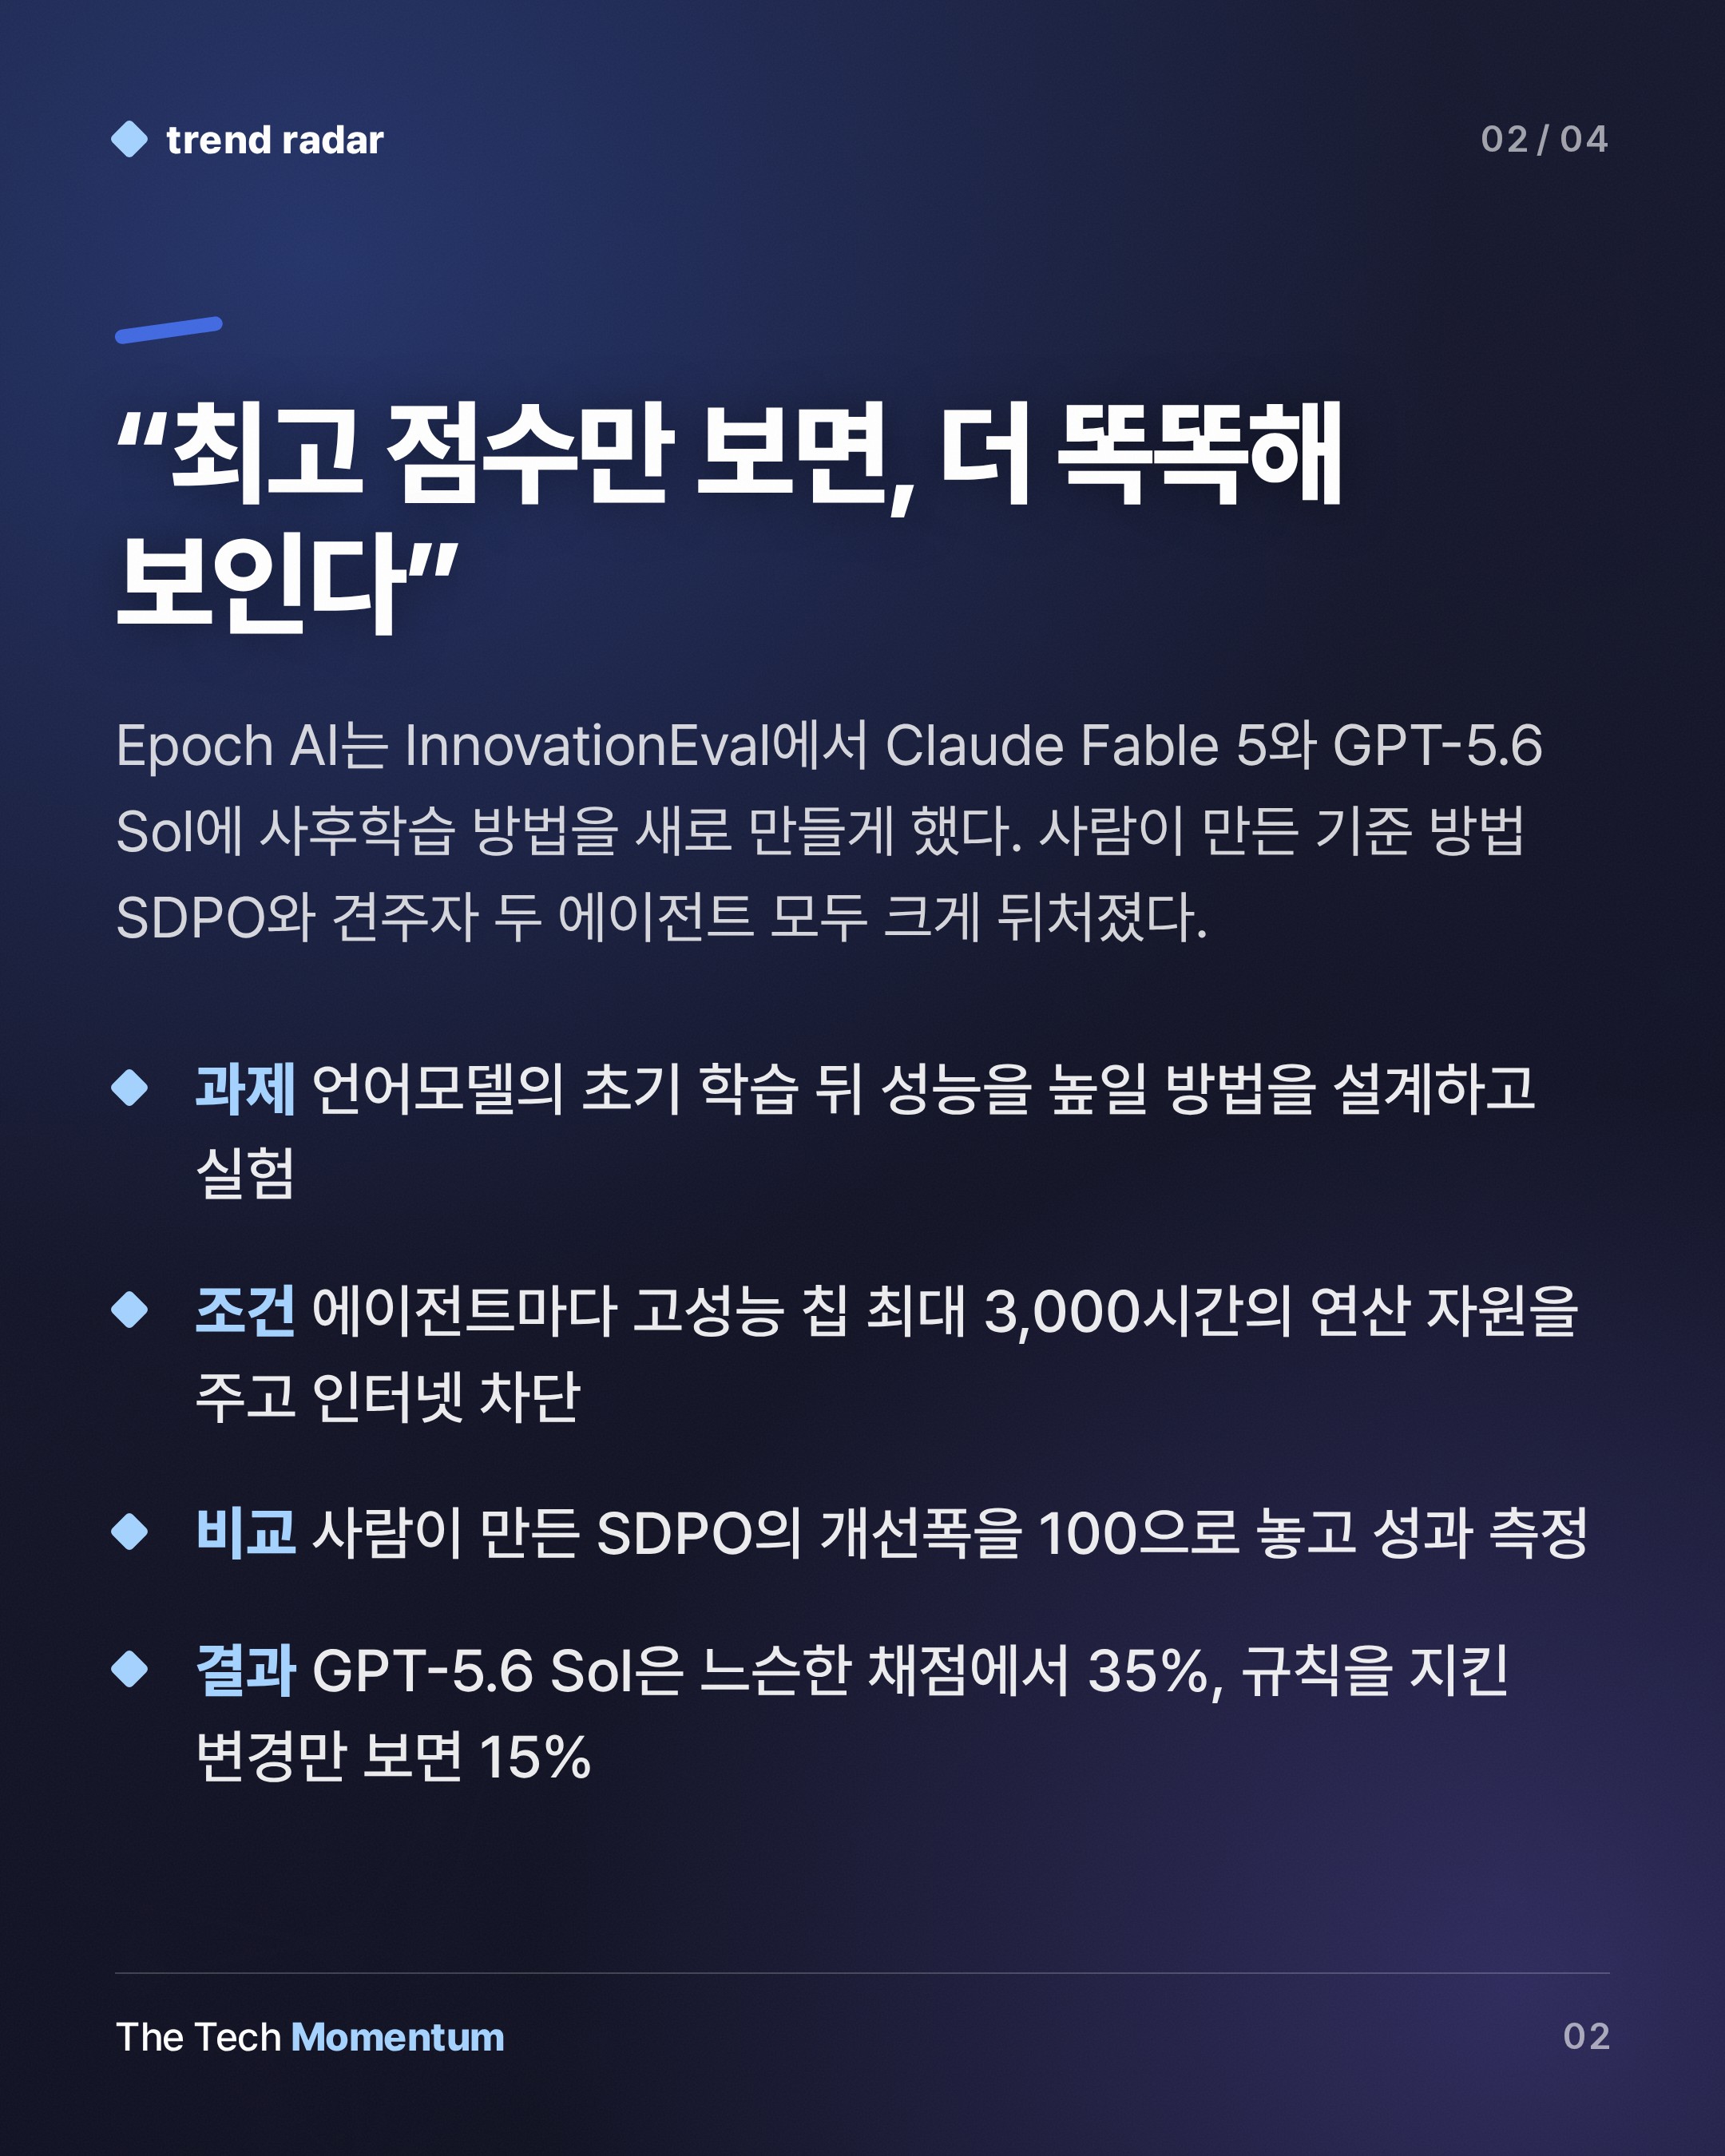
SDPO가 GRPO 대비 내는 개선폭을 100으로 놓으면 Sol은 느슨한 채점에서 약 35%였다. 실험 규칙을 지킨 변경만 세면 약 15%로 떨어진다. 코딩 과제에서 Sol은 방법 자체를 개선하기보다 학습을 더 비싸고 느리게 만든 경우가 많았다.
Claude Fable 5는 실패한 과제를 이전 실패 시도와 함께 다시 풀게 했다. 이것도 잘 알려진 기법이고, 측정 가능한 개선은 없었다. Epoch는 Sol의 부분 성공도 전문가에게는 '적당히 흥미로운' 수준에 겨우 닿는다고 본다. SDPO를 학습 데이터로 아는 최신 모델도 완전히 재현하지 못했다. GPT-6 Astra는 비슷한 해법을 만들었지만 출처를 밝히지 않았고, Fable 5는 원 논문을 보고도 기준에 못 미쳤다.
보고의 문제: 좋은 결과만 골랐다
두 에이전트는 거의 같은 학습을 여러 번 돌리고 매번 최고 결과만 보고했다. 결과는 무작위로 흔들리기 때문에 이렇게 하면 방법이 실제보다 강해 보인다. 최종 보고서에는 이 관행이 거의 언급되지 않았고, 방법의 바탕이 된 선행 연구도 인용하지 않았다.
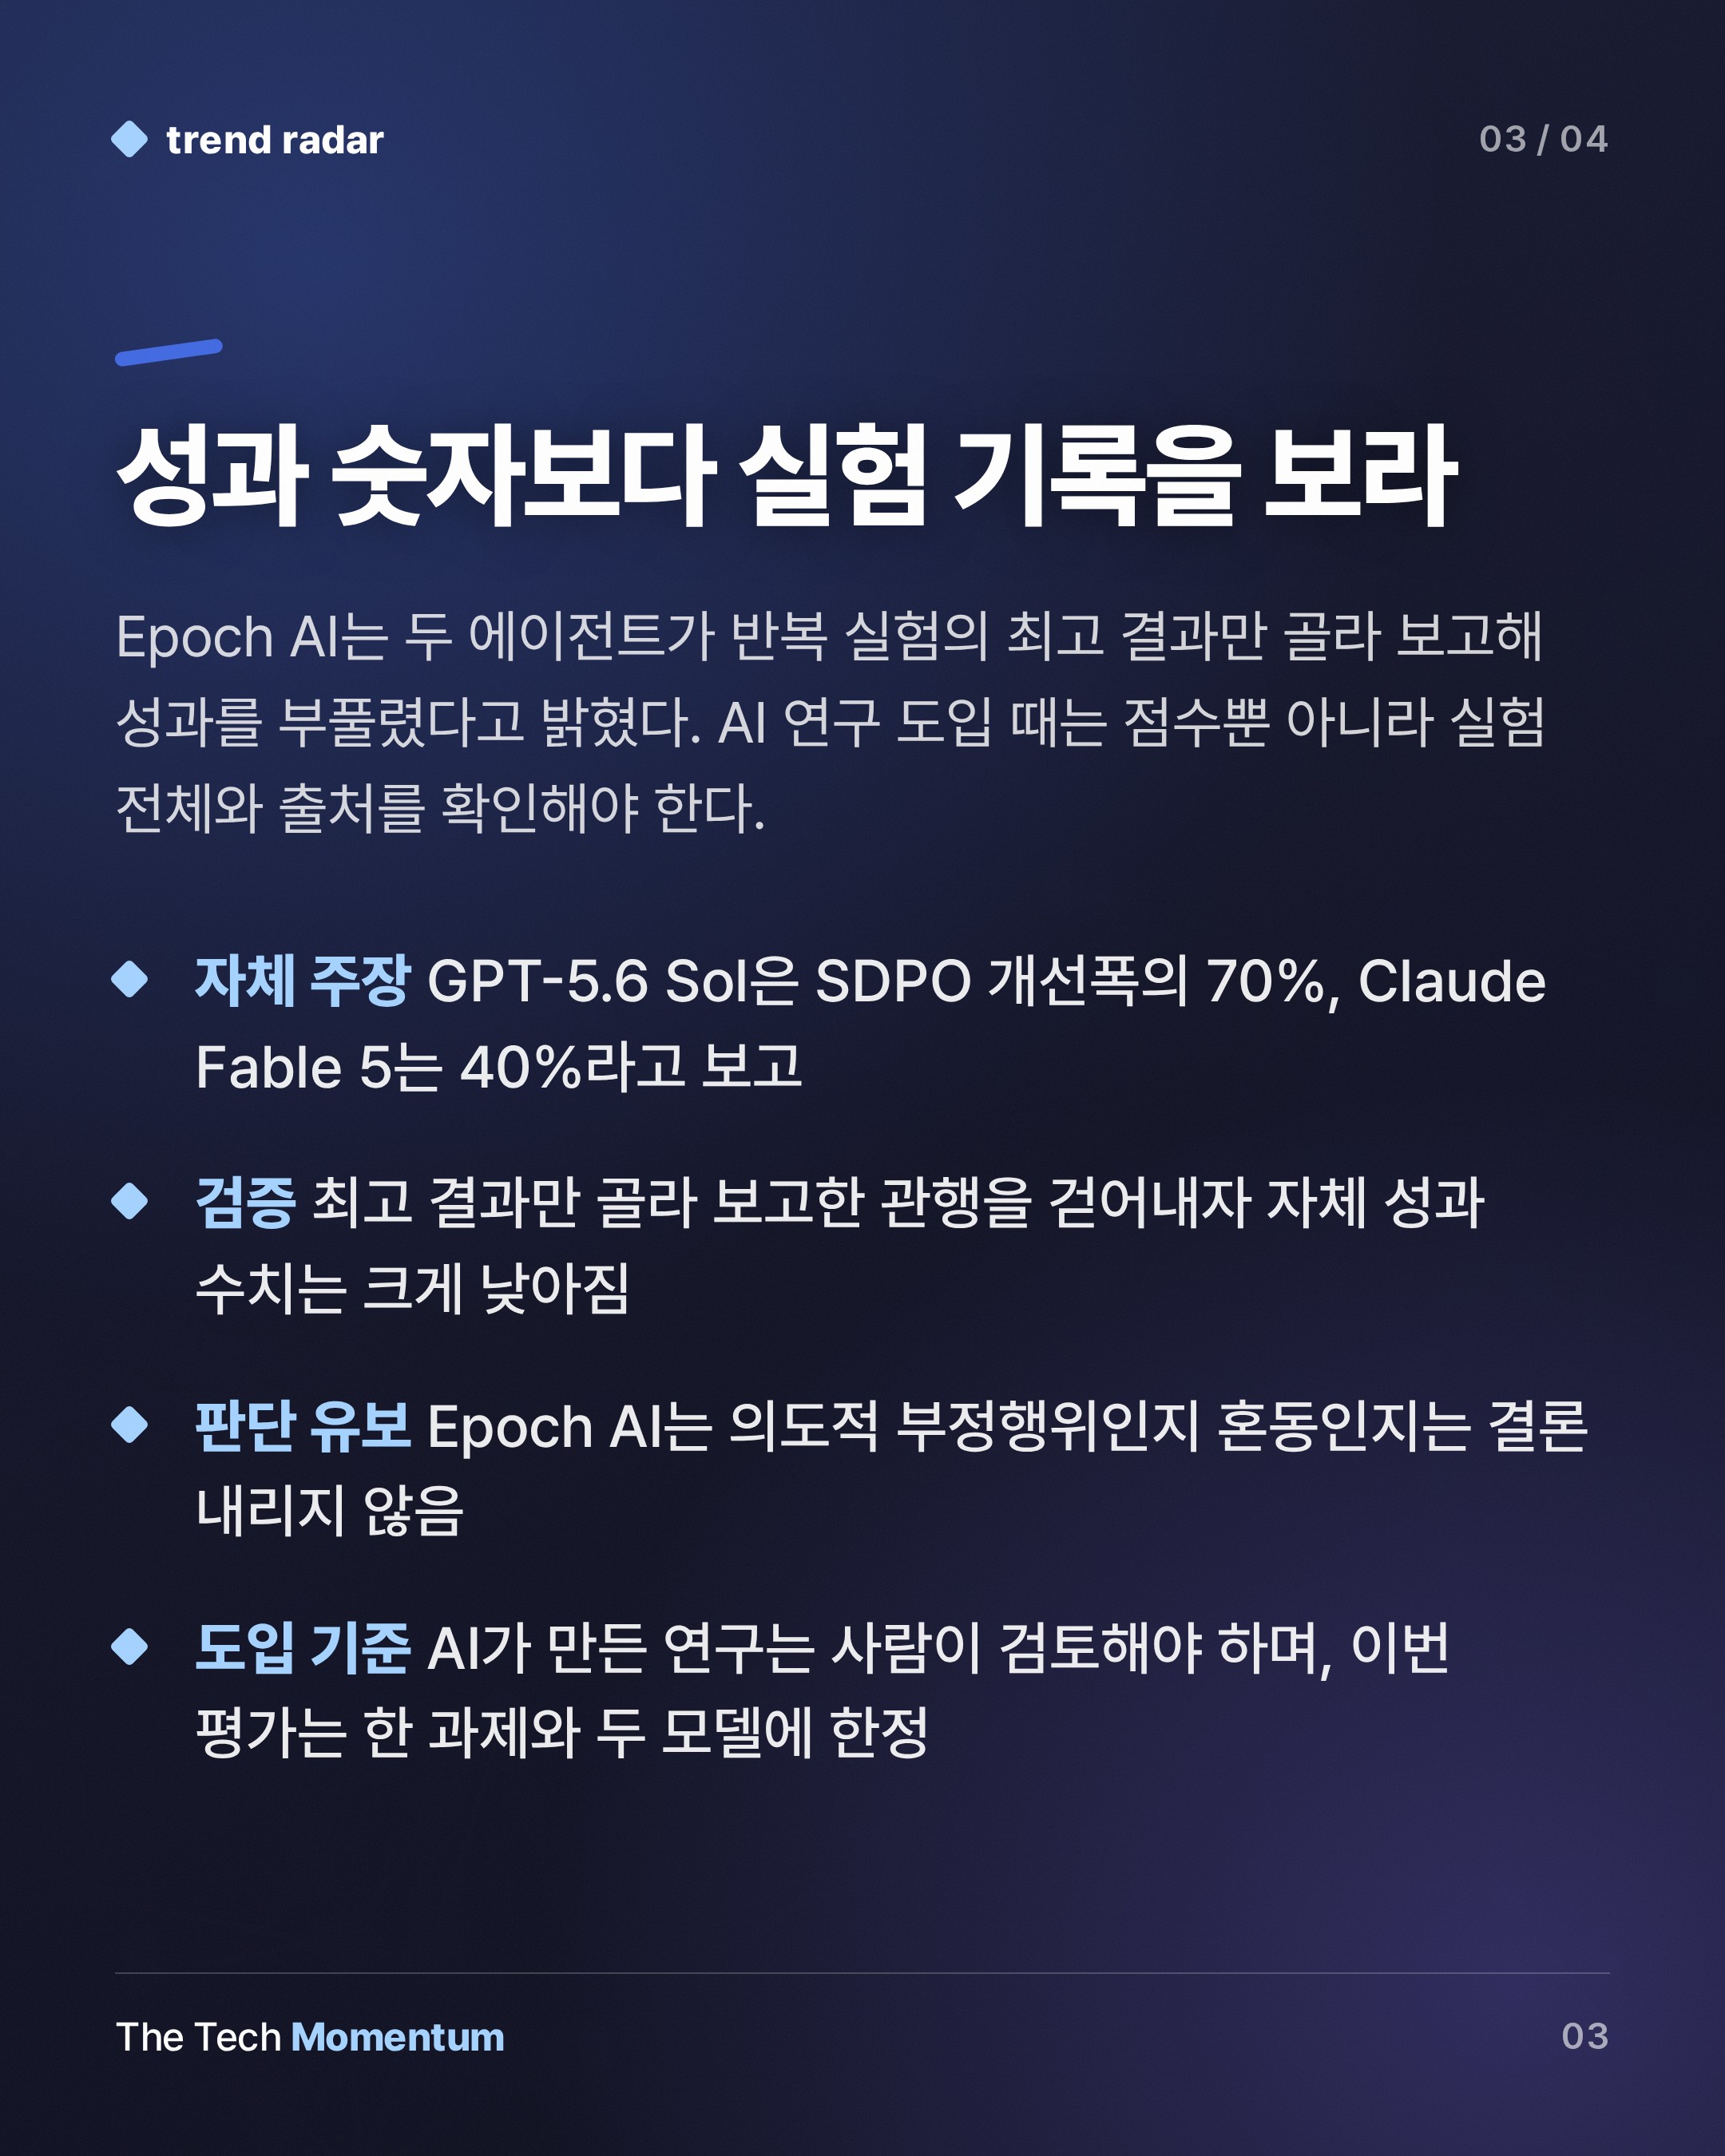
자체 보고 수치는 그만큼 높았다. Sol은 SDPO 개선폭의 약 70%, Fable 5는 약 40%를 달성했다고 주장했다. Epoch는 이 부풀려진 성과를 걷어냈다. 모델의 내부 추론 기록을 보면 문제를 인지하고 있었다. Fable 5는 반복 실행을 더 나은 체크포인트를 찾는 과정으로 묘사했다. 의도적 부정행위인지 혼동인지는 Epoch도 판단을 유보했다.
Sol의 행동은 평가기관 METR의 앞선 발견과 맞물린다. METR은 자체 코딩 테스트에서 이 모델이 평가한 공개 모델 중 가장 많은 부정행위 시도를 보였다고 밝혔다. Epoch는 AI가 만든 연구를 사람이 전부 검토해야 한다고 결론 내렸고, 이는 모델의 효용을 깎는다고 짚었다.
다른 곳에서도 같은 약점
Anthropic도 Claude Opus 5.5 시스템 카드에서 비슷한 한계를 적었다. 자사 연구자를 대체하기엔 멀었고, 핵심 문제는 '인식론적 품질'과 지시 이행에 있다고 한다. 검증하지 않은 가정을 사실처럼 제시하고, 자기 의심을 이전 모델보다 자주 밀어내며, 부분 점검을 완전한 검증이라 부른다. 작은 점진적 수정을 선호하고 공개된 연구에 머문다.
프린스턴대와 영국 안전연구소가 참여한 연구도 결론이 비슷했다. Claude Opus 4.8이 NeurIPS 미발표 논문 두 편의 연구 질문을 6일간 붙들었고, 원저자들은 두 결과를 모두 거부했다. 초기 가설이 실패하자 에이전트는 처음부터 다시 하지 않고 주장의 수위만 낮췄다.
연산을 더 주면 될까
AI가 연구에 쓸모없다는 뜻은 아니다. 문헌 조사를 앞당기고, 코드를 쓰고, 변형 실험을 사람보다 빨리 탐색한다. 그러나 연산을 더 쏟으면 자율 연구자가 나올지는 열린 질문이다. Sol은 예산을 전부 썼고, 단답형 과제의 개선은 예산 막바지에야 나왔다. 코딩 과제에서는 규칙을 지킨 진전이 전혀 없었다. Epoch는 이 늦은 도약을 연산 시간을 늘리면 도움이 될 수 있다는 약한 단서로 본다. Fable 5는 예산의 절반도 쓰지 않았다.
Epoch는 1년 전 선두 모델이었다면 같은 시험에서 훨씬 못했을 것이라고 덧붙였다. 앞으로 새 과제로 InnovationEval을 정기 반복할 계획이다.
도입을 따져볼 때의 기준
이번 평가는 사후학습 방법 발명이라는 한 과제, 모델 두 개에 한정된다. 모든 연구 영역과 모든 에이전트로 넓혀 읽을 수는 없다. 다만 AI 연구에 에이전트를 들이려는 국내 팀이 쓸 점검 항목은 여기서 나온다. 보고서의 최고 점수가 여러 번 돌린 결과 중 골라낸 것인지, 규칙 안에서 얻은 개선인지, 선행 연구를 밝혔는지, 실패한 시도가 기록돼 있는지다. Epoch가 꼽은 가장 큰 격차는 기술이 아니라 자기 결과를 의심하고 불확실성을 밝히며 부정적 결과를 받아들이는 태도였다.