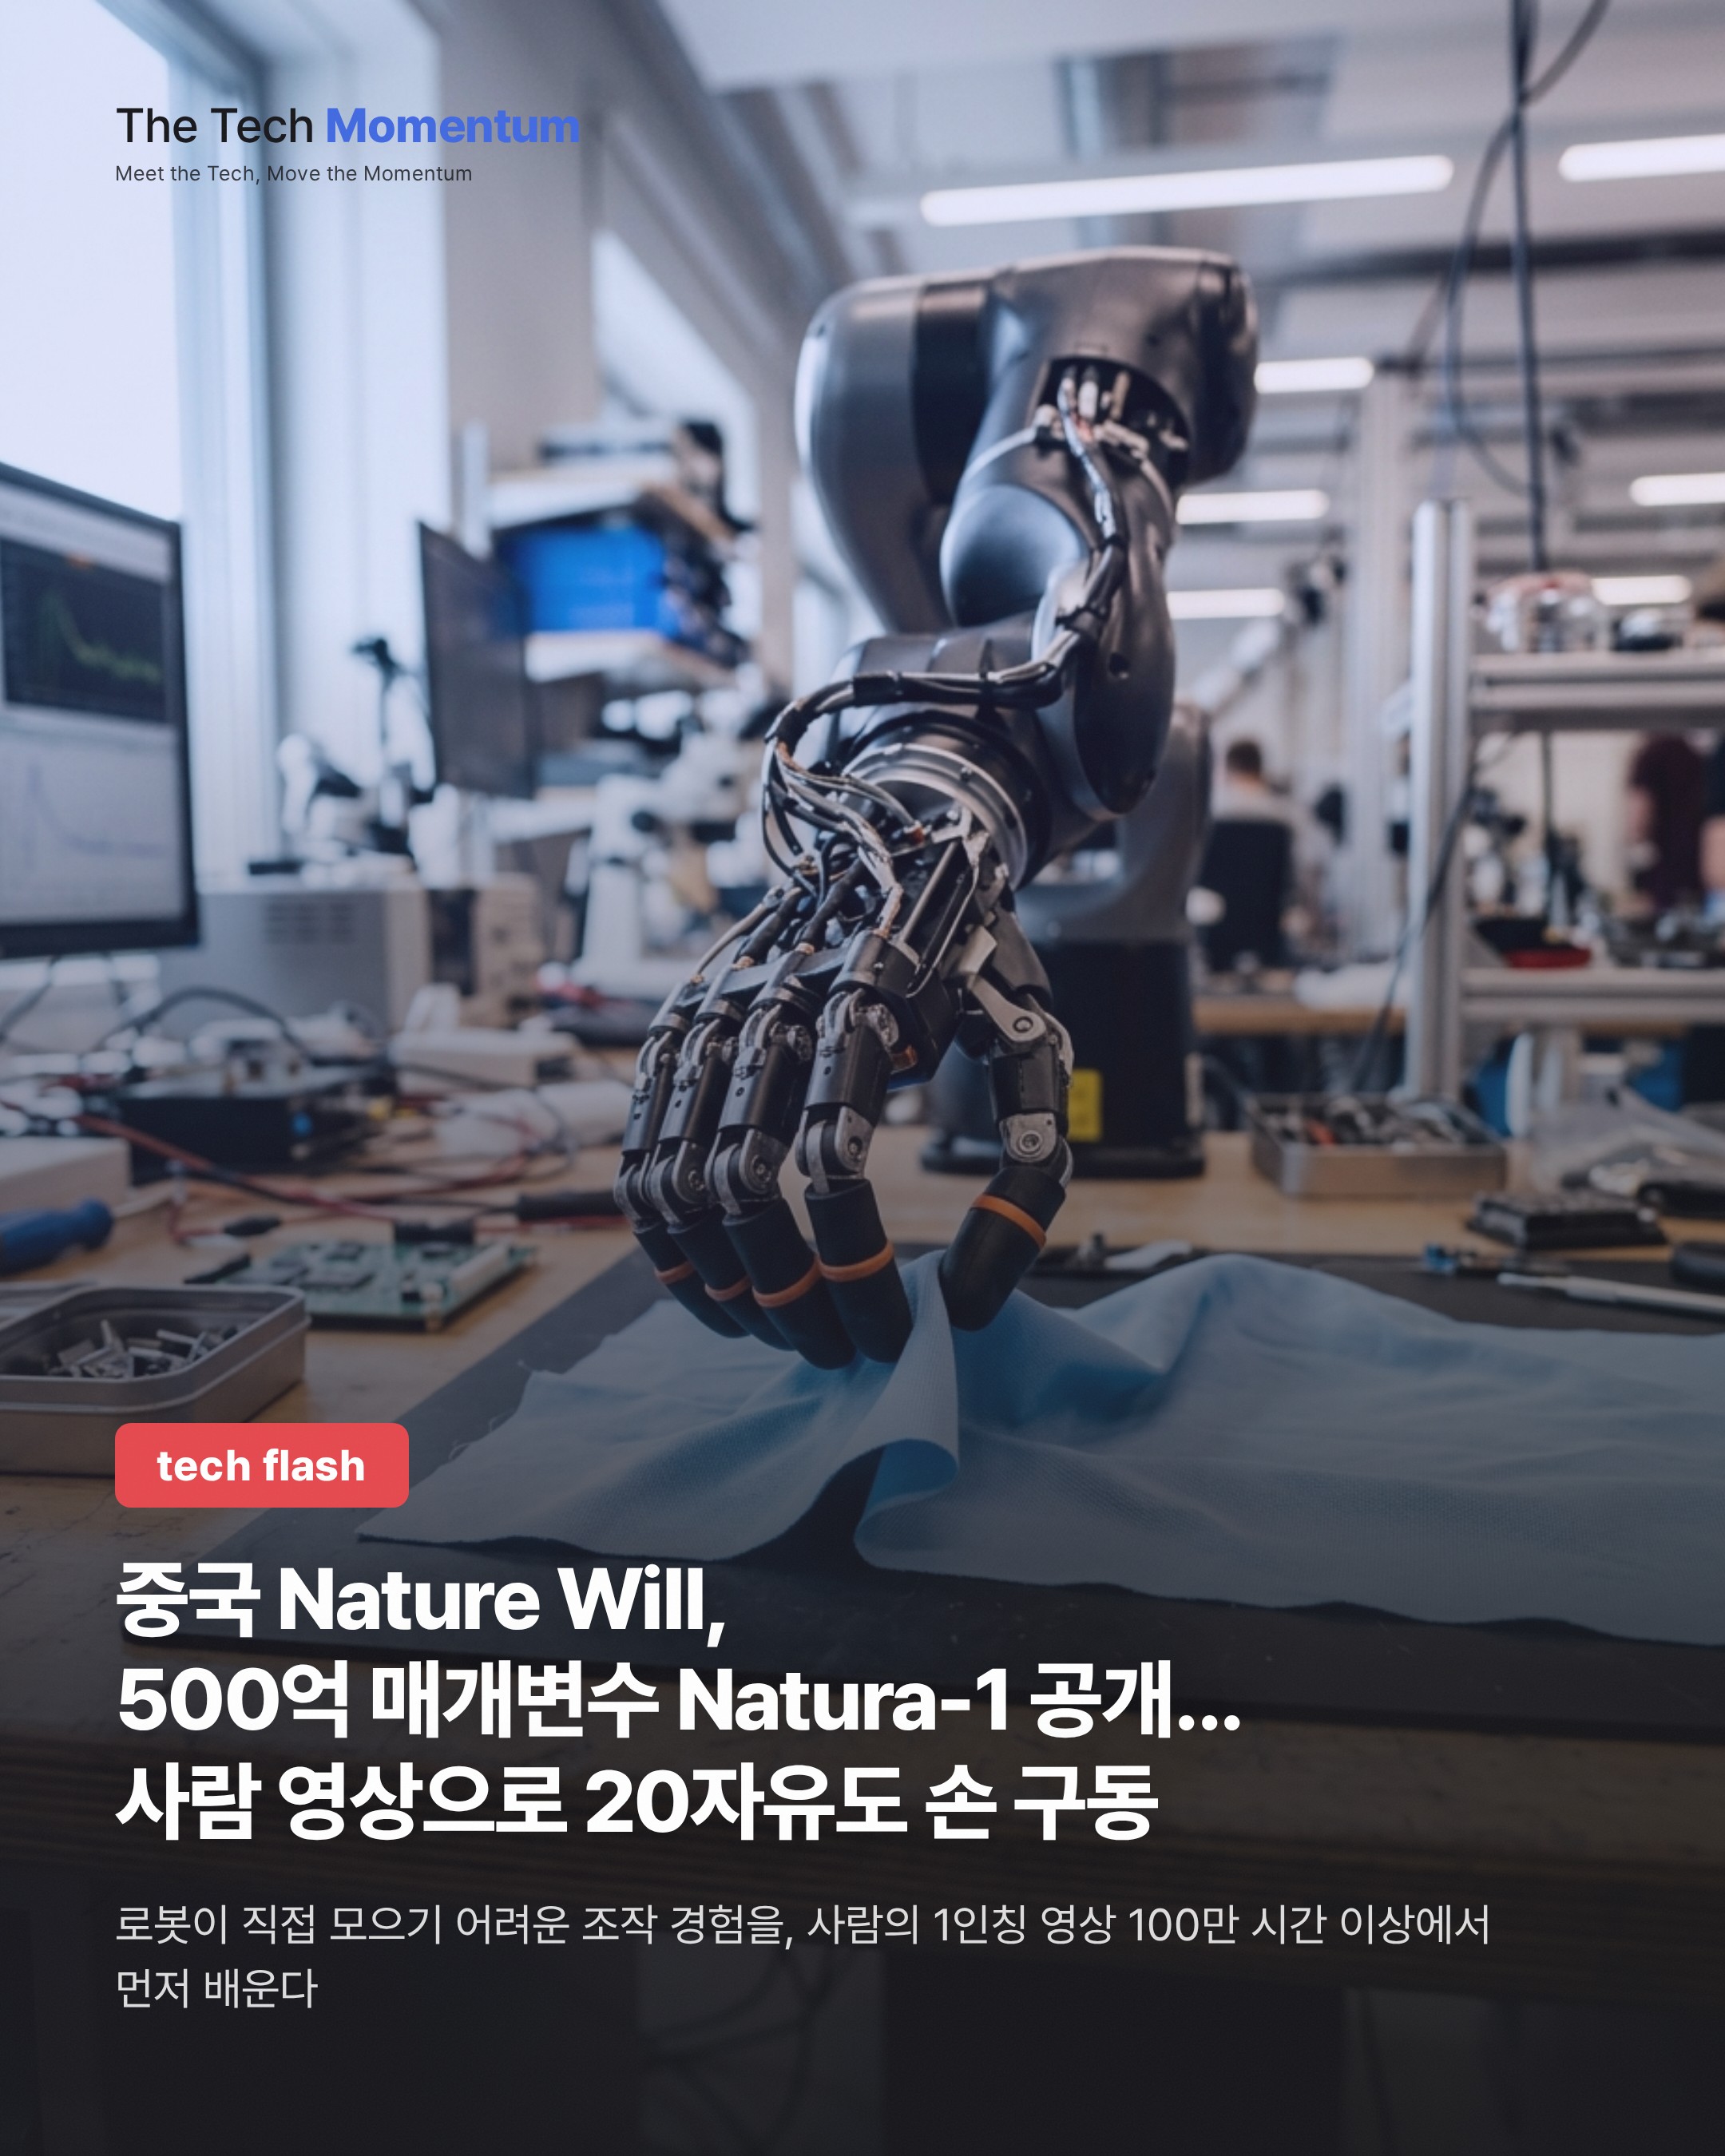
중국 스타트업 Nature Will이 10월 13일 피지컬 AI용 범용 파운데이션 모델 Natura-1을 공개했다. 언어와 시각을 입력받아 20자유도(20-DoF) 로봇 손을 구동하는 모델이다. 회사는 이를 자사의 첫 범용 물리 파운데이션 모델이라고 소개했다.
핵심 사양
▼ Natura-1 주요 사양 (출처: Nature Will 발표)
| 항목 | 내용 |
|---|---|
| 규모 | 500억 매개변수 |
| 구조 | 전문가 혼합(MoE) |
| 입력 | 언어, 시각 |
| 출력 | 20자유도 로봇 손 구동 |
| 사전학습 데이터 | 100만 시간 이상, 사람 1인칭 영상 |
왜 사람 영상인가
회사의 논리는 데이터 규모다. 로봇은 이미 작동하는 환경에서만 데이터를 모을 수 있다. 반면 사람은 거의 모든 환경에서 도구와 물체를 다룬다. 로봇이 지금은 그 규모의 물리 경험을 공급할 수 없다는 것이 회사의 주장이다.
사람 데이터로 사전학습을 마친 뒤에는 소량의 로봇 조작 데이터로 로봇 손에 맞춘다.
데이터와 인프라
회사 설명에 따른 구성은 다음과 같다.
- 학습 데이터: 중복 제거, 센서 이상 선별, 전체 목표에서 개별 단계까지 계층적 주석을 거쳤다. 언어 조건 행동 궤적 100만 시간 분량이다.
- 손 자세 복원: 단안·스테레오 영상에서 조밀한 3D 손 자세를 복원한다.
- 데이터 레이크하우스: 자체 구축했고 수십 페타바이트 규모다.
- 학습 엔진: 자체 분산 학습 엔진이 GPU 수백 장에서 모델 FLOPs 활용률(MFU) 50% 이상을 유지한다고 밝혔다.
- 추론: Rust 오케스트레이션 계층과 융합 CUDA 커널로 관측에서 행동까지 100밀리초 루프를 지킨다.
회사가 밝힌 능력
Nature Will은 Natura-1이 복잡한 자연어 지시를 제로샷으로 따른다고 설명했다. 공간 제약, 여러 물체 간 관계, 부정 조건이 포함된 지시도 해당한다. 긴 연속 작업도 완수할 수 있다고 한다.
시연 사례는 얇고 늘어지는 소재 접기, 부드러운 붓으로 서예 쓰기, 여러 단계 작업 중 도구 바꾸기다. 다만 장기 과제 6개는 추가 튜닝을 거쳤다. 나머지 결과는 모두 같은 가중치를 쓴다고 회사는 밝혔다.
벤치마크: 자체 평가
▼ 자체 벤치마크 점수 (출처: Nature Will, 독립 재현 없음)
| 구성 | 점수 | 평가 환경 |
|---|---|---|
| Natura-1 기본 | 53.4 | 양팔 로봇+정교한 손 |
| Natura-1 에이전틱 | 59.1 | 양팔 로봇+정교한 손 |
| 비교 모델 A | 13.5 | 그리퍼 플랫폼 |
| 비교 모델 B | 16.7 | 그리퍼 플랫폼 |
벤치마크는 정교한 조작 12개 차원으로 구성된 회사 자체 기준이다. 비교 모델 2종은 정교한 손 환경에서는 점수를 낼 수 없었다. 그리퍼 플랫폼에서 측정한 점수라 같은 조건의 비교가 아니다. 이 결과는 회사 자체 평가이며 독립적으로 재현되지 않았다.
회사는 Natura-1을 단일 모델이 사람 경험에서 정교한 기술을 익힐 수 있다는 초기 증거라고 설명한다. 스택 각 부분은 더 키울 수 있게 설계했다는 입장이다.