숫자 하나로 시작한다. 약 3만 시간. UBTECH가 Thinker-WM을 학습시킨 데이터의 총량이다. 가정·매장·공장에서 찍은 1인칭 사람 영상이 약 2만 시간, 여러 종류의 실제 로봇 데이터가 약 1만 시간, 시뮬레이션이 약 1,000시간이다.
중국 로봇 기업 UBTECH는 자사 Thinker 팀이 개발한 월드 모델 Thinker-WM의 구성을 공개했다. 기술 논문은 arXiv에서 볼 수 있다. 이 모델은 RGB 영상, 미터 단위 깊이 정보, 로봇 행동을 하나의 공유 표현에 담는다.
쪼개진 신호를 다시 붙이다
UBTECH가 짚는 문제는 기존 월드 모델의 구조다. 영상 생성이 픽셀을 맡고, 정책 네트워크가 행동을 맡고, 별도 모듈이 기하 구조를 예측하는 식으로 이어붙인 모델이 많다는 것이다. 회사는 이 방식이 물리적으로 얽혀 있는 신호를 갈라놓는다고 주장한다.
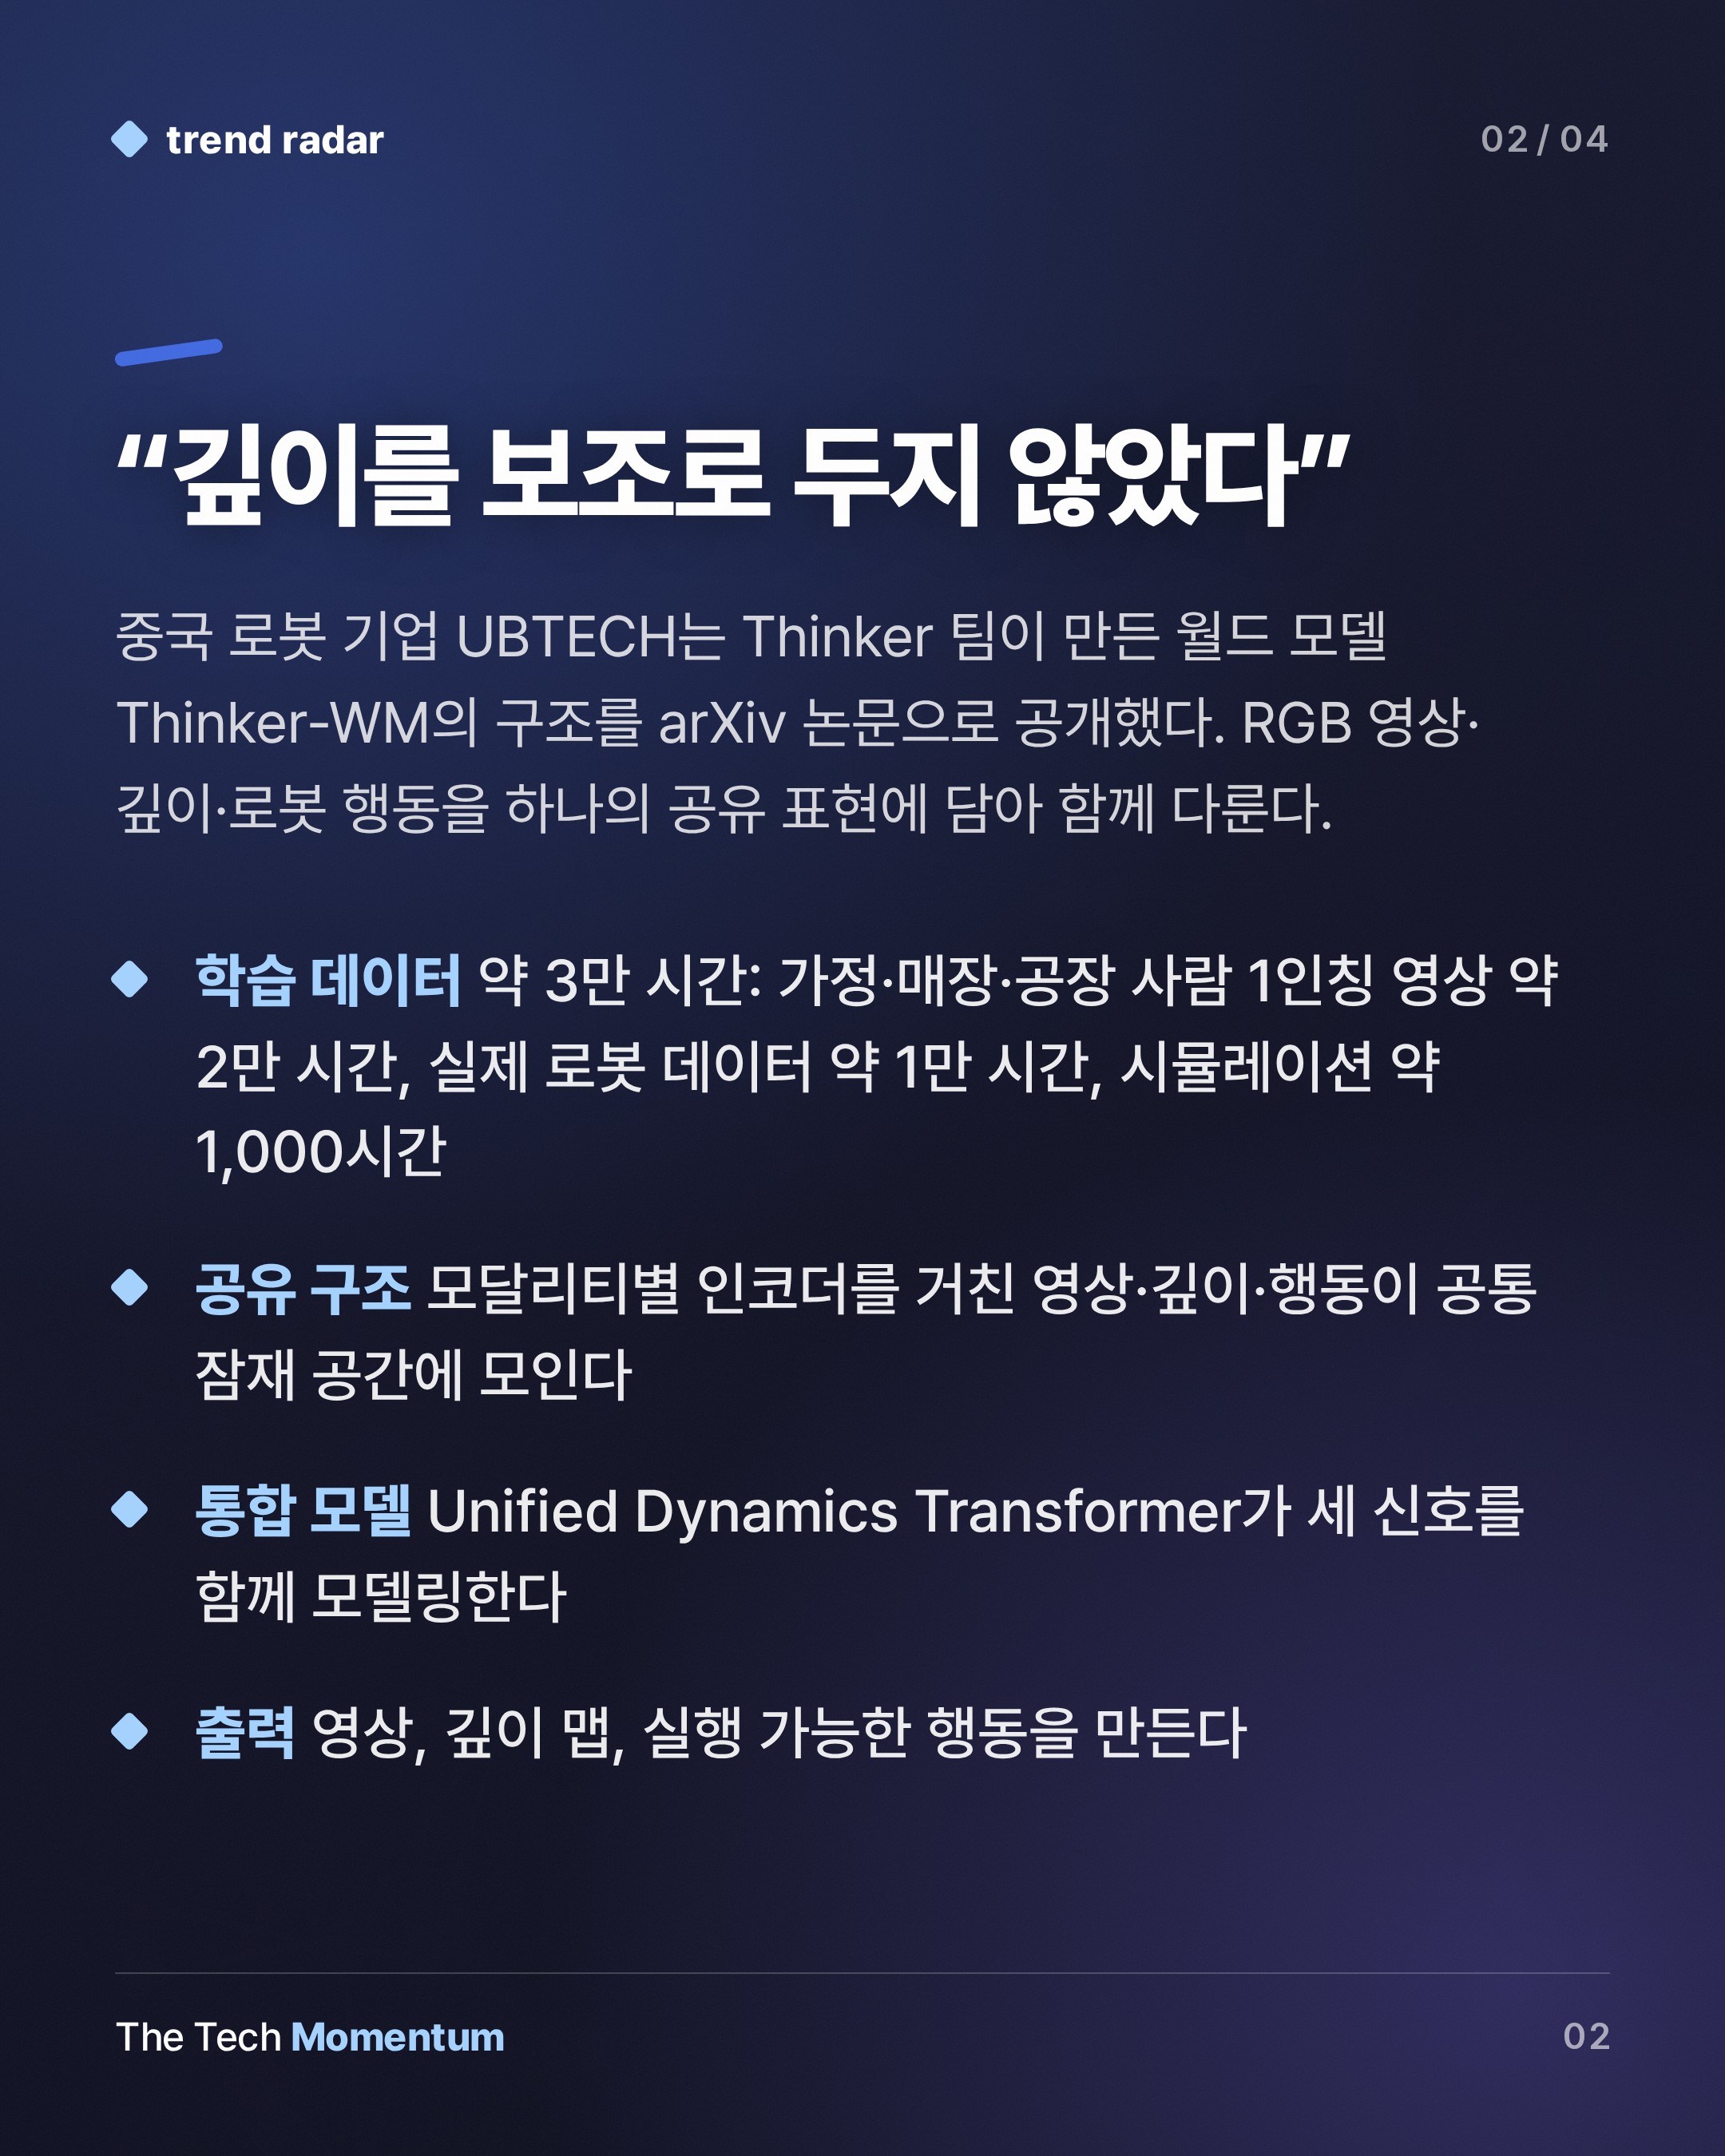
Thinker-WM은 방향이 다르다. 모달리티마다 자기 인코더를 거쳐 공통 잠재 공간으로 들어간다. 그 뒤 하나의 Unified Dynamics Transformer가 셋을 함께 모델링한다. 출력은 영상, 깊이 맵, 실행 가능한 행동이다. 깊이는 보조 신호가 아니라 처음부터 출력의 일부다.
로봇 행동은 모두 엔드이펙터 자세로 표현한다. 로봇 기종별 태그를 붙여, 서로 다른 기계가 같은 생성 공간을 쓰게 했다. 샘플링, 계층별 품질 점검, 깊이와 영상 정렬은 Data Factory라는 데이터 파이프라인이 맡는다.
가중치 하나로 여섯 가지 모드
모달리티가 가중치를 공유하기 때문에, 입력으로 줄 것과 생성할 것을 바꾸면 같은 모델이 여섯 가지 모드로 돌아간다. 영상과 행동 동시 생성, 미래 예측, 정책 추론, 영상에서 행동 추출, 역동역학 등이 포함된다.
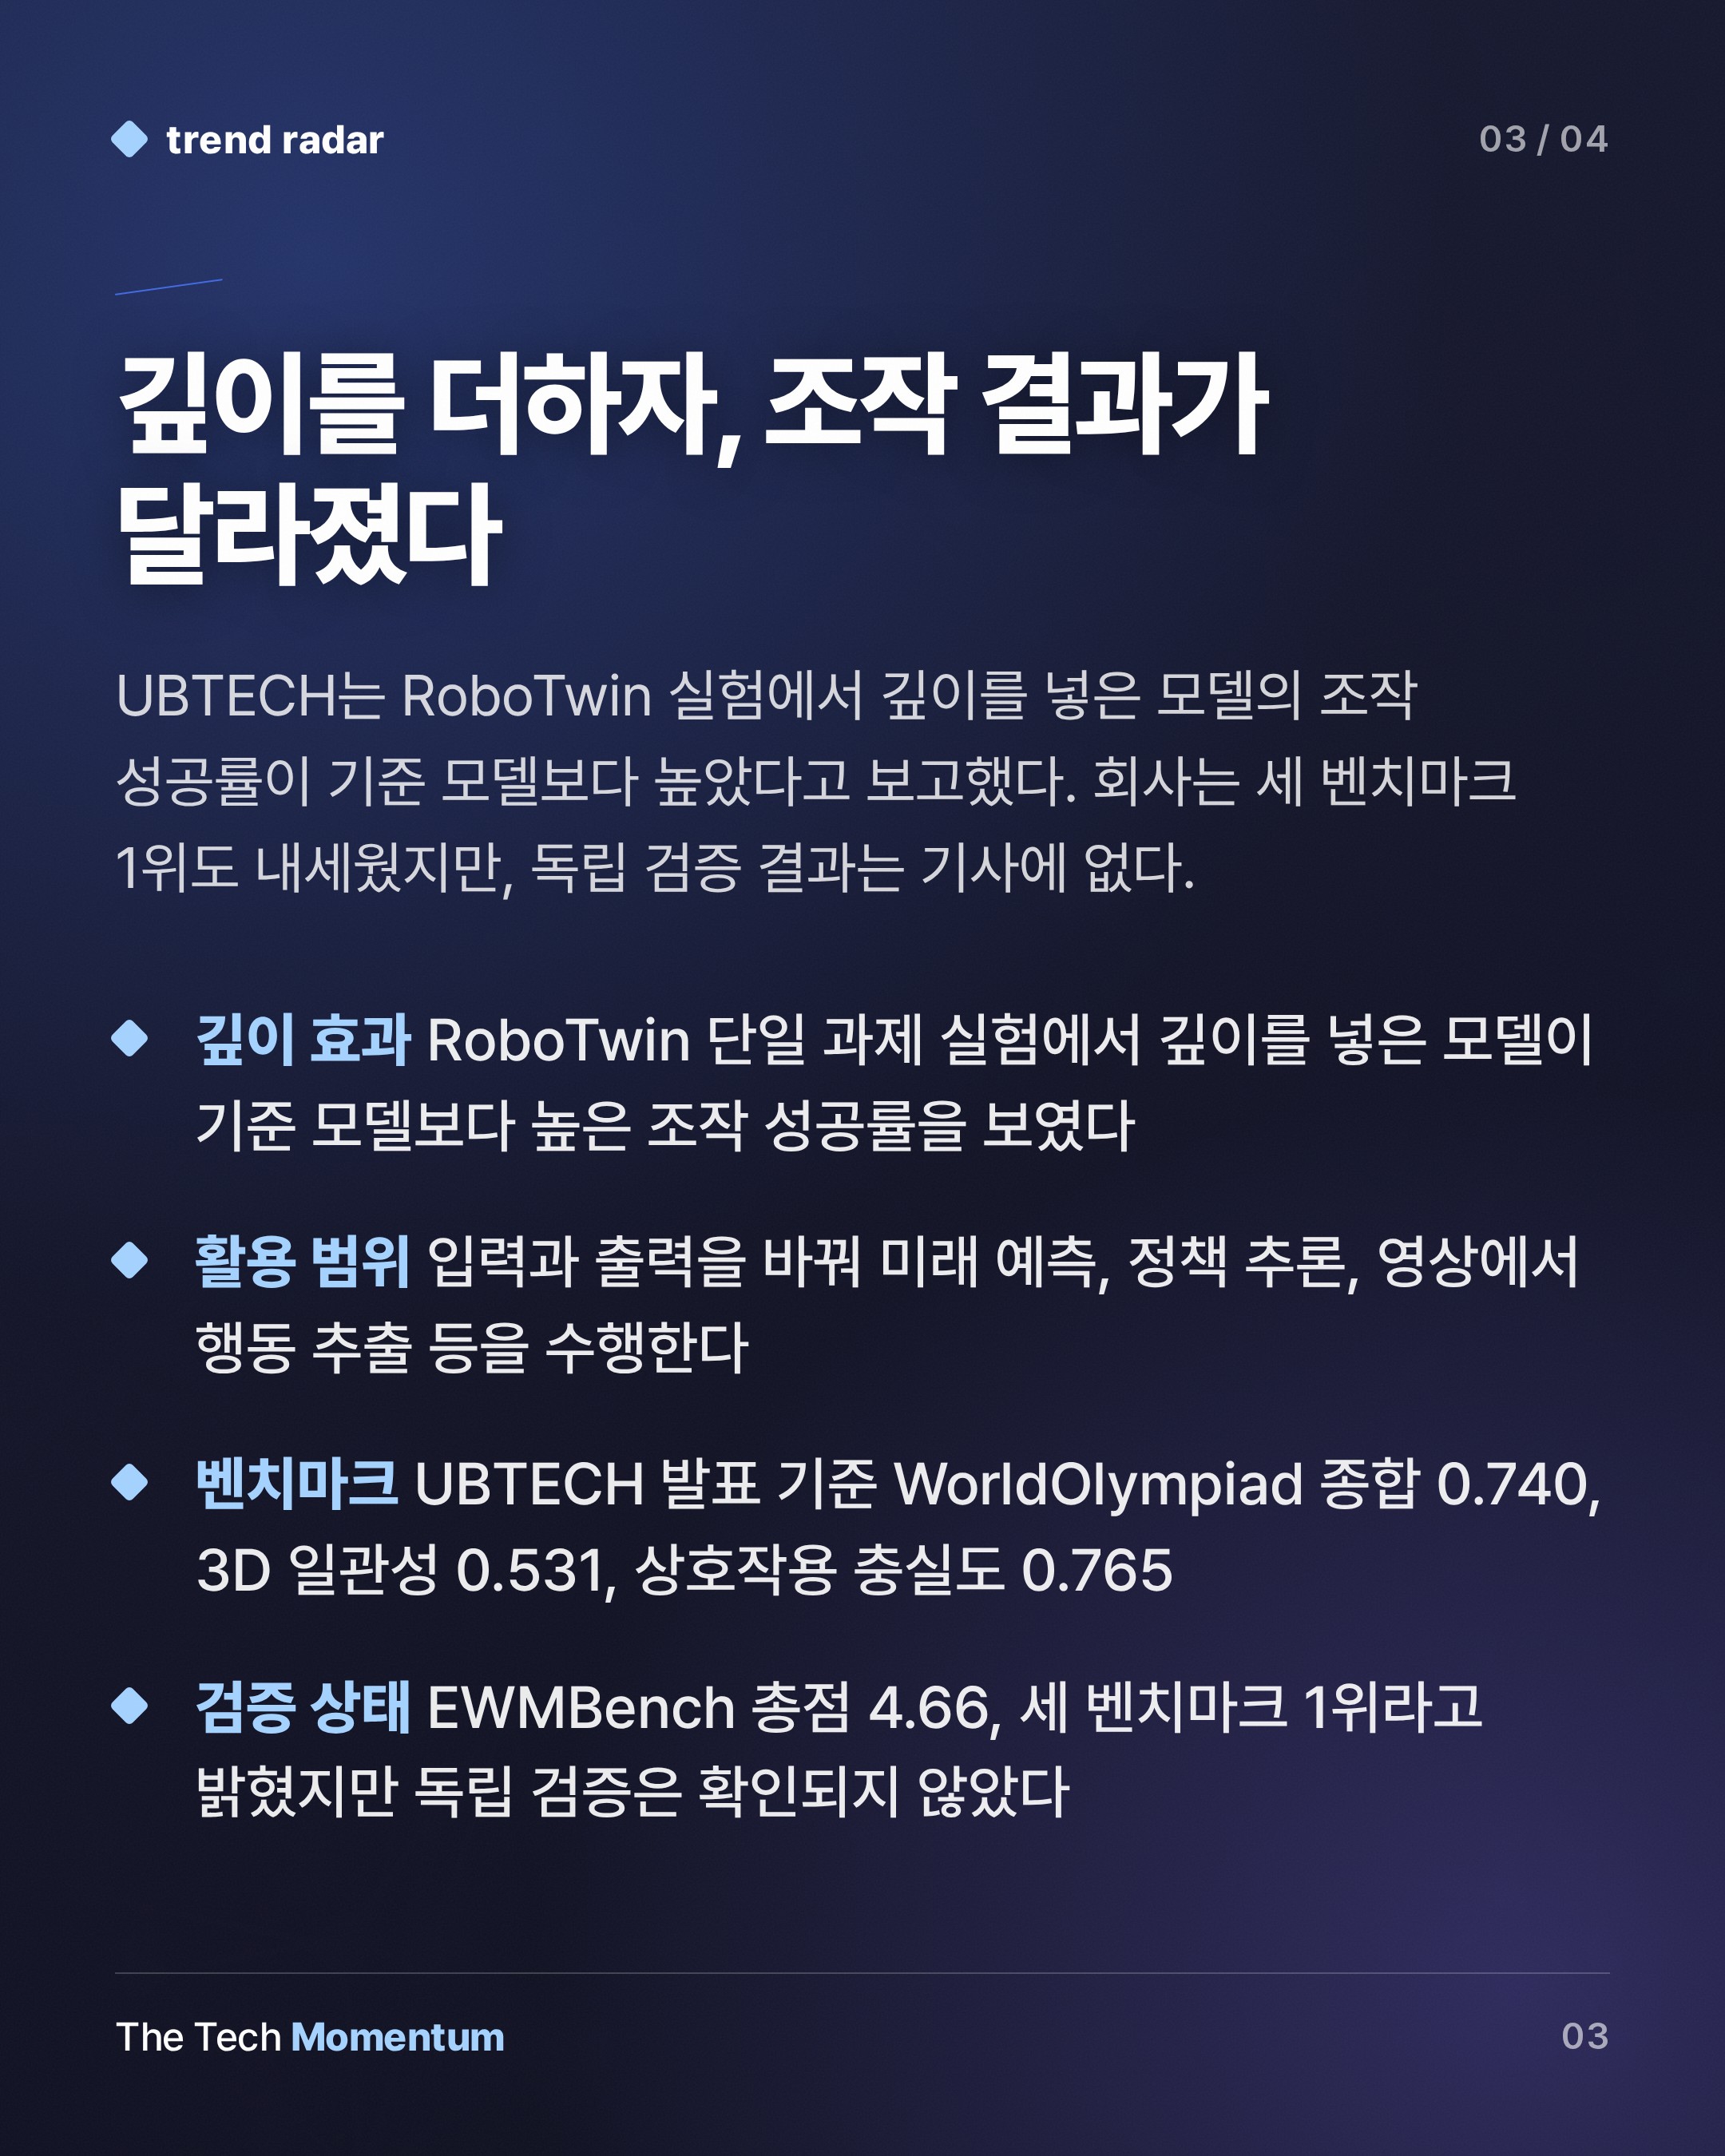
깊이의 효과는 RoboTwin 단일 과제 제거 실험에서 나왔다. 깊이를 넣자 조작 성공률이 깊이 없는 기준 모델보다 15%p 올랐다. 공유 공간이 정말 모달리티를 엮는지 보려고, 얼린 시각 특징 위에 작은 모션 프로브를 얹어 엔드이펙터 변위를 복원하는 실험도 했다. UBTECH는 이를 교차 모달 결합의 근거로 내세운다.
벤치마크 성적은 회사 주장
UBTECH는 구현 월드 모델 벤치마크 세 곳에서 1위라고 밝혔다. 다만 발표 시점 결과에 기댄 회사 측 주장이다.
| 벤치마크 | UBTECH 보고 결과 |
|---|---|
| WorldOlympiad | 종합 0.740, 3D 일관성 0.531, 상호작용 충실도 0.765(단일 항목 최고) |
| EWMBench | 총점 4.66, Qwen-RobotWorld·Sora 2 등보다 앞섬 |
| WorldArena 1.0 Track-1 | 시뮬레이션 기반, 12개 평가 차원에서 선두 |
WorldOlympiad는 실제 로봇 상호작용 데이터로 만들었고, 로봇 10종 넘는 기체와 여러 카메라 구성을 다룬다.
공개된 것은 구조와 논문
이번 공개의 핵심은 성능표보다 설계다. 영상, 깊이, 행동을 한 모델 안에서 같이 다루려는 시도다. 로봇 AI가 화면 속 픽셀을 넘어 거리와 움직임까지 한 공간에서 읽겠다는 연구 방향이다. 논문은 arXiv에 올라 있고, 벤치마크 수치의 독립 검증은 아직 소스에 없다.