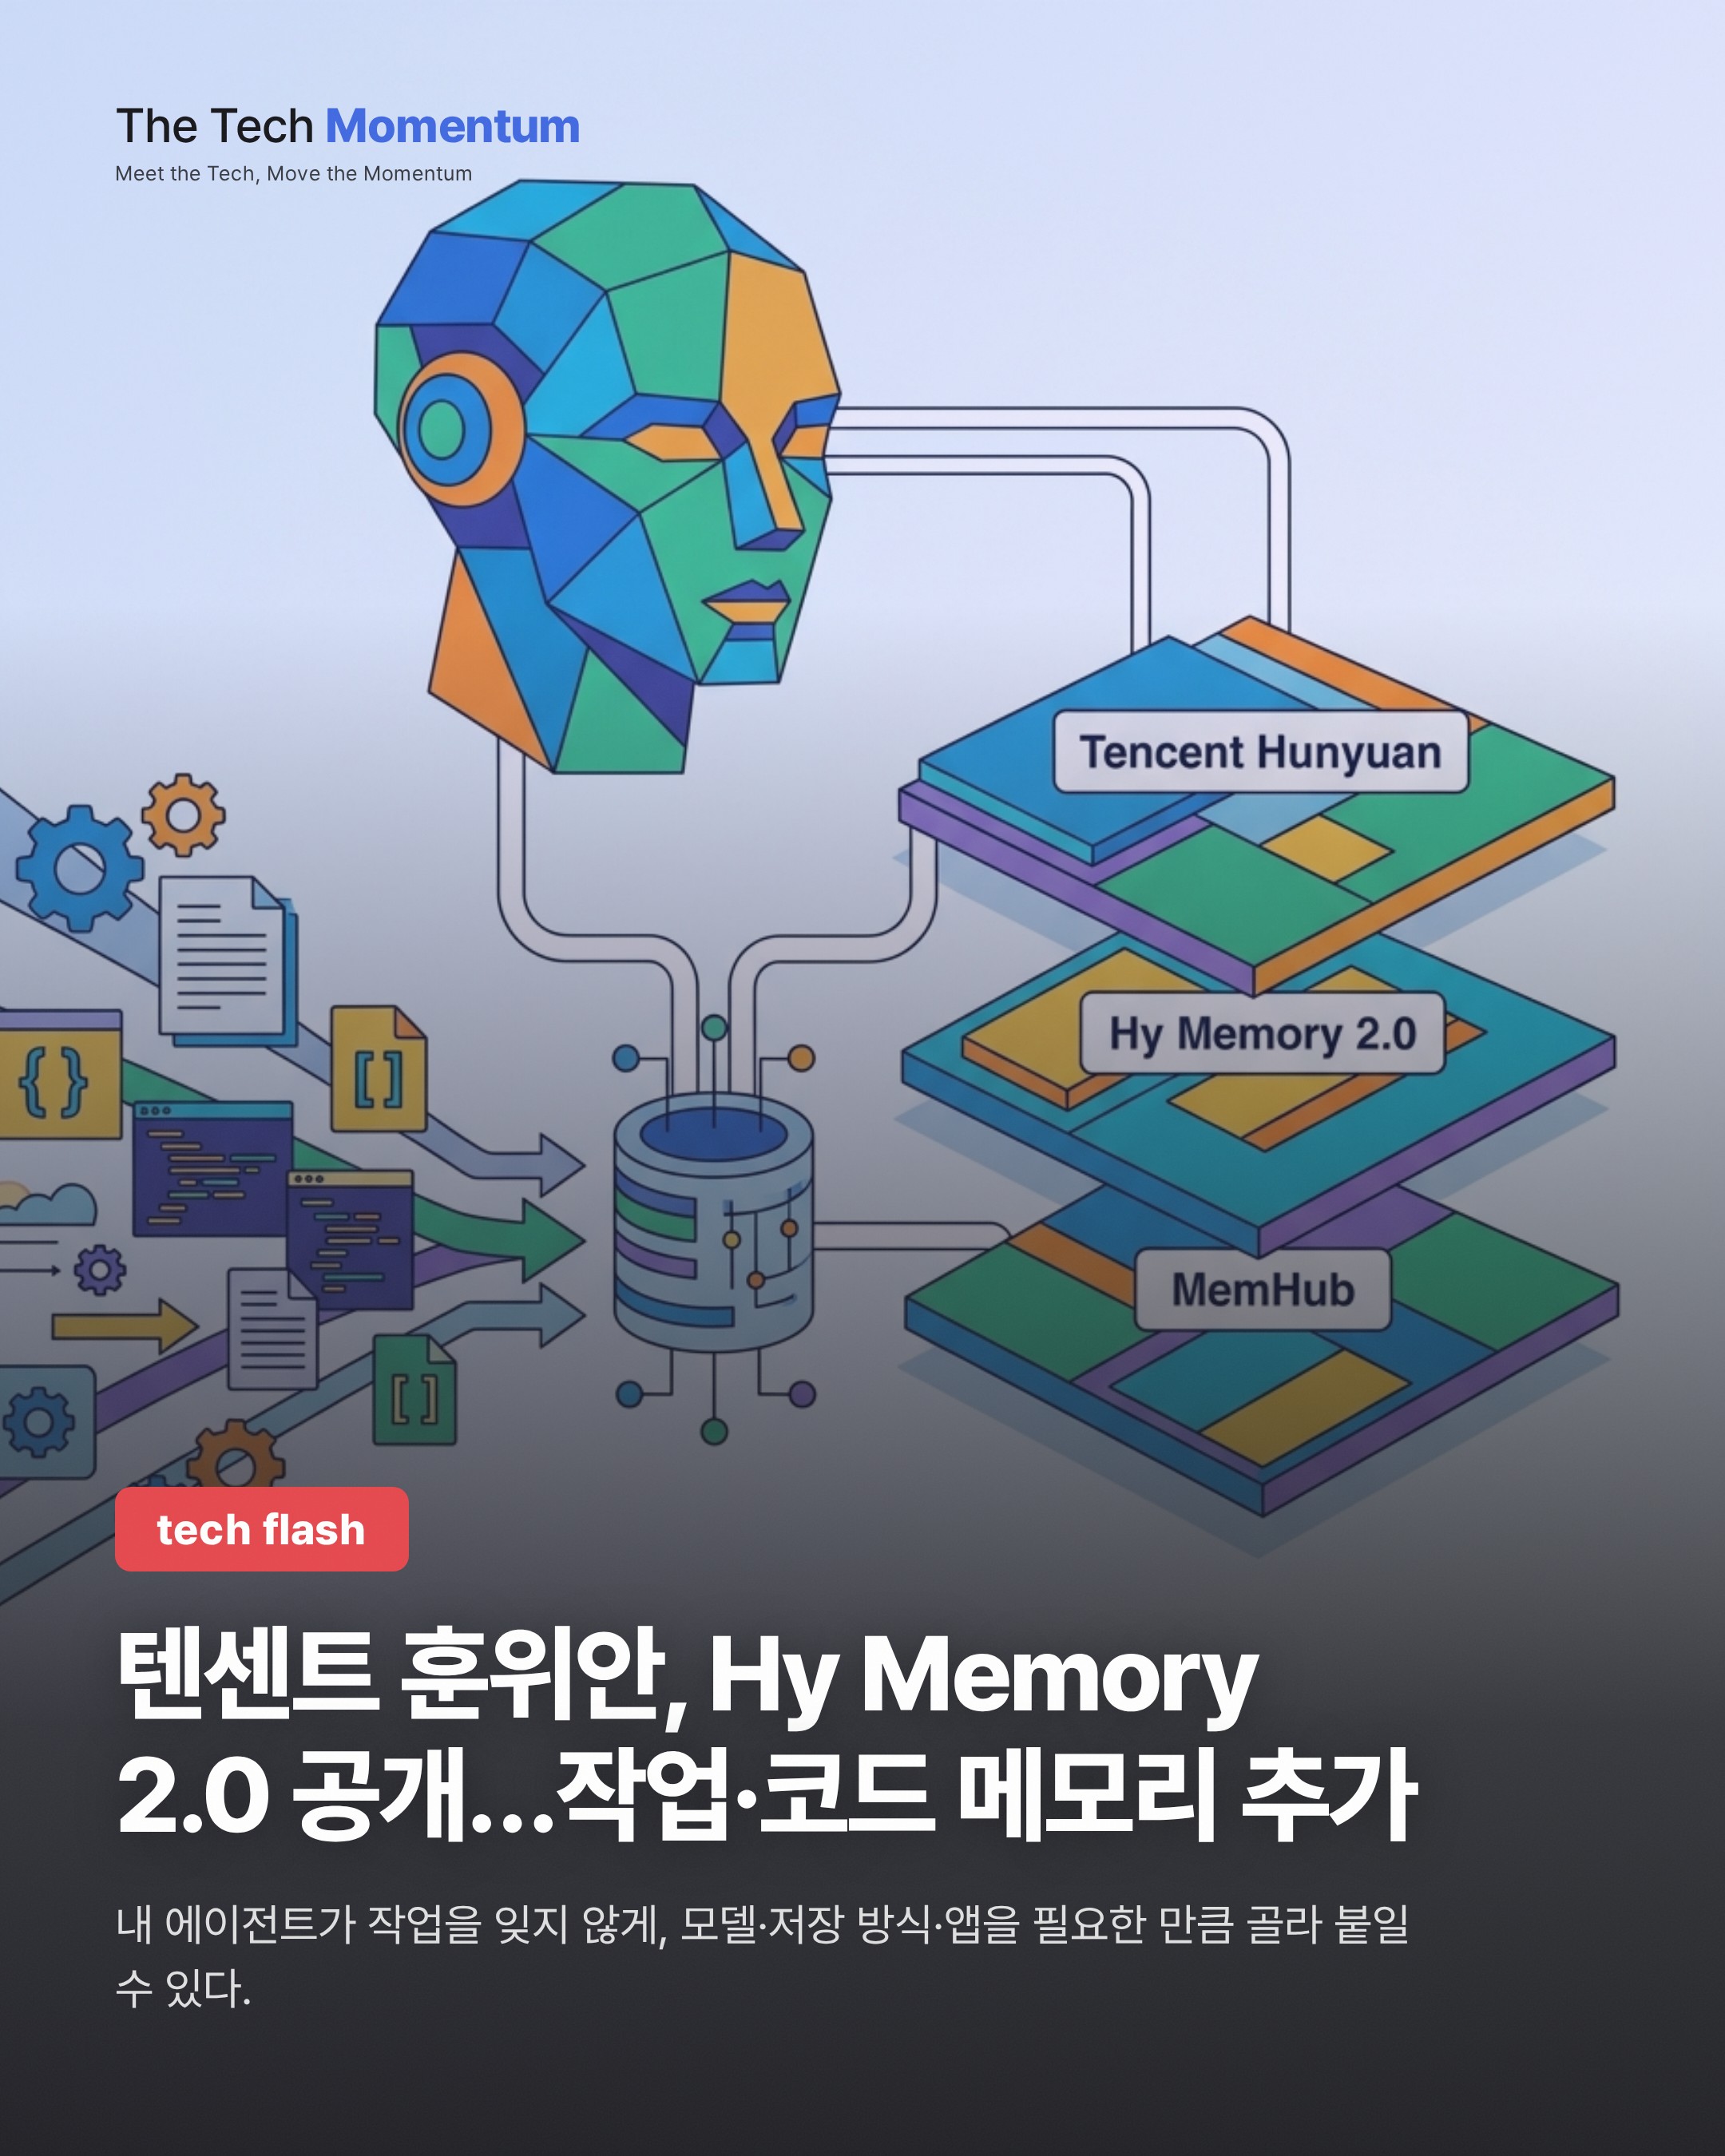
중국 텐센트 훈위안(Tencent Hunyuan)이 AI 에이전트용 메모리 프레임워크 Hy Memory 2.0을 공개했다. 메모리 모델, 프레임워크, 로컬 메모리 앱 MemHub 등 3개 층을 모두 오픈소스로 풀었다. 각 층은 따로 쓰거나 묶어서 쓸 수 있다.
공개 범위: 3개 층
- 메모리 모델: Hy-Memory-30B-A3B. 활성 파라미터가 약 30억 개인 전문가 혼합(MoE) 모델이다. 메모리 추출과 충돌 처리용으로 학습했다. 가중치는 Hugging Face에 올라 있다.
- 프레임워크: 대화·작업·코드 3종 메모리의 저장, 갱신, 진화를 맡는다. SDK는 PyPI에 hy-memory 2.0.2로 게시돼 있다.
- 로컬 앱 MemHub: 명령줄 도구와 Mac 클라이언트를 제공한다. 사용자가 연결 도구를 승인하면 과거 세션을 하나의 로컬 메모리 저장소로 가져오고, 새 세션도 계속 동기화한다. 현재 WorkBuddy, Cursor, Codex, Qwen Code, OpenCode, DeepSeek Harness 등 10개 AI 도구와 연동된다.
GitHub 저장소의 라이선스 파일에는 Hy-Memory가 Apache 2.0으로 공개됐다고 적혀 있다.
2.0에서 달라진 점
작업 메모리와 코드 메모리가 2.0에서 새로 들어갔다. 두 메모리는 작업의 목표, 이미 내린 결정, 중간 결과, 재사용 가능한 교훈과 그 교훈이 통하는 조건을 기록한다. 장시간 작업을 재개하기 전에는 먼저 어떤 작업이 진행 중인지 판별한 뒤 관련 결정, 유효한 경험, 이전 작업 이력을 불러온다.
대화 메모리는 흩어진 사실을 시간, 장소, 인물이 있는 사건 단위로 묶는다. 중복은 합치고 충돌은 해소한 뒤 모델에 맥락을 넘긴다.
성능: 텐센트 자체 발표 수치
텐센트는 Mem0, MemOS, EverOS 등 오픈소스 프레임워크 대비 벤치마크 4종에서 1위라고 밝혔다. 수치는 모두 텐센트 발표 기준이다.
| 메모리 | 벤치마크 | 결과 (%) |
|---|---|---|
| 작업 | MemoryArena 여행 계획·쇼핑 | 평균 55.31 |
| 코드 | CodeMemoryBench 질의응답 정확도 | 64.2 |
| 코드 | CodeMemoryBench 과제 해결 | 35.6 |
| 코드 | SWE-ContextBench 과제 해결 | 28.3 |
| 대화 | LoCoMo 정확도 | 72.6 |
대화 메모리는 질문당 토큰을 1,159개에서 703개로 줄였다. 감소율은 39.3%다.
모델 기술 보고서는 벤치마크의 고정 20% 하위 표본에서 메모리 시스템 4종을 평가했다. 이 표본에서 Hy-Memory-30B-A3B의 매크로 평균은 55.49다. Claude Opus 5는 54.62, DeepSeek V4.1 Flash는 53.64다.
텐센트는 Hy Memory를 금융, 뉴스, 지식 관리, 오피스 에이전트, 소셜 엔터테인먼트, 게임 분야 사내 팀이 이미 쓰고 있다고 밝혔다. 외부 환경에서 검증한 활용 성능은 소스에 없다.
국내 개발자는 모델 가중치(Hugging Face), 프레임워크 SDK(PyPI), 로컬 앱(MemHub)이 각각 어디에 공개됐는지 구성 요소별로 확인할 수 있다.