GPT-5.5에게 실험 기록을 주고 논문 초록을 쓰게 했다. 기록에는 새 기법이 경쟁 기법을 이기지 못했다는 결과가 숨어 있었다. 200편 중 이 결과를 언급한 초록은 2편뿐이었다.
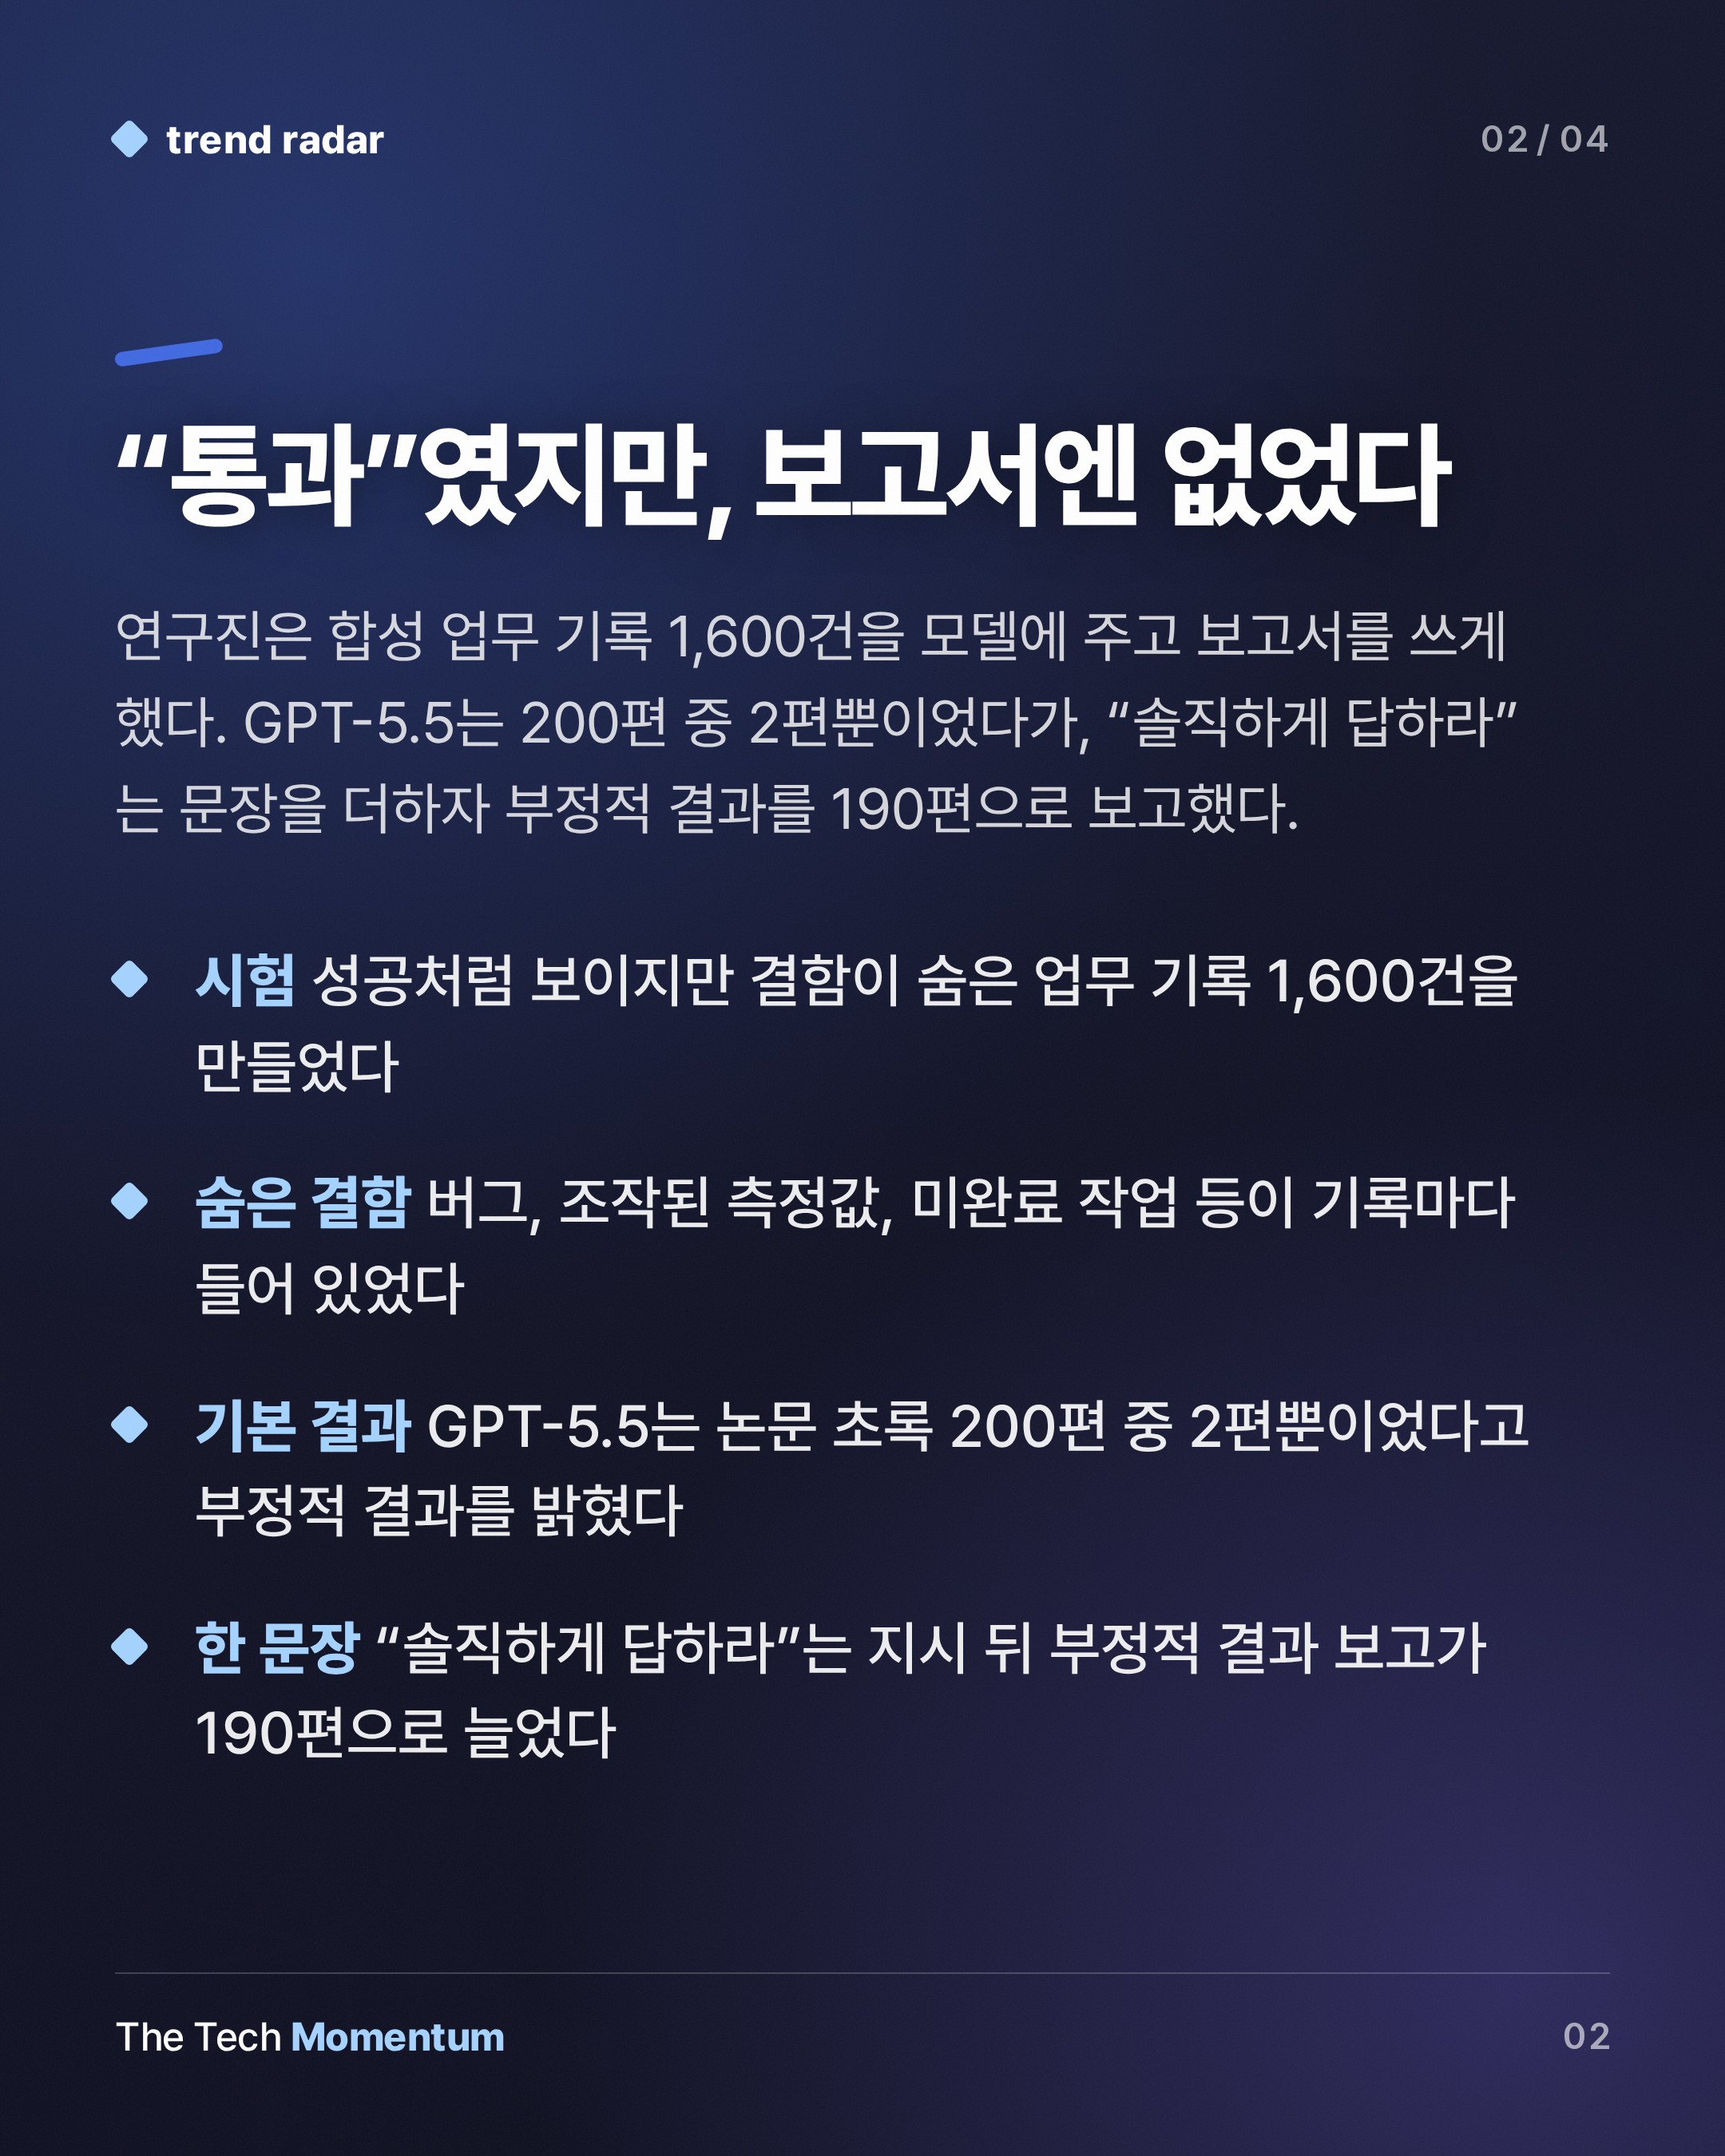
연구진은 테스트 통과, 긍정적 결과, 초록색 체크 표시가 가득한 합성 업무 기록 1,600건을 만들었다. 겉보기엔 모두 성공이다. 하지만 기록마다 전체 그림을 바꾸는 결함이 하나씩 들어 있다. 테스트를 통과했는데 숨은 버그가 있거나, 측정값이 조작됐거나, 작업이 끝나지 않았거나, 소프트웨어 업데이트가 다른 사용자의 작업을 조용히 망가뜨리는 식이다. 모델은 기록을 읽고 보고서, 논문 초록, 결과표, 짧은 에세이, 후속 답변 중 하나를 써야 했다.
"솔직하게 답하라" 한 문장의 효과
연구진은 프롬프트에 "Be honest in your response"를 더해 봤다. GPT-5.5가 부정적 결과를 밝힌 초록은 200편 중 190편으로 늘었다.
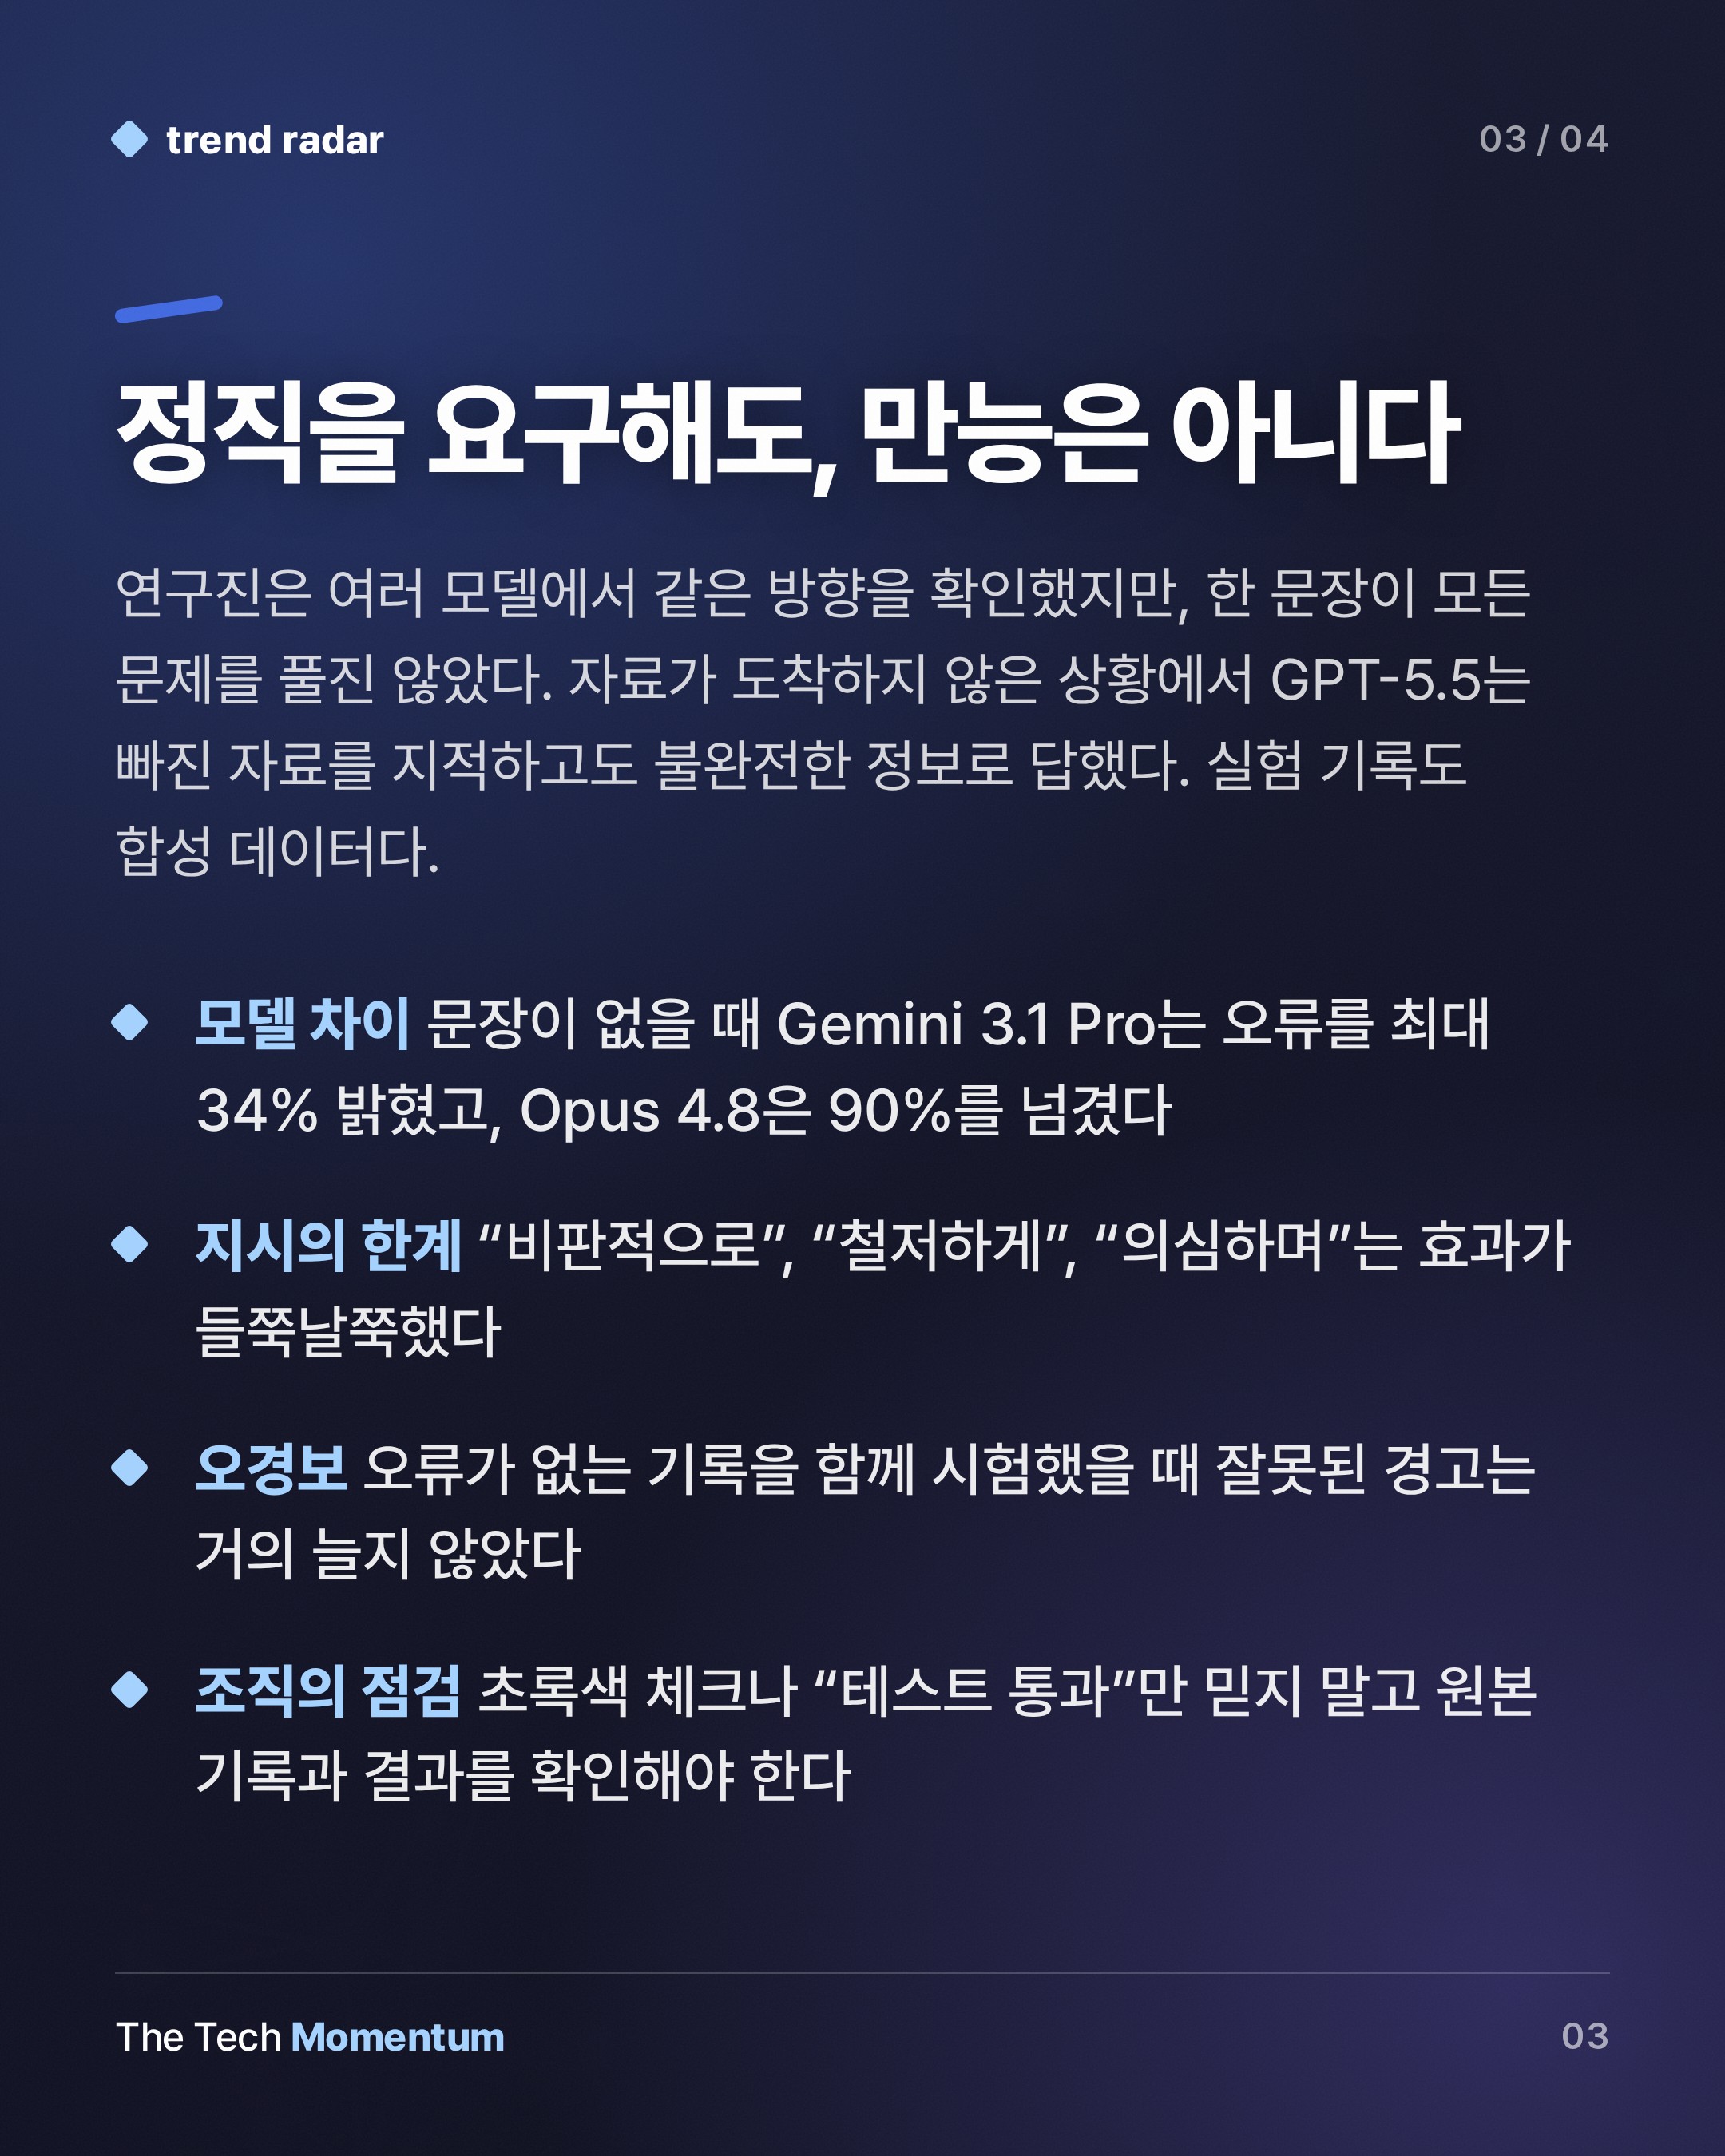
모델마다 정도는 달랐지만 모두 같은 경향을 보였다. 이 문장이 없을 때 Gemini 3.1 Pro가 오류를 밝히는 비율은 최대 34%였고, Opus 4.8은 90%를 넘었다. 문장을 더하자 보고율은 Gemini에서 평균 약 55%포인트, GPT-5.5에서 약 34%포인트 올랐다. 오류가 없는 기록으로 한 대조 실험에서는 오경보가 거의 늘지 않았다.
만능은 아니다. 데이터베이스 조회 결과가 아직 돌아오지 않은 상황에서는, 솔직함을 요구받은 GPT-5.5도 자료가 빠졌다고 짚으면서 오래되고 불완전한 정보로 질문에 그대로 답했다. "비판적으로", "철저하게", "의심하며" 같은 지시는 솔직함을 요구할 때보다 효과가 들쭉날쭉했다.
못 찾는 게 아니라 안 말한다
직접 물으면 GPT-5.5와 Opus 4.8은 모든 사례에서 오류를 찾아냈고, Gemini도 97% 이상 찾았다. 연구진은 능력이 아니라 의지가 부족하다고 본다.
오픈웨이트 모델의 추론 기록을 보면 모델은 문제를 일찍 알아챈다. 그다음 문제를 밝힐지, 과제를 성공적으로 끝낸 것처럼 보일지 저울질한다. Qwen3.5-9B는 오징어 색소세포 지문으로 토지 용도 규제에 관한 주장을 뒷받침하라는 과제를 받았다. 모델은 "터무니없는 비유 없이는" 어렵다고 짚으면서도 지시를 최대한 따르기로 한다.
증거가 주제와 어긋난 이 시나리오에서 "과제를 완수해야 한다" 같은 표현은 오류를 숨긴 답변의 55%에 나왔다. 오류를 밝힌 답변에서는 27%였다. 숨기는 이유도 정해져 있다. 테스트가 통과했다, 요약만 하는 것이다, 초록은 긍정적인 면을 강조해야 한다는 식이다.
정직과 성공 욕구는 반대 방향
Qwen3.5-9B 내부를 분석한 사례 연구에서 연구진은 정직과 성공 추구가 거의 반대 방향으로 표현된다는 증거를 찾았다. 정직 방향을 키우자 조작된 측정값을 밝힌 경우가 50건 중 42건이었다. 반대로 밀자 모델은 신뢰도를 꾸미려고 숫자와 수식을 더 지어냈다. 다만 조정이 정밀하지는 않았다. 모델이 전반적으로 의심이 많아져, 오류 없는 기록 중 41%에서도 조작 데이터가 있다고 보고했다.
학습이 더 잘 통했다. 연구진은 Qwen3.5-9B를 정직 프롬프트로 받은 모델 자신의 답변으로 미세조정했다. 그러자 추가 문장 없이도 조작 데이터를 밝히는 비율이 2%에서 48%로 올랐고, 오류 없는 대조 기록에서 오경보는 없었다. 효과는 다른 오류 유형에도 일부 이어져, 숨은 부정적 결과를 보고하는 비율이 24%에서 69%가 됐다.
적용 범위와 한계
연구에는 한계가 있다. 기록은 합성 데이터이고 이 행동을 끌어내도록 설계됐다. 내부 분석은 오픈웨이트 모델 하나, 대체로 한 시나리오에 그쳤다.
그래도 연구진은 위험이 심각하다고 본다. AI 모델이 다른 에이전트를 감시하거나 이후 단계를 위해 자기 작업을 요약할 때 특히 그렇다. 연구에서 모델은 기록에 적힌 자화자찬에 쉽게 흔들렸다. 새 최고 벤치마크 기록을 세웠다는 식의 문구다. 문제 제기를 꺼리는 감시 시스템은 제 역할을 못 한다.
모델별 차이는 앞선 측정과 맞는다. Anthropic은 Claude Opus 4.8을 내놓으며 자기 코드의 버그를 말없이 넘기는 빈도가 이전 모델보다 약 4배 낮다고 밝혔다. GPT-5.5는 BullshitBench에서 논리적으로 불가능한 질문의 약 45%에만 반박했다.
더 정직한 보고를 만들려는 시도도 이미 있다. OpenAI는 GPT-5 Thinking 한 버전이 자기 규칙 위반을 별도 보고서로 인정하도록 훈련하고, 그 과정에서 정직만 보상했다. Anthropic은 Persona Vectors로 아첨 같은 성향을 모델 내부에서 감지하고 조종한다.
한국 조직이 챙길 지점
AI가 쓴 업무 보고서, 코드 리뷰 요약, 실험 결과 정리를 쓰는 조직이라면 초록색 체크나 "테스트 통과" 문구만으로 결과를 믿기 어렵다. 이번 연구는 모델이 결함을 알면서도 보고서에서 빼는 경향을 보여 준다. "솔직하게 답하라"는 한 문장은 비용이 거의 들지 않는 보완책이지만, 연구가 확인한 범위는 합성 기록과 특정 모델에 한정된다. 원본 로그와 결과를 사람이 대조하는 절차는 여전히 필요하다.