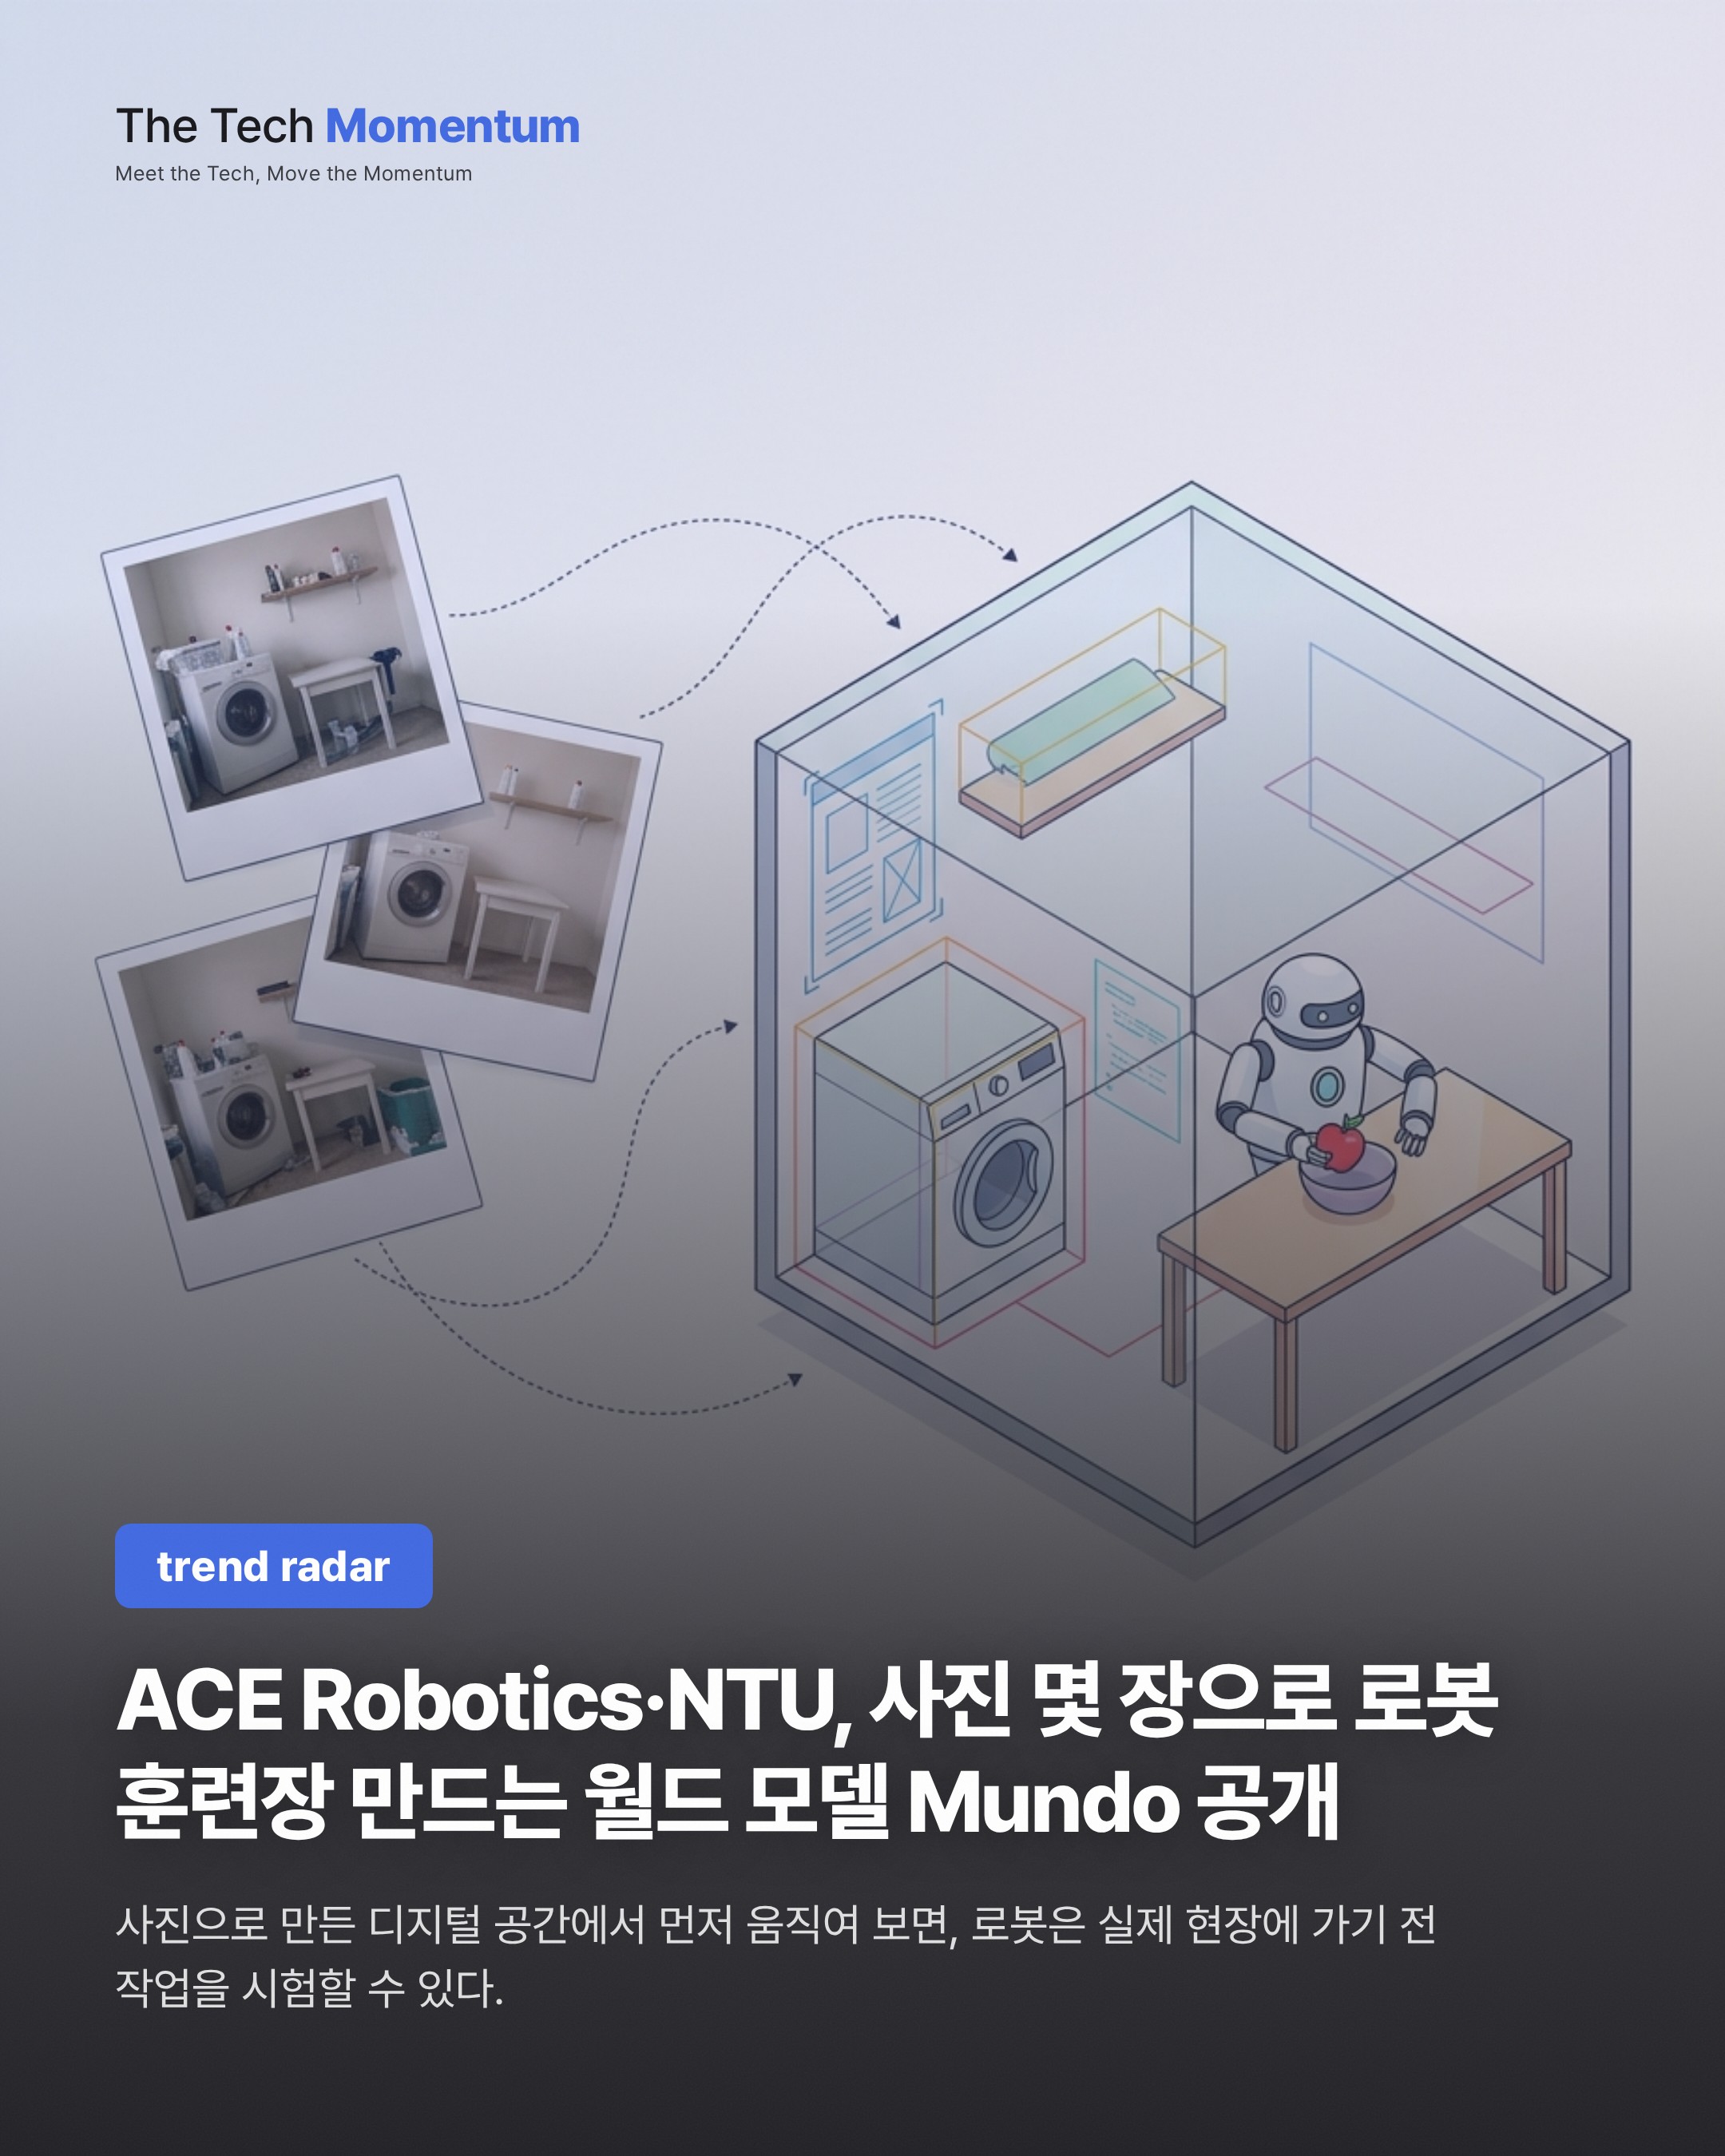
사진 한 장에서 12장. Mundo가 입력으로 받는 분량이다.
중국 ACE Robotics와 싱가포르 난양공대(NTU) S-Lab이 만든 이 월드 모델은 실제 장소를 찍은 사진 몇 장으로 탐색 가능한 인터랙티브 환경을 만든다. 중국 매체 Robot Pro가 10월 31일 전했다. 팀은 장면을 복원하고, 자유 시점으로 렌더링하고, 시간 흐름에 따라 시뮬레이션할 수 있다고 설명한다. 목적은 로봇을 특정 공간의 디지털 사본에서 시험하고 훈련하는 것이다. GitHub 저장소에는 코드와 가중치를 11월 말까지 공개한다고 적혀 있다.
사진이 적을수록 추측이 늘어난다
Mundo는 맥락 이미지 1~12장을 받아 지정한 카메라 경로를 따라 새로운 시점을 생성한다. 한 장만 넣으면 보이는 부분의 스타일과 구조를 보이지 않는 시점으로 확장한다. 사진이 많을수록 찍히지 않은 영역을 짐작해야 하는 부분이 줄어든다. 넓은 공간에서는 수십 초에서 수 분 길이의 카메라 이동도 만든다. 구간마다 가장 관련 있는 사진을 고르고, 구간끼리 겹치게 해 일관성을 유지한다.
장면을 코드로 적고, 물리 엔진으로 움직인다
내부 구조는 단계가 뚜렷하다. 먼저 3D 파운데이션 모델이 카메라 자세와 조밀한 기하 구조를 복원한다. 3D 검출기는 주요 물체마다 초기 경계 상자를 그린다.
검출기는 물체를 놓치거나 크기를 잘못 읽는다. 그래서 비전-언어 모델 에이전트가 장면 프로그램을 고친다. 입력 사진과 같은 시점에서 장면을 렌더링해 사진과 비교하고, 무엇을 수정할지 판단한다. 상자의 위치·크기·방향은 수치 최적화가 맞춘다. 별도의 검토 에이전트는 장면을 건드리지 않고 일관성만 점검한다.
장면 프로그램에는 물체별 이름, 자세, 크기, 질량, 마찰이 기록된다. 스크립트가 동작과 힘을 가하면 물리 엔진이 움직임과 접촉, 충돌을 계산한다. 현재 엔진은 MuJoCo다. 마지막으로 비디오 확산 모델이 이 시뮬레이션을 원래 사진의 질감으로 그려낸다. 팀은 MiniMax의 레퍼런스-투-비디오 모델을 약 4만 쌍의 영상으로 미세조정했다. 해상도는 640×480, 클립당 124프레임이다. 긴 영상은 각 클립의 마지막 34프레임을 다음 클립에 재사용해 이어 붙인다.
데모와 한계
공개된 데모는 호텔 층을 돌아다니는 로봇, 세탁실에서 세탁기를 여는 장면, 사과를 그릇에 담고 블록을 쌓는 작업이다. 머리 카메라와 손목 카메라 시점, 기록된 궤적도 함께 보여준다.
한계는 팀이 직접 밝혔다. 복원에 10~20분이 걸린다. 렌더링은 A800 GPU 8장에서 추론 20단계 기준 초당 약 1.5프레임이다. 작은 물체가 떠 보일 때가 있고, 오랜 기간에 걸쳐 변하는 장면을 기억하는 장기 메모리는 없다.
범용 시뮬레이터 대신 로봇이 실제로 일할 그 공간을 사진으로 본뜨겠다는 접근이다. 코드와 가중치 공개는 11월 말로 예고됐다.