아홉 개 작업이 다섯 번 시도에서 모두 실패했다. 같은 작업을 모델이 계속 환경과 상호작용하도록 놔두자 다섯 번 모두 성공했다. SenseTime이 RoboDojo 벤치마크에서 GPT-6-Astra를 시험하며 확인했다는 장면이다.
공개된 것은 두 가지다
중국 AI 기업 SenseTime은 체화형 AI 평가 프레임워크 SenseNova-RoboRSI와 체화형 모델 SenseNova-RoboRSI-27B-Preview를 함께 오픈소스로 공개했다. 둘의 역할은 다르다.
프레임워크는 평가 도구다. 벤치마크마다 의존성을 묶어 별도 Docker 이미지로 패키징하고, 환경 상호작용과 기본 채점을 통합 HTTP API로 제공한다. SenseTime에 따르면 연구자는 설정 파일 하나로 시뮬레이터를 일일이 세팅하지 않고 전 과정 평가를 돌릴 수 있다.
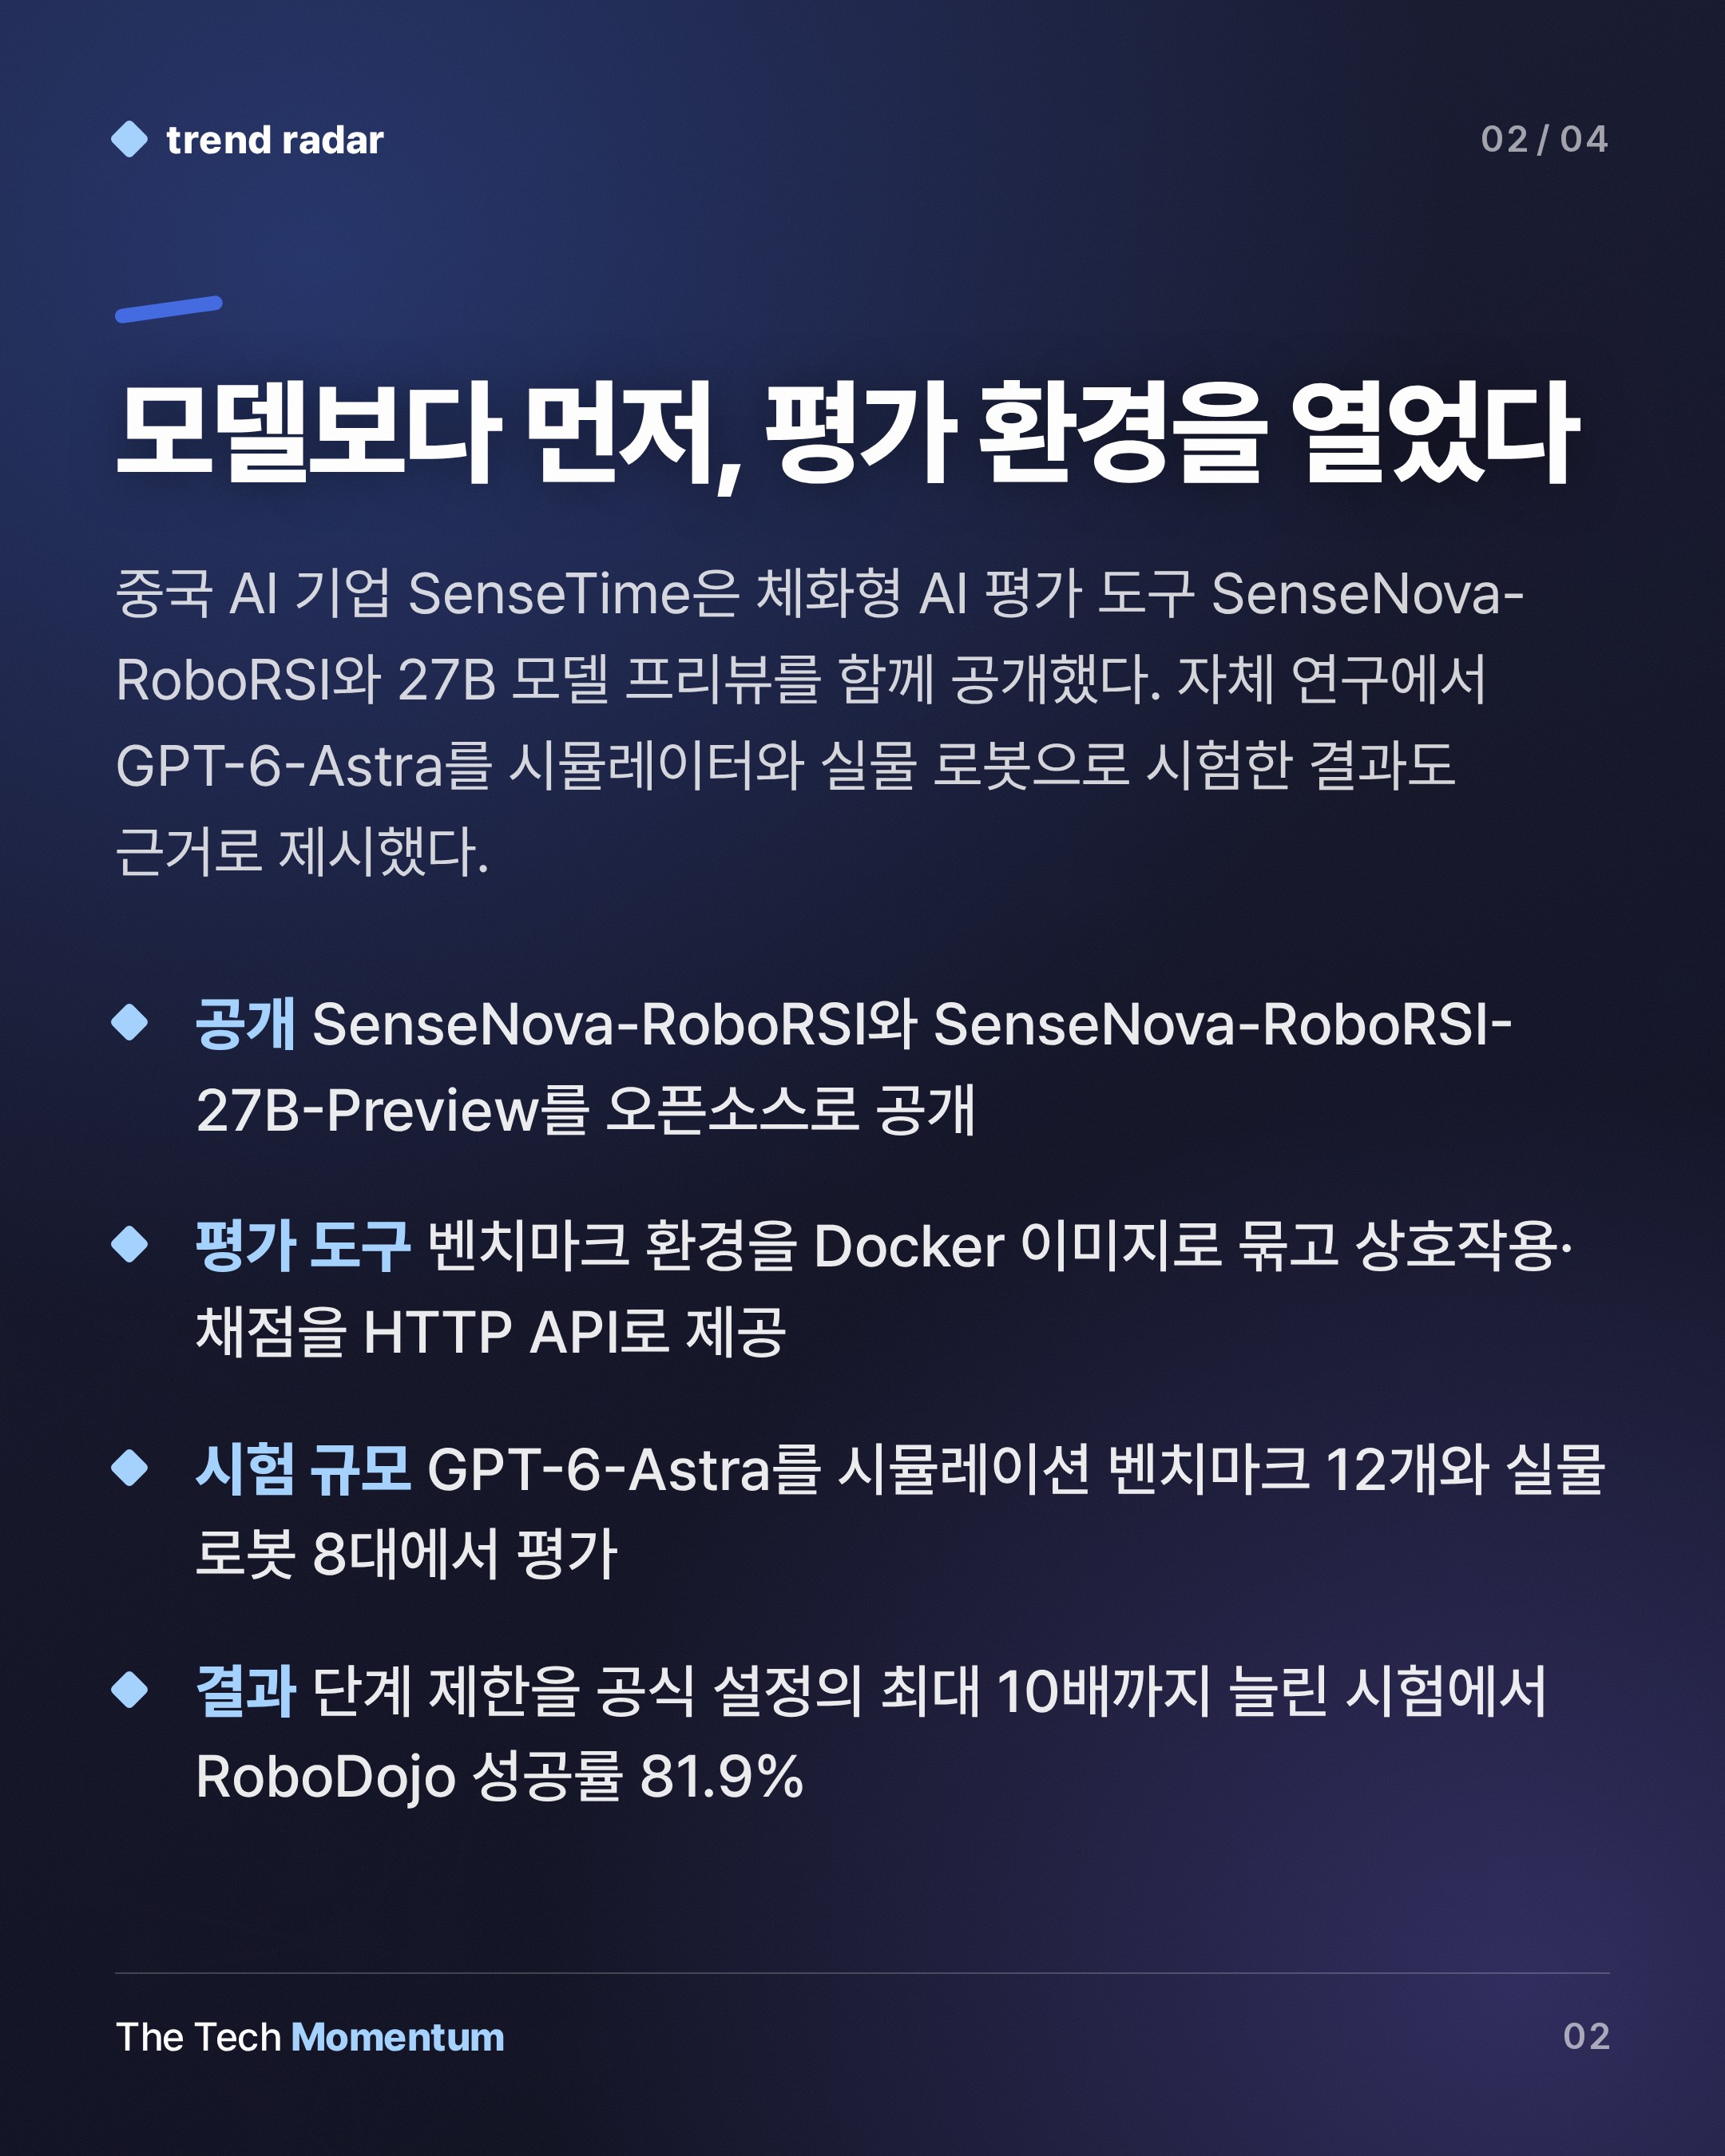
27B 모델은 로봇의 두뇌 역할이다. 시행착오로 얻은 경험을 모델 가중치에 녹여 같은 일을 덜 헤매고 해내도록 만든 모델이다. 이름에 Preview가 붙어 있다.
출발점은 GPT-6-Astra 실험
이번 공개는 SenseTime이 GPT-6-Astra를 시뮬레이션 로봇 벤치마크 12개와 실물 로봇 8대에서 시험한 연구에 뒤이어 나왔다. SenseTime에 따르면 학습용 시연 데이터를 주고 단계 제한을 공식 설정의 최대 10배까지 늘리자 LIBERO와 SIMPLE 벤치마크가 포화됐고, RoboDojo 성공률은 81.9%에 이르렀다.
비용은 만만치 않았다. 확장 예산 테스트에서 그릇 쌓기는 약 131분, 추론 비용 추정 약 19달러(약 3만 원)가 들었다. 펜을 펜꽂이에 넣는 작업은 263분, 약 55달러(약 7만 원)였다.
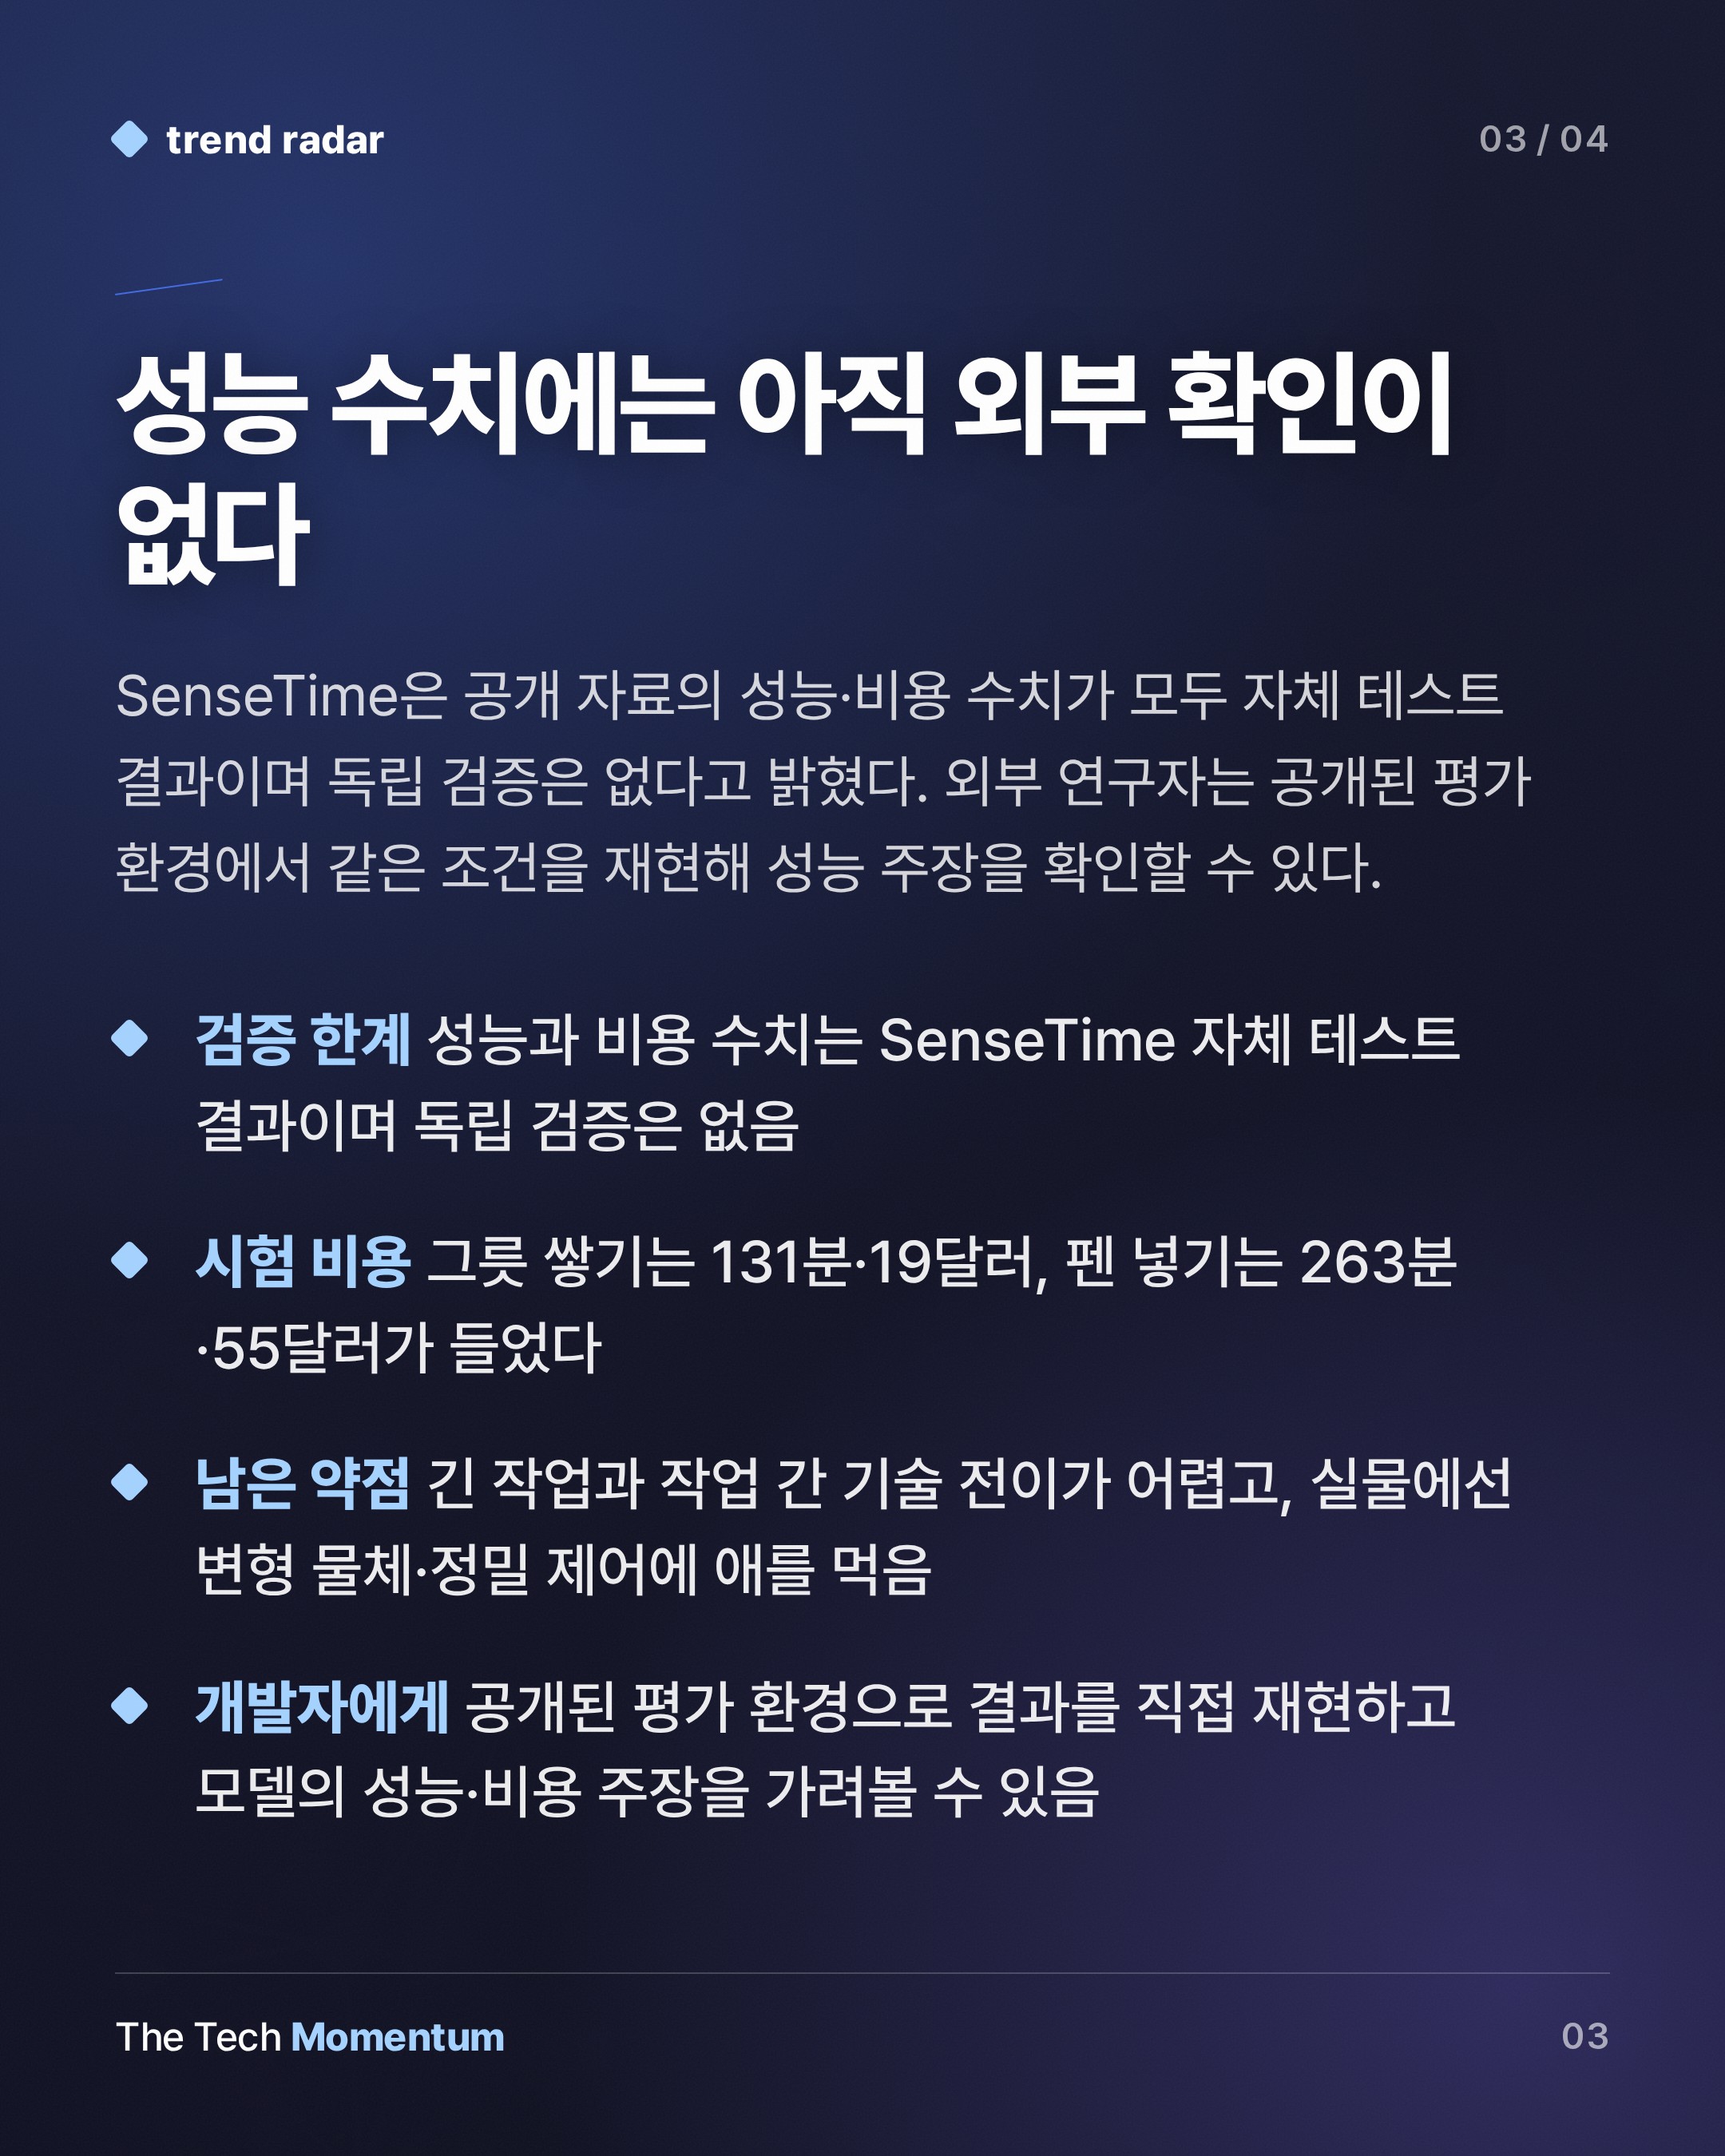
약점도 같은 연구에서 나왔다. GPT-6-Astra는 긴 호흡의 작업에 가장 약했고, 작업 간 기술 전이가 어려웠다. 실물 로봇에서는 변형되는 물체와 정밀 제어에서 애를 먹었다.
느린 추론과 빠른 행동을 묶어 봤다
SenseTime은 느린 추론 모델과 빠른 행동 모델을 짝지어 보기도 했다. 결과를 매번 점검하는 폐루프를 얹은 최고 조합은 RoboDojo 42개 작업에서 54% 성공률을 냈다. 다만 SenseTime 스스로 비용이 여전히 문제라고 밝혔다.
27B 모델의 성적은 이렇다. RoboDojo 점수 26.13에 작업 성공률 20.83%, LIBERO-Pro 90점 이상이다. RoboCasa365 성공률은 26.0%에서 46.5%로 올랐고 토큰 사용량은 73% 줄었다. SenseTime은 GPT-6-Astra의 50분의 1 비용으로 체화형 작업을 완수한다고 주장한다.
근거와 주장을 가르면
이 글의 모든 수치는 SenseTime 자체 테스트에서 나왔다. 어떤 결과도 독립적으로 검증되지 않았다. 확인 가능한 것은 프레임워크와 모델 프리뷰가 공개됐다는 사실이고, 성능과 비용 우위는 아직 회사 측 주장이다. 그래서 프레임워크 공개의 의미가 크다. 외부 연구자가 같은 환경에서 직접 재현해 볼 수 있기 때문이다.
SenseTime은 앞으로의 체화형 벤치마크가 실제 인간의 필요를 중심으로 설계돼야 하고, 로봇이 상호작용으로 배우게 해야 하며, 생각하는 시간도 현실의 시간으로 쳐야 한다고 주장한다. 모델이 고민하는 동안에도 팬은 계속 달아오르기 때문이다.
체화형 AI를 개발하는 국내 연구자와 개발자에게는 평가 환경 구축 부담을 덜어 줄 도구이자, 모델 공개 범위를 직접 살펴볼 수 있는 사례다.