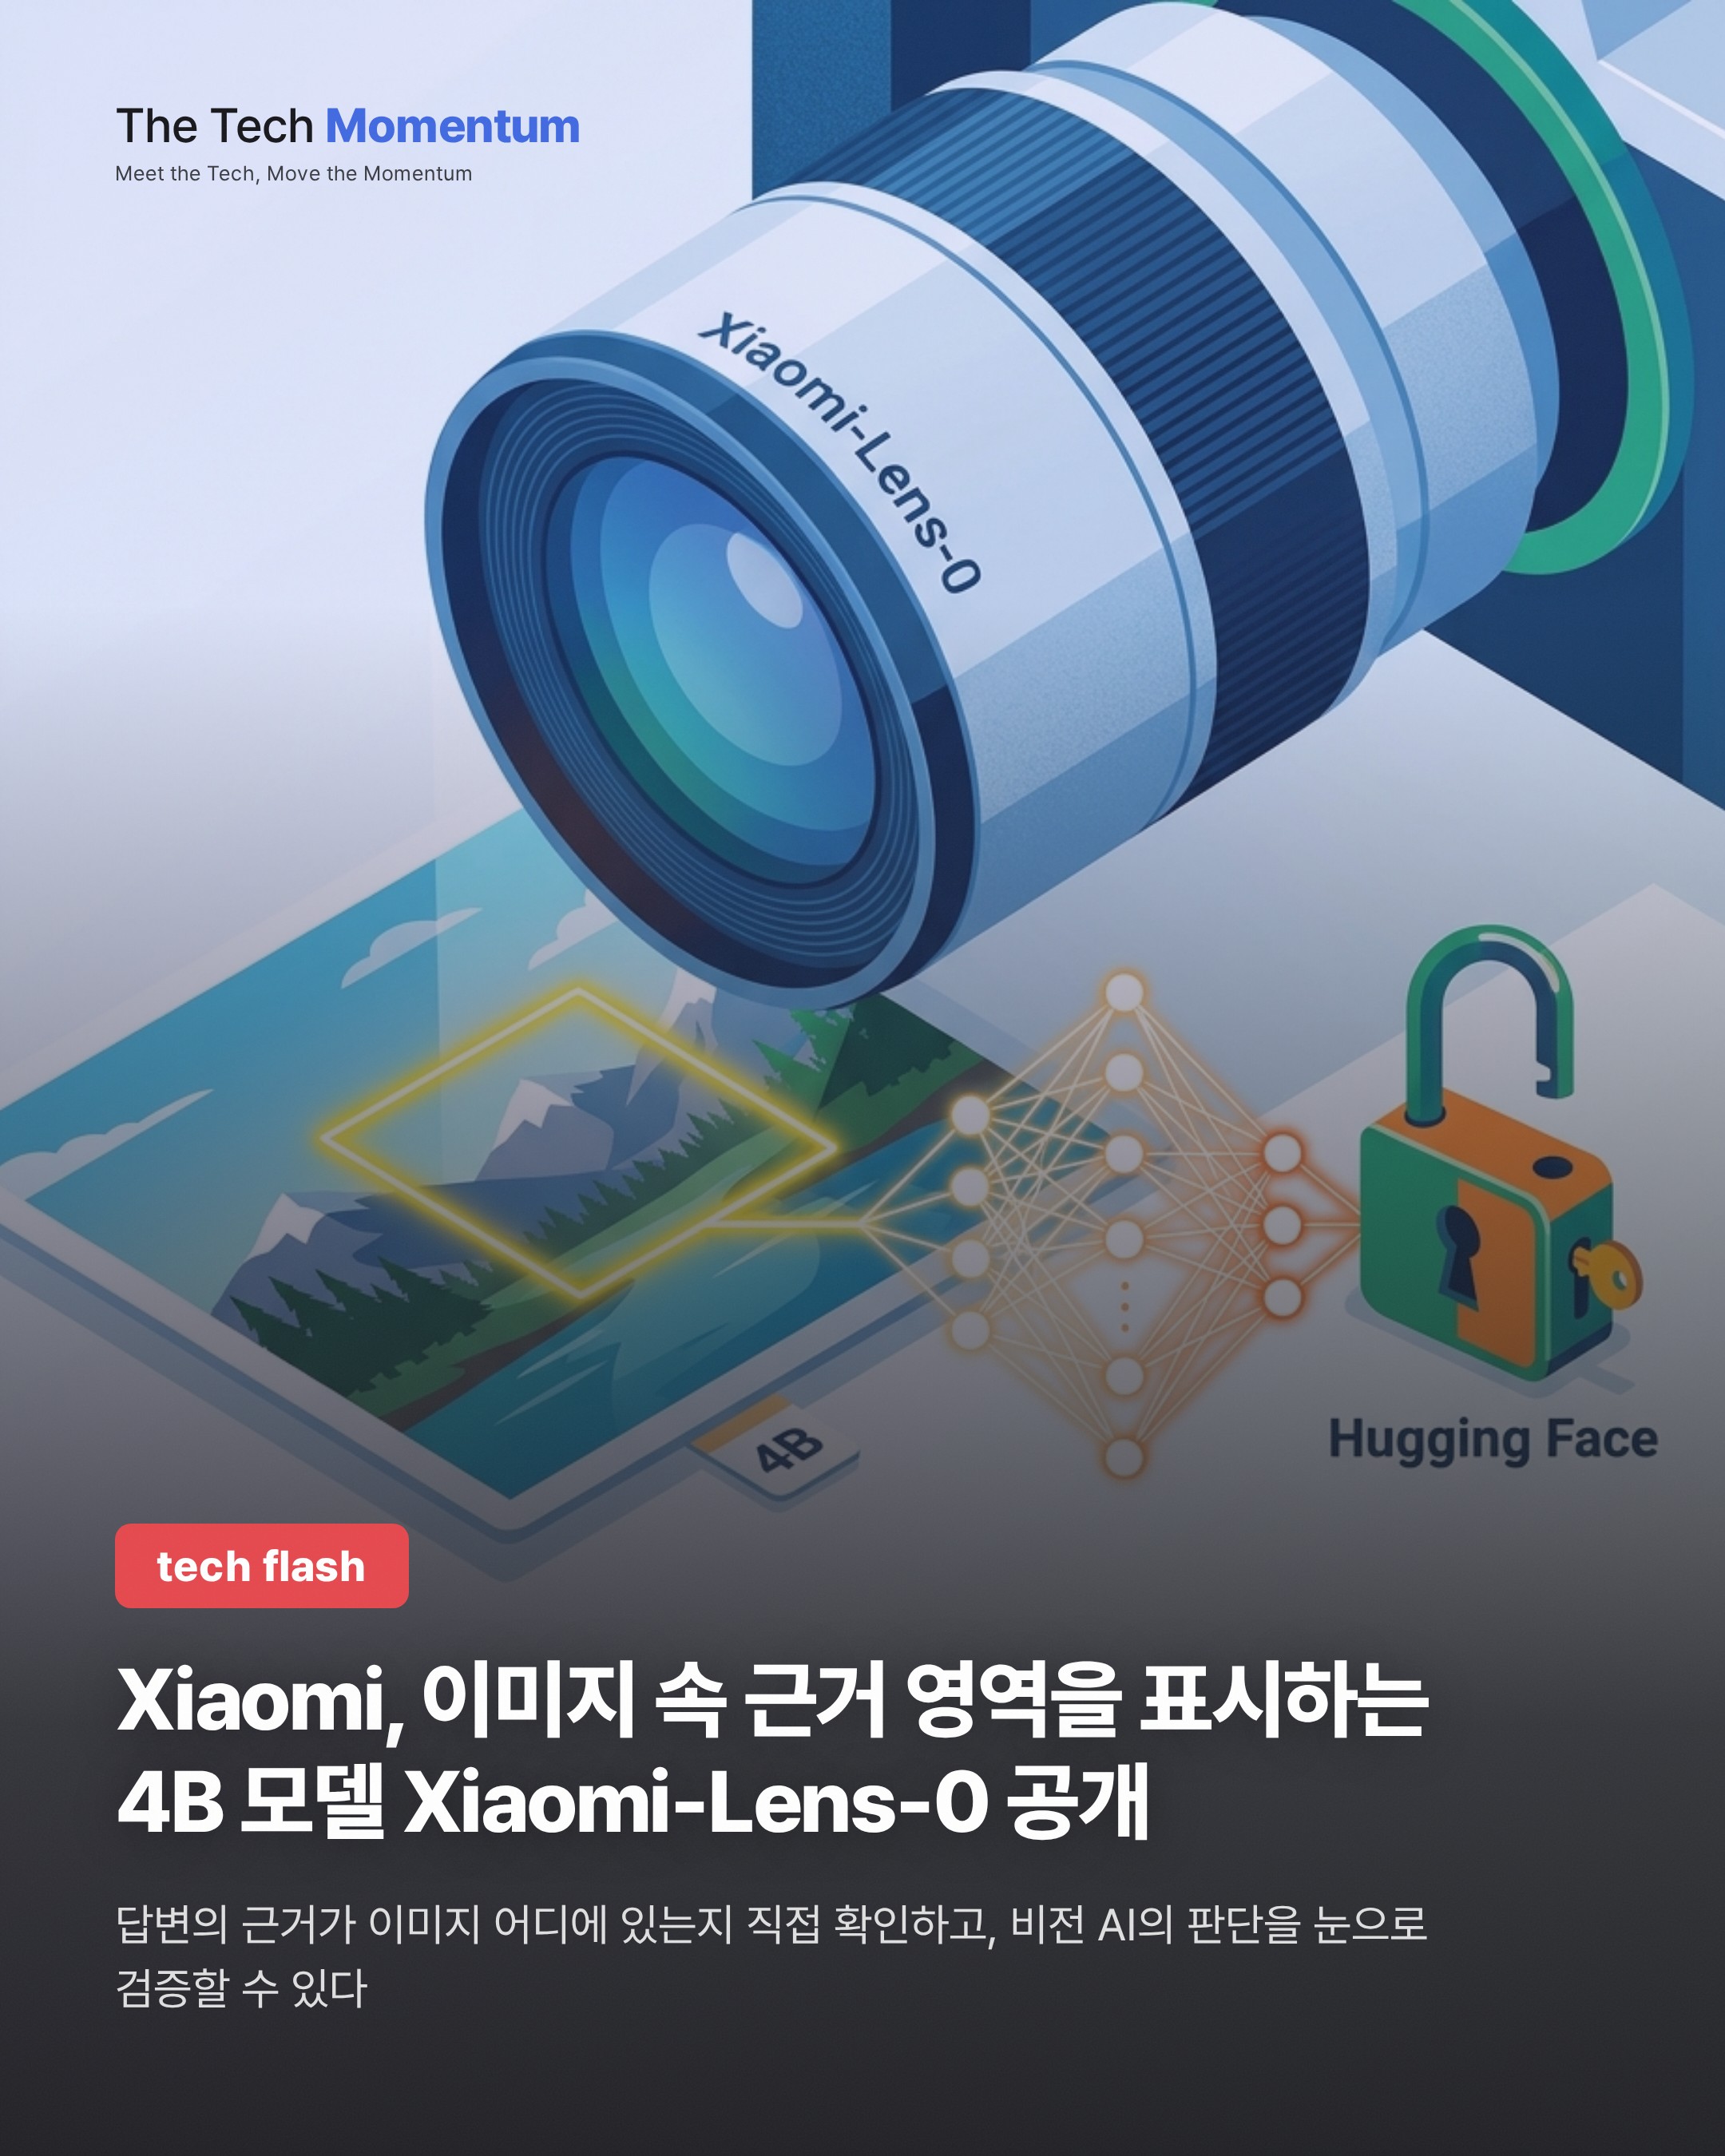
중국 기업 Xiaomi가 답변과 함께 이미지 속 해당 영역을 마스크로 표시하는 40억(4B) 파라미터 멀티모달 모델 Xiaomi-Lens-0를 오픈소스로 공개했다. 라이선스는 Apache 2.0이다.
핵심 정보 한눈에
- 규모: 약 4B 파라미터
- 기반 모델: Qwen3.5-4B에 경량 픽셀 마스크 디코더를 추가
- 라이선스: Apache 2.0
- 가중치: Hugging Face의 SeerRay-Lab 조직
- 코드·논문: GitHub, arXiv 기술 보고서
- 함께 공개: 분할 벤치마크 LensBench, 데모
작동 방식: 마스크 토큰이 영역을 가리킨다
모델이 특수한 마스크 토큰을 출력하면, 그 토큰의 시각 잠재 표현이 이미지 위 분할 마스크로 디코딩된다. 잠재 표현마다 영역이 하나씩 대응하므로, 최종 답변뿐 아니라 사고 과정(chain-of-thought) 중간에도 텍스트와 영역 표시를 번갈아 낼 수 있다.
지원 과제는 다음과 같다.
- 지칭 표현 이해·분할
- 다중 인스턴스 그라운딩
- 추론 분할
- 물건을 건네달라는 식의 로봇 지칭(embodied referring)
- 세밀한 시각 인식
성능: 저자 평가 기준
기술 보고서에 따르면 RefCOCO, RefCOCO+, RefCOCOg 지칭 분할 8개에서 Qwen3.5 기반 모델보다 평균 5.6점 높다. CountQA는 6.8점 올랐고, 보고서가 비교한 모델 가운데 분할 cIoU가 가장 높다고 밝혔다. 모두 저자가 직접 낸 평가 결과다.
배포 구성과 소속
공개 패키지에는 가중치, 설정 파일, 토크나이저, 프로세서가 들어 있다. 다만 로딩과 마스크 디코딩에는 별도 Xiaomi-Lens 패키지가 필요하다. 표준 Transformers 클래스만으로는 구동되지 않는다.
SeerRay-Lab은 Xiaomi 거대언어모델 응용팀 산하 시각 이해 그룹이다. 모델 카드와 보고서는 Xiaomi Corporation을 수정 주체로 명시한다. 외부 포크가 아니라 Xiaomi의 연구 공개물이다.
국내 개발자에게
답이 이미지의 어느 부분에서 나왔는지 마스크로 확인할 수 있어, 근거 검증이 필요한 비전 응용에 시험해볼 만하다. 4B 규모라 로봇 집기, 차량 내 어시스턴트, 휴대전화 시각 도우미 같은 엣지 실험에 쓸 수 있다고 소스는 설명한다. Apache 2.0이라 상용 검토도 가능하다.