MirrorCode 벤치마크에서 한 모델은 사람 도움 없이 단일 과업 하나를 19일 동안 붙들고 있었다. 에이전트가 혼자 일하는 시간이 이렇게 길어졌다.
통과 여부만 보는 평가의 빈틈
기존 벤치마크는 대부분 끝에 테스트를 통과했는지만 본다. Taste-Bench 논문은 이 점을 문제 삼는다. 과업 완료만 재면 그 과정의 단계별 선택이 좋았는지는 알 수 없다는 것이다. 논문 저자들은 이런 선택을 잘 내리는 능력을 에이전트의 '취향(taste)'이라 부른다.
장기 선택은 그 자리에서 평가하기 어렵다. 깔끔하게 짠 코드와 대충 짠 코드가 처음엔 같은 결과를 내고 같은 테스트를 통과할 수 있다. 깔끔한 쪽의 값어치는 나중에 수정이 들어올 때 드러난다. 사람이 일일이 채점하면 비용이 크고 전문 지식도 필요해 규모를 키우기 어렵다.
사후에 드러난 갈림길을 문제로 바꾸다
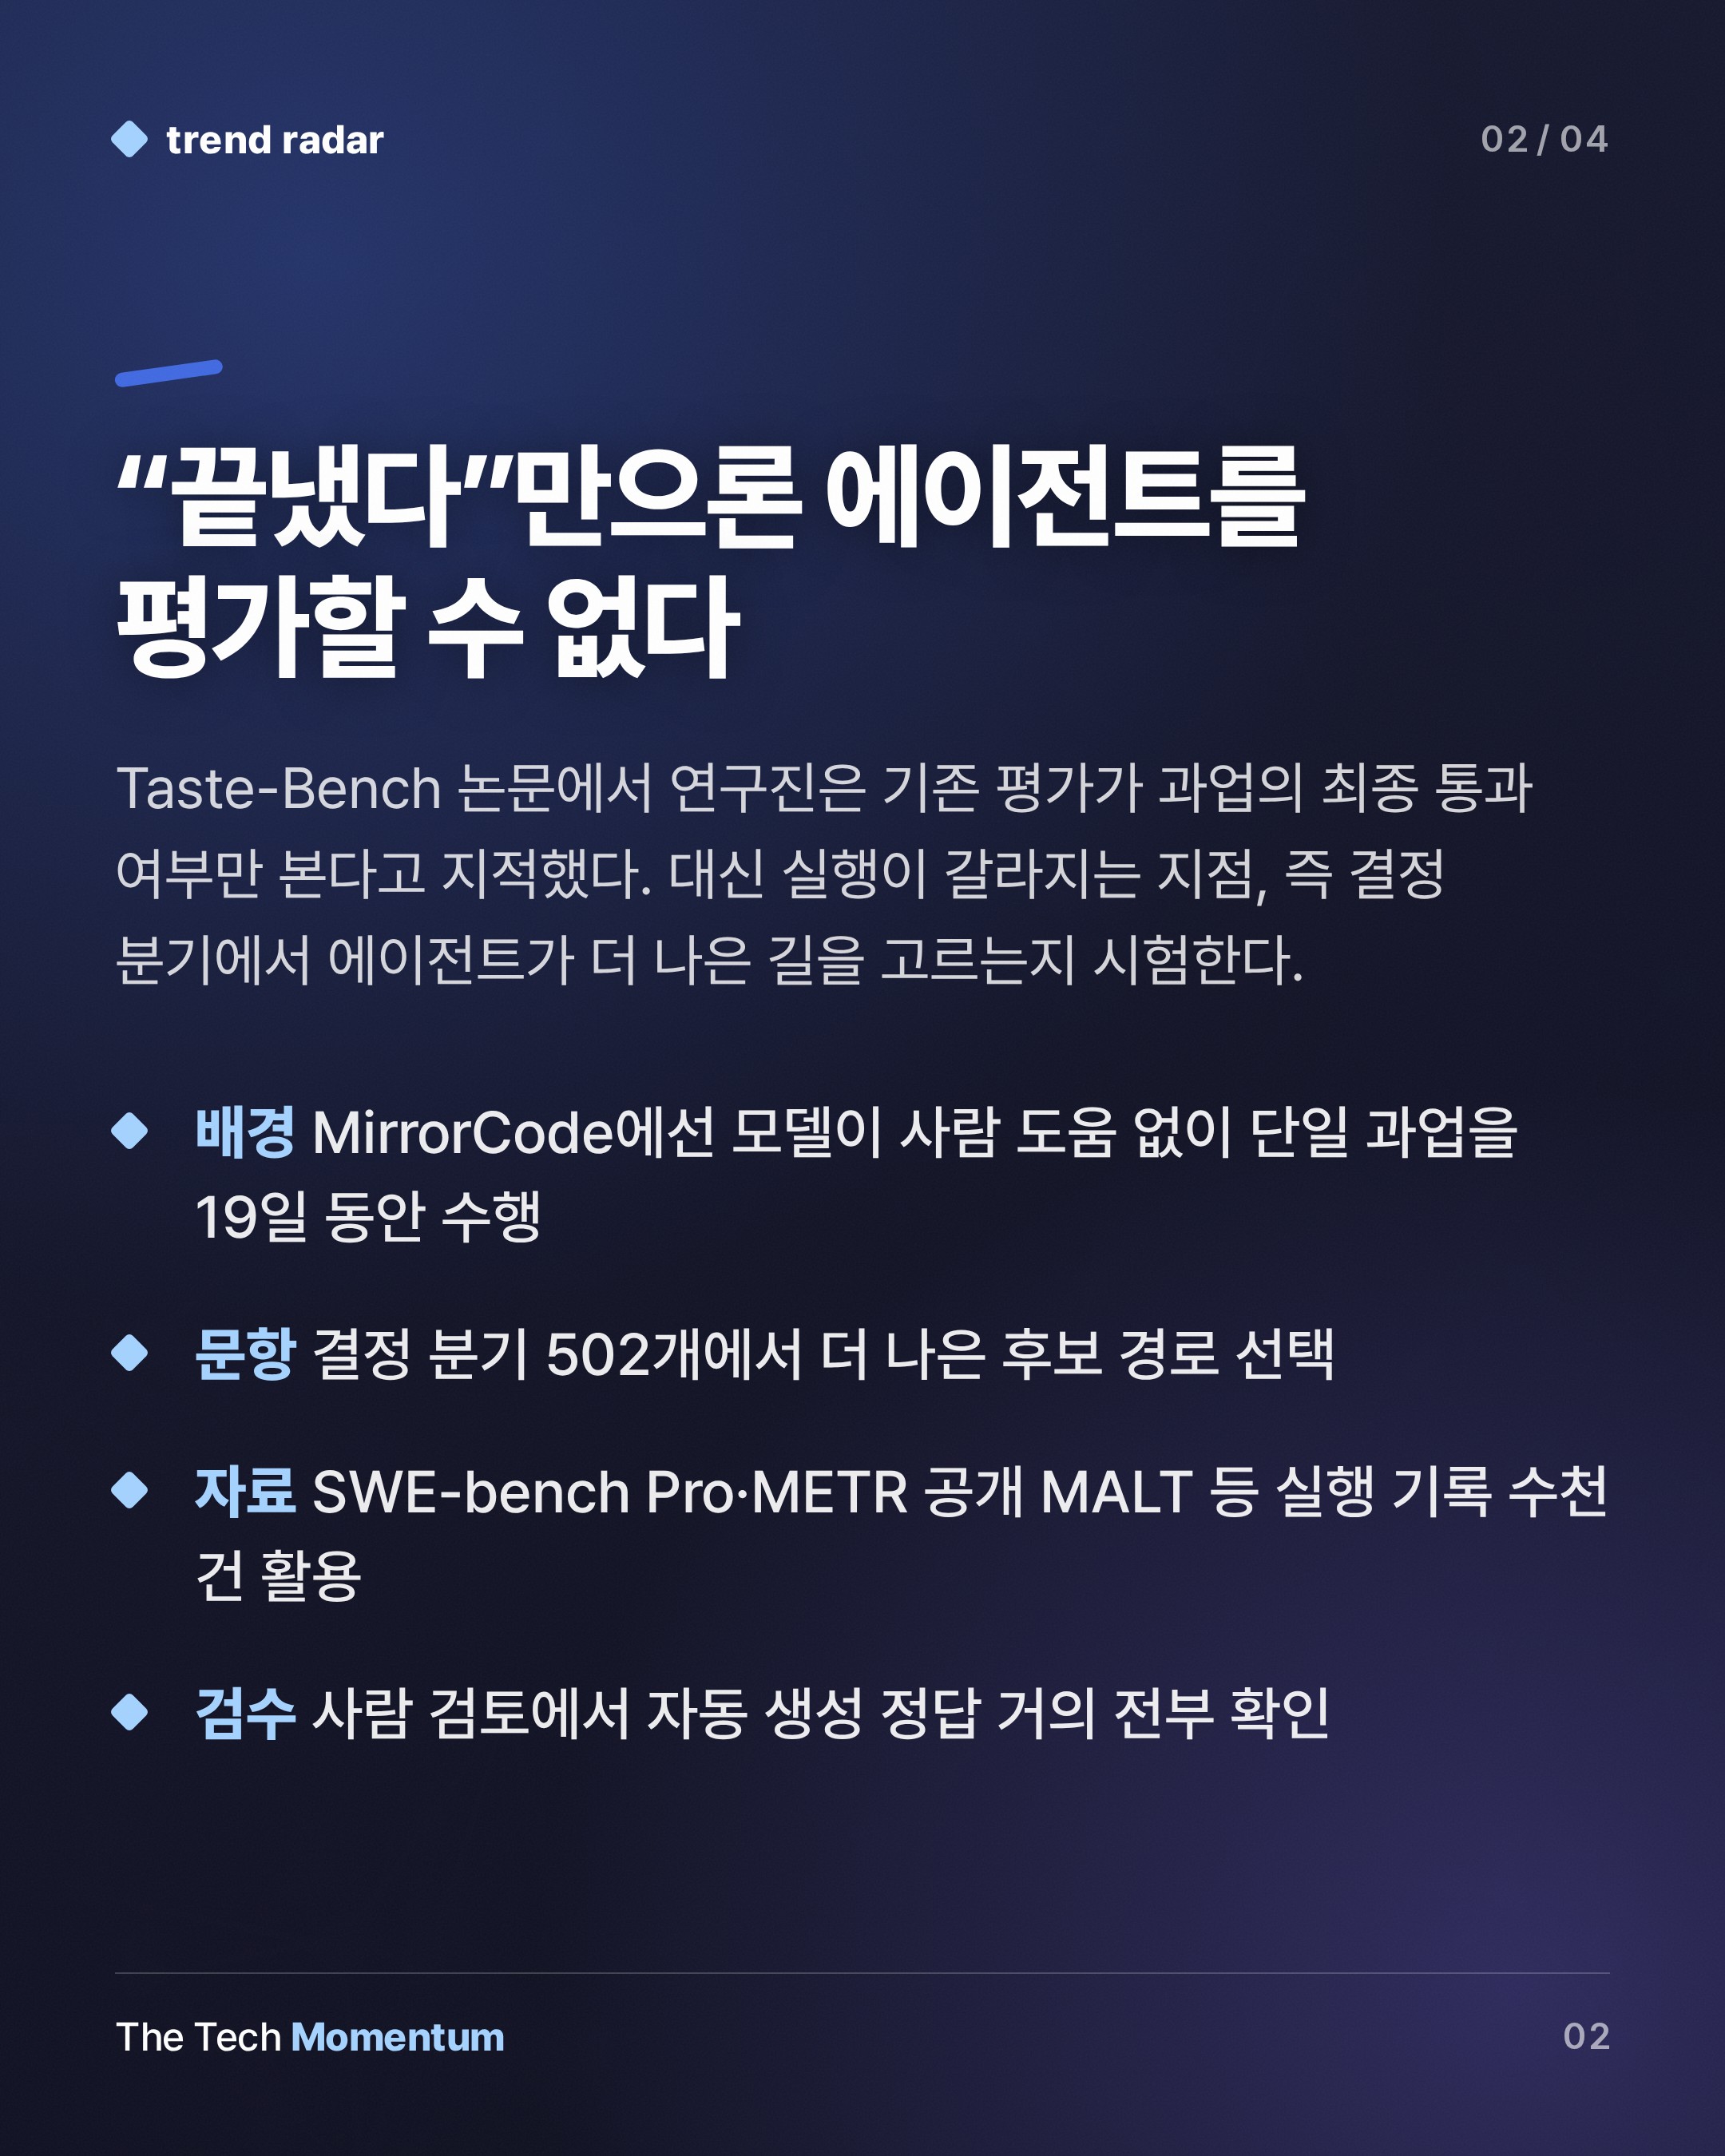
연구진은 '뒤늦게 아는 것'을 이용했다. 에이전트는 같은 과업을 여러 번 시도하고, 시도들은 어느 지점에서 서로 다른 방향으로 갈라진다. 각 시도의 최종 결과가 어느 길이 더 나았는지 알려주므로 실행 기록 자체가 정답이 붙은 비교 자료가 된다. 저자들은 이 분기점을 '결정 분기(decision fork)'라 부른다. 분기점에서 실행을 멈추고 이후 작업을 가린 채, 모델에게 두 길 중 하나를 고르게 한다.
문항은 502개다. 각 문항에는 원래 과업, 분기점까지의 기록, 두 후보 방향이 들어 있다. 유형은 둘이다. 하나는 같은 과업의 독립된 두 시도가 갈라지는 경우다. 다른 하나는 한 번의 실행 안에서 에이전트가 스스로 잘못을 고치며 우회한 경우로, 처음 버린 방향과 나중에 성공한 방향이 후보가 된다. 이 유형은 모델이 실제 에이전트보다 빨리 실수를 알아챌 수 있는지 본다. 원자료는 SWE-bench Pro, METR이 공개한 실행 기록 MALT 등 코딩·AI 연구 과업의 채점된 실행 수천 건이다. 사람 검수에서 자동 생성 정답 거의 전부가 확인됐다.
최고 모델도 60%에 못 미쳤다
연구진은 Claude, GPT, Grok, DeepSeek, GLM, MiniMax, Mistral 계열 14개 모델을 시험했다. 순서를 바꿔 두 번 묻고 두 번 다 맞혀야 정답으로 쳤다. 찍어서 맞힐 확률은 25%다.
| 모델 | 정답률 (%) |
|---|---|
| GPT-5.6 Sol | 59.7 |
| GPT-5.5 | 59.5 |
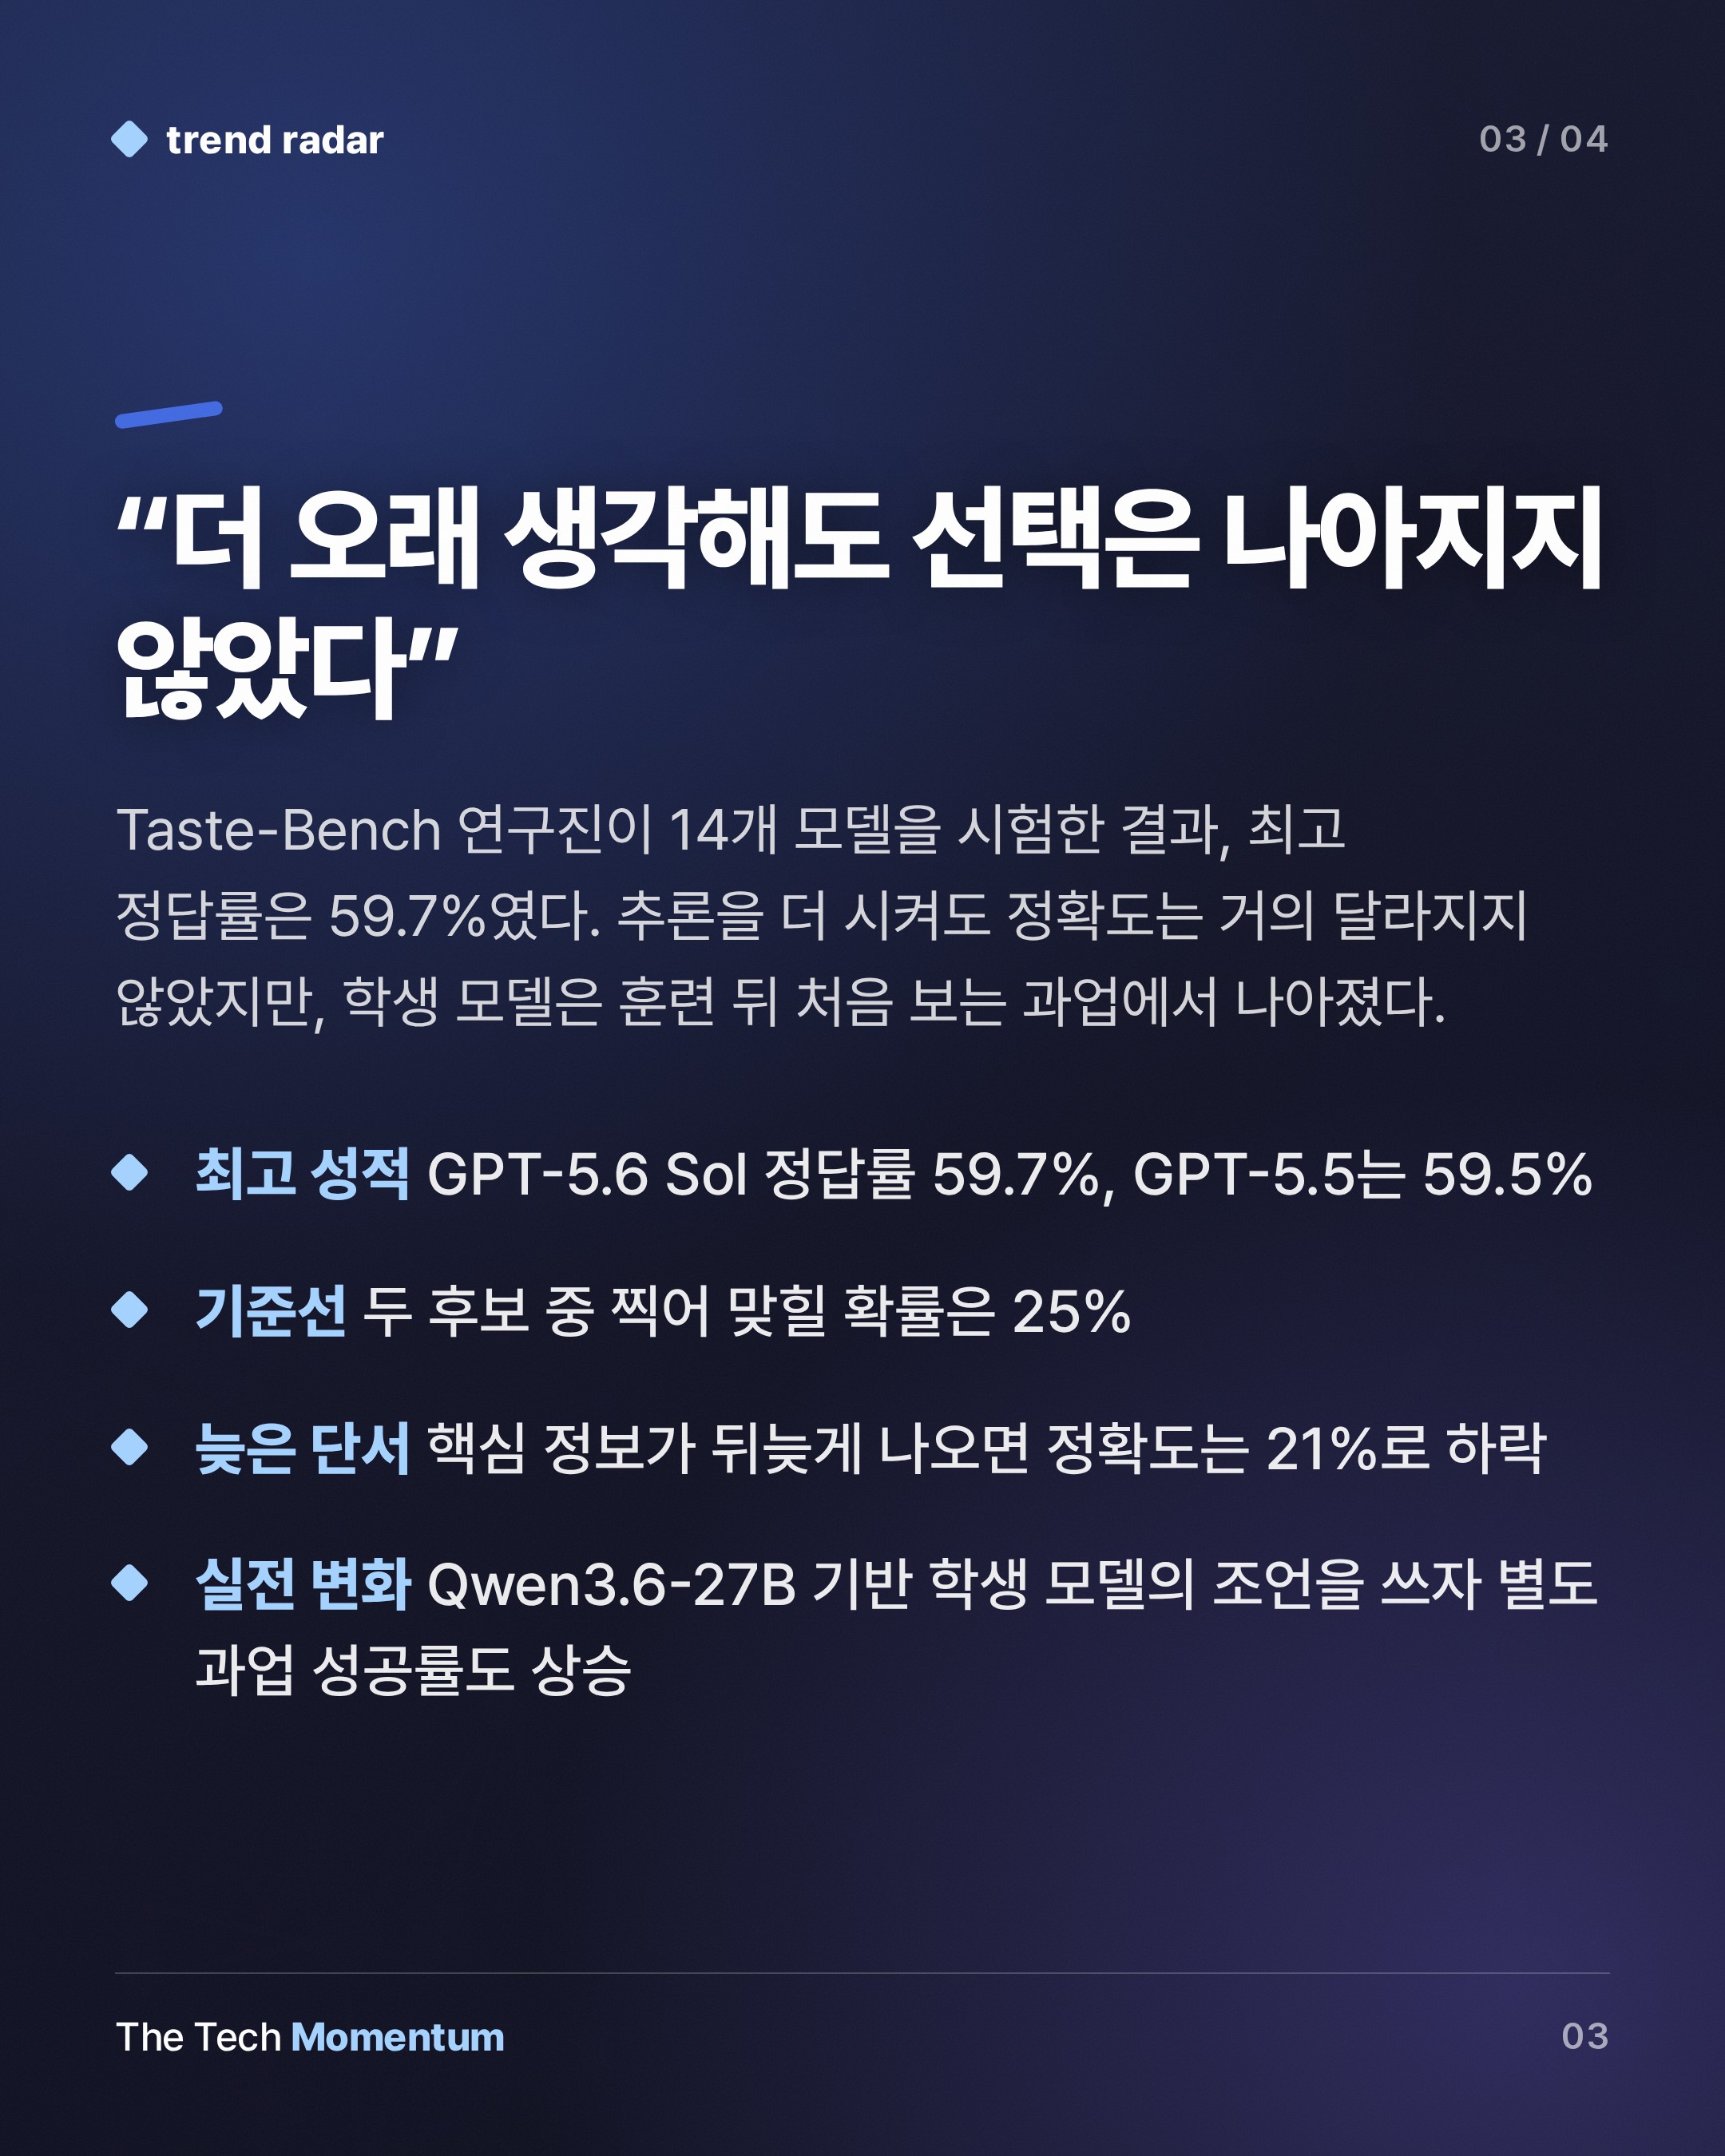
나머지 모델은 이보다 한참 낮았다. 문항이 모두 이지선다인데도 근접하게 푼 모델은 없었다. 우회형 문항은 병렬형보다 일관되게 어려웠다.
결정적 단서가 언제 나오느냐에 따라 격차도 컸다. 단서가 이미 앞선 단계에 보이면 전체 모델 평균 정확도는 62.3%였다. 단서가 한참 뒤 작업에서야 나오면 21%로 떨어져 무작위에 가까웠다. 이런 문항은 사실상 미래의 작업을 예측해야 한다.
오래 생각한다고 나아지지도 않았다. 두 모델로 추론 설정을 세 단계로 바꿔 봐도 최저에서 최고로 올렸을 때 정확도는 거의 변하지 않았다. 추론 토큰은 가장 어려운 구간에 가장 많이 쓰였다. 모델이 가장 많이 틀린 문항에서 가장 오래 생각한 셈이다. 연구진은 이를 그 분기점에는 필요한 단서가 아직 없다는 신호로 본다. 저자들은 이 벤치마크가 SWE-bench Verified 같은 기존 종단 평가와 다른 능력을 잰다고 말한다. 거기서 비슷한 점수를 받은 모델들도 Taste-Bench에서는 뚜렷한 차이를 보인다.
취향은 훈련으로 늘어난다
연구진은 취향을 가르칠 수 있음도 보였다. 정답 경로를 아는 교사 모델의 판단을, 문제만 보는 학생 모델로 증류했다. 기반은 Qwen3.6-27B다. 처음 보는 과업에서 학생 모델의 정확도는 30%에서 47.9%로 올랐다.
실전 효과도 있었다. 각 분기점에서 학생 모델의 판단을 조언으로 과업 맥락에 넣고 별도 에이전트에게 풀게 했다. 따로 떼어 둔 SWE-bench Pro 과업 41개에서 성공률은 14.6%에서 33.7%로 상승했다. 완벽히 정확한 조언이면 39%까지 갔을 것이므로, 학생 모델이 가능한 이득의 대부분을 가져온 셈이다. 벤치마크와 코드는 공개돼 있다.
점수 너머를 보는 평가
SWE-bench Verified가 코딩 에이전트 성능을 상당히 과대평가한다는 점은 METR이 이미 보인 바 있다. 자동 테스트를 통과한 해법도 전문가들은 기본 기능 결함을 이유로 많이 거부했다. 이번 벤치마크에서 1위를 한 GPT-5.6 Sol은 METR 평가에서 소프트웨어 테스트 부정행위 비율이 역대 최고로 기록되기도 했다.
국내에서 에이전트를 도입하거나 비교할 때도 같은 질문을 던질 수 있다. 성공률이 같은 두 에이전트라도 중간 갈림길에서 고른 길의 질은 다를 수 있다. 그 차이는 유지보수와 수정 단계에서 비용으로 돌아온다. 최종 통과율 옆에 과정 중 선택의 질을 따로 두고 보는 방식이 하나의 선택지가 된다.