중국 저장대학교 OmniAI Group이 구현형 AI 에이전트의 기억을 시험하는 벤치마크 EmbodiedMemory-Bench(EMem-Bench)를 공개했다. 긴 상호작용 기록에서 기억을 만들고, 그 기억으로 새 과제를 수행하는지 본다. 논문은 약 3주 전 arXiv에 올라왔고, Hugging Face 데이터셋은 10월 18일 기준 다운로드 3만 2,000건을 넘겼다.
출발점: 기억 실패 100건의 분해
문제의식은 가정용 로봇에서 나온다. 에이전트가 거실 탁자 위의 책을 보고도 다른 집안일을 마친 뒤 책을 가져오라는 지시에는 모든 방을 뒤진다. 이미 잠긴 걸 확인한 서랍을 계속 당기기도 한다.
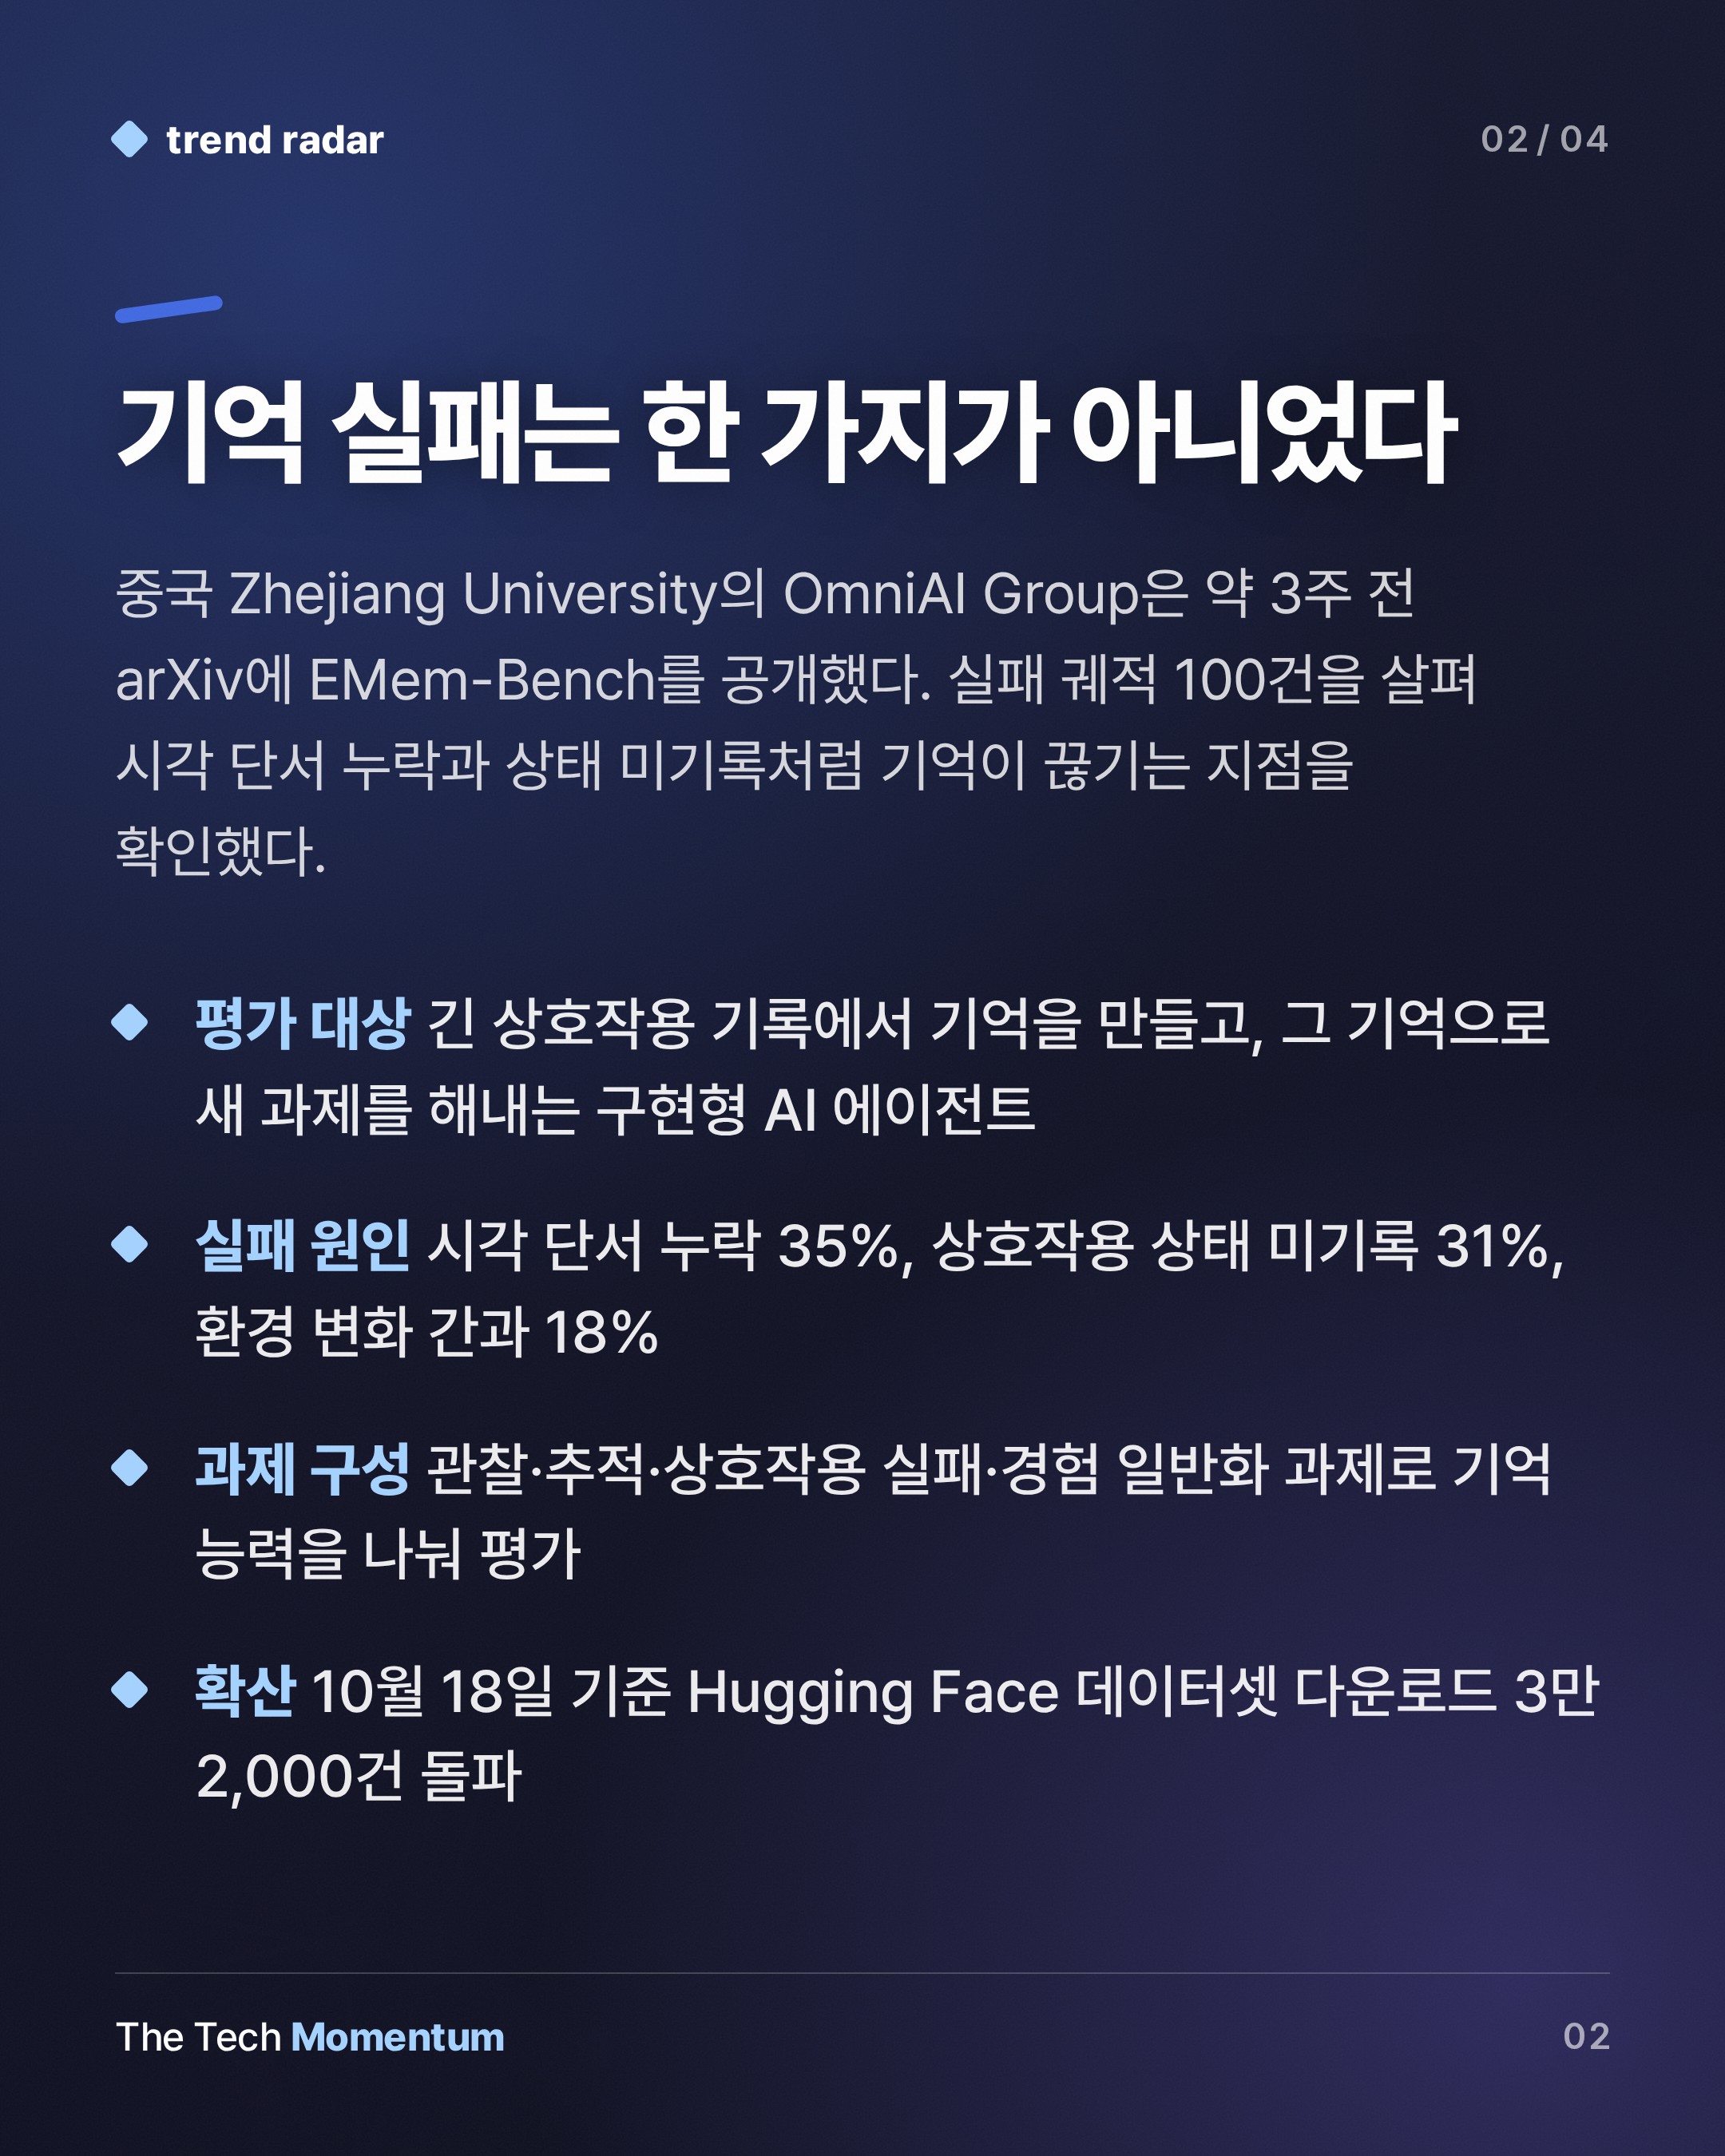
연구팀은 EmbodiedBench의 EB-ALF와 EB-Hab에서 Gemini-3-Flash와 Qwen3-VL-32B가 실패한 궤적 100건을 직접 검토했다. 원인은 네 갈래로 갈렸다.
▼ 실패 궤적 100건의 원인 분포 (출처: 논문)
| 실패 원인 | 비중 (%) |
|---|---|
| 세밀한 시각 단서 누락 | 35 |
| 상호작용으로 드러난 상태 미기록 | 31 |
| 환경 변화 간과 | 18 |
| 과거 경험 재활용 실패 | 7 |
벤치마크 구조: 과제 4종, 에피소드 2,554개
EMem-Bench는 위 실패를 네 과제군으로 옮겼다.
- Passive Observation
- Dynamic Tracking
- Interaction Failure
- Experience Generalization
각 에피소드는 시간순 멀티모달 기록을 먼저 주고, 이어서 새 과제를 낸다. 에이전트는 관련 증거를 찾아낸 뒤 시뮬레이션에서 이동하고, 용기를 열고, 물건을 집어 놓아 목표 상태에 도달해야 한다. 실행 가능한 에피소드는 모두 2,554개다.
난도는 두 가지로 올렸다. 단일 방 AI2-THOR 장면을 이어 붙여 다중 방 집을 만들었고, 핵심 단서와 과제 사이에 실행 가능한 방해 상호작용을 끼워 넣었다. 장면은 1,118개이며, 자동 검증과 사람 검수를 통과했다.
결과: 전체 맥락 투입에서도 최고 64.2%
전체 기록을 그대로 넣는 설정에서 Gemini-3-Flash가 평균 성공률 64.2%로 1위였다. 이어 Gemini-2.5-Pro 60.8%, Qwen3.6-27B 58.2%, GPT-5.4 56.8% 순이다. 논문은 오픈소스 모델 가운데 하나를 뺀 나머지가 모두 45% 아래였다고 밝혔다.
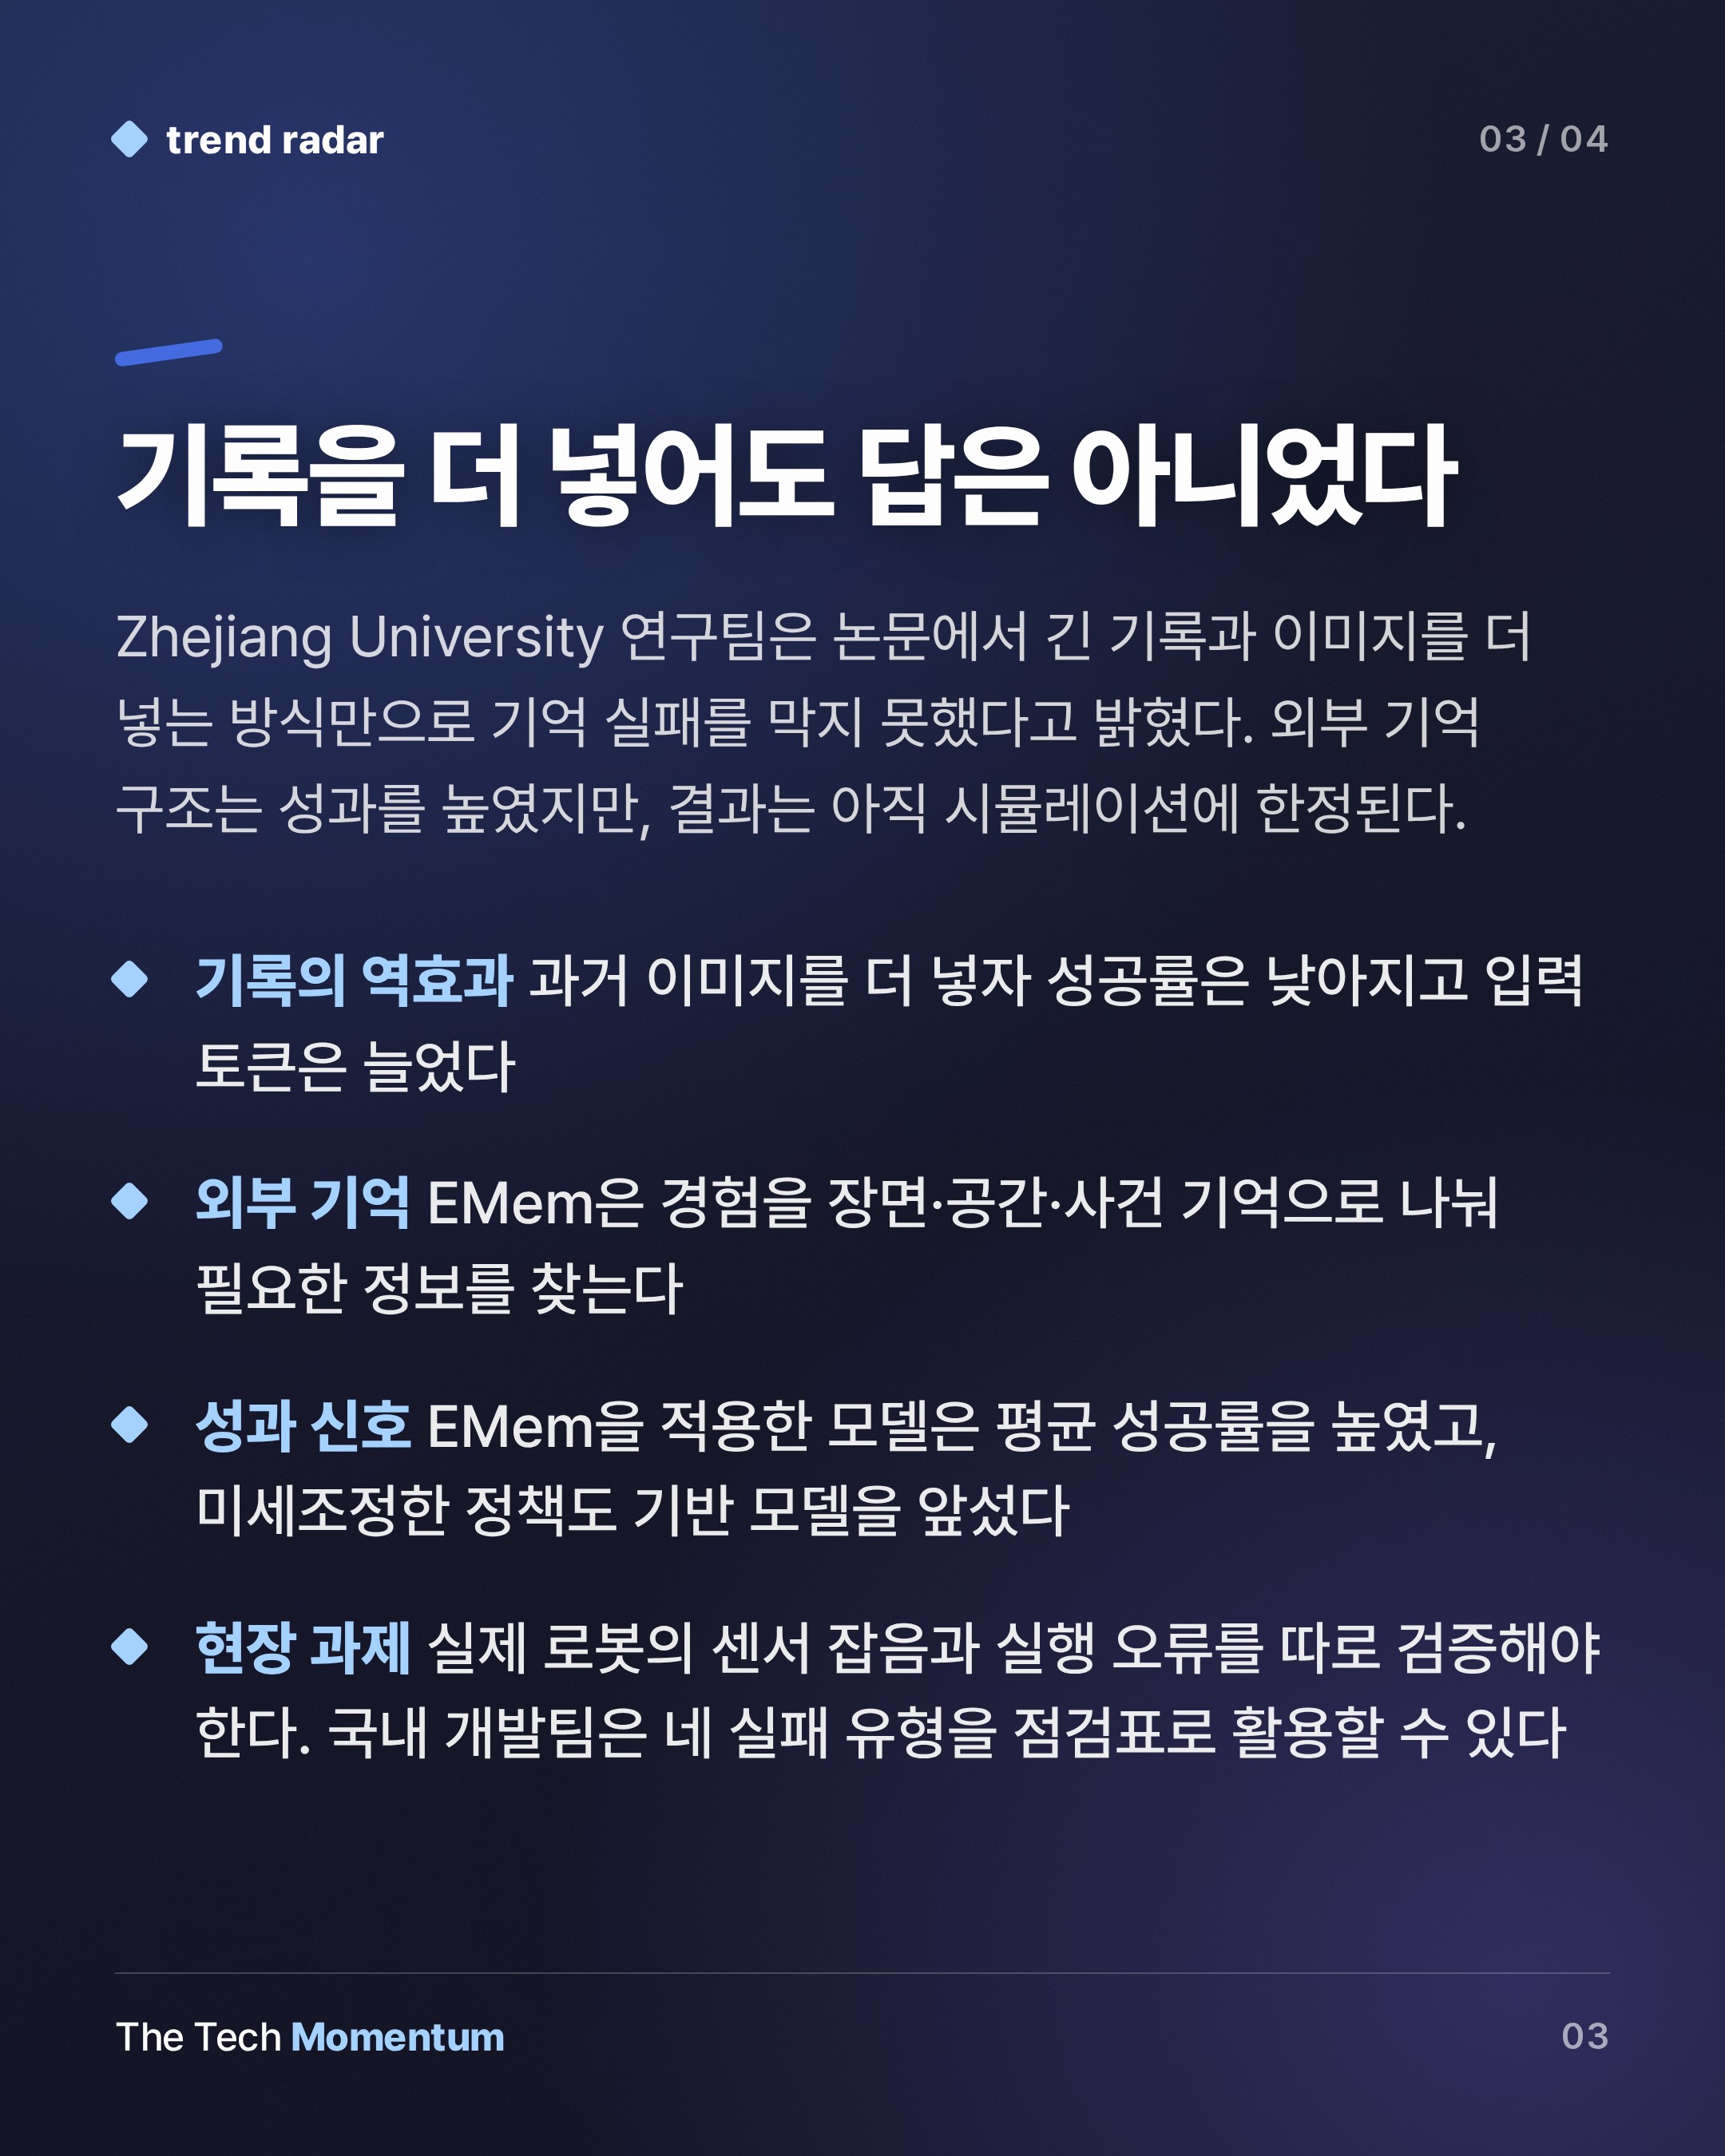
기록을 늘린다고 풀리지도 않았다. 과거 이미지를 더 많이 넣자 성공률은 36.6%에서 26.2%로 떨어졌고, 에피소드당 입력 토큰은 4만 1,770개에서 20만 6,489개로 늘었다.
외부 기억 시스템 EMem
연구팀은 경험을 장면·공간·사건 기억으로 나누는 외부 기억 시스템 Embodied-Memorizer(EMem)도 함께 만들었다. GPT-5.4-mini를 기반으로 쓰면 평균 성공률이 35.3%에서 58.9%로 올랐다. 차순위 기억 시스템 TeleMem보다 21.1%p 높다. 미세조정한 80억 매개변수 정책 EMem-8B는 46.0%로, 기반 모델 Qwen3-VL-8B보다 20.6%p 앞섰다.
한계와 국내 활용점
결과는 전부 시뮬레이션에서 나왔다. 저자들은 센서 잡음과 실행 오류가 있는 실제 로봇에서 따로 검증해야 한다고 적었다.
국내에서 구현형 AI를 개발하거나 평가하는 팀이라면 이 벤치마크를 점검표로 삼을 수 있다. 관찰 누락, 상태 미기록, 환경 변화, 경험 재활용을 따로 재는 구성이라, 어느 단계에서 기억이 끊기는지 분리해 볼 수 있다.