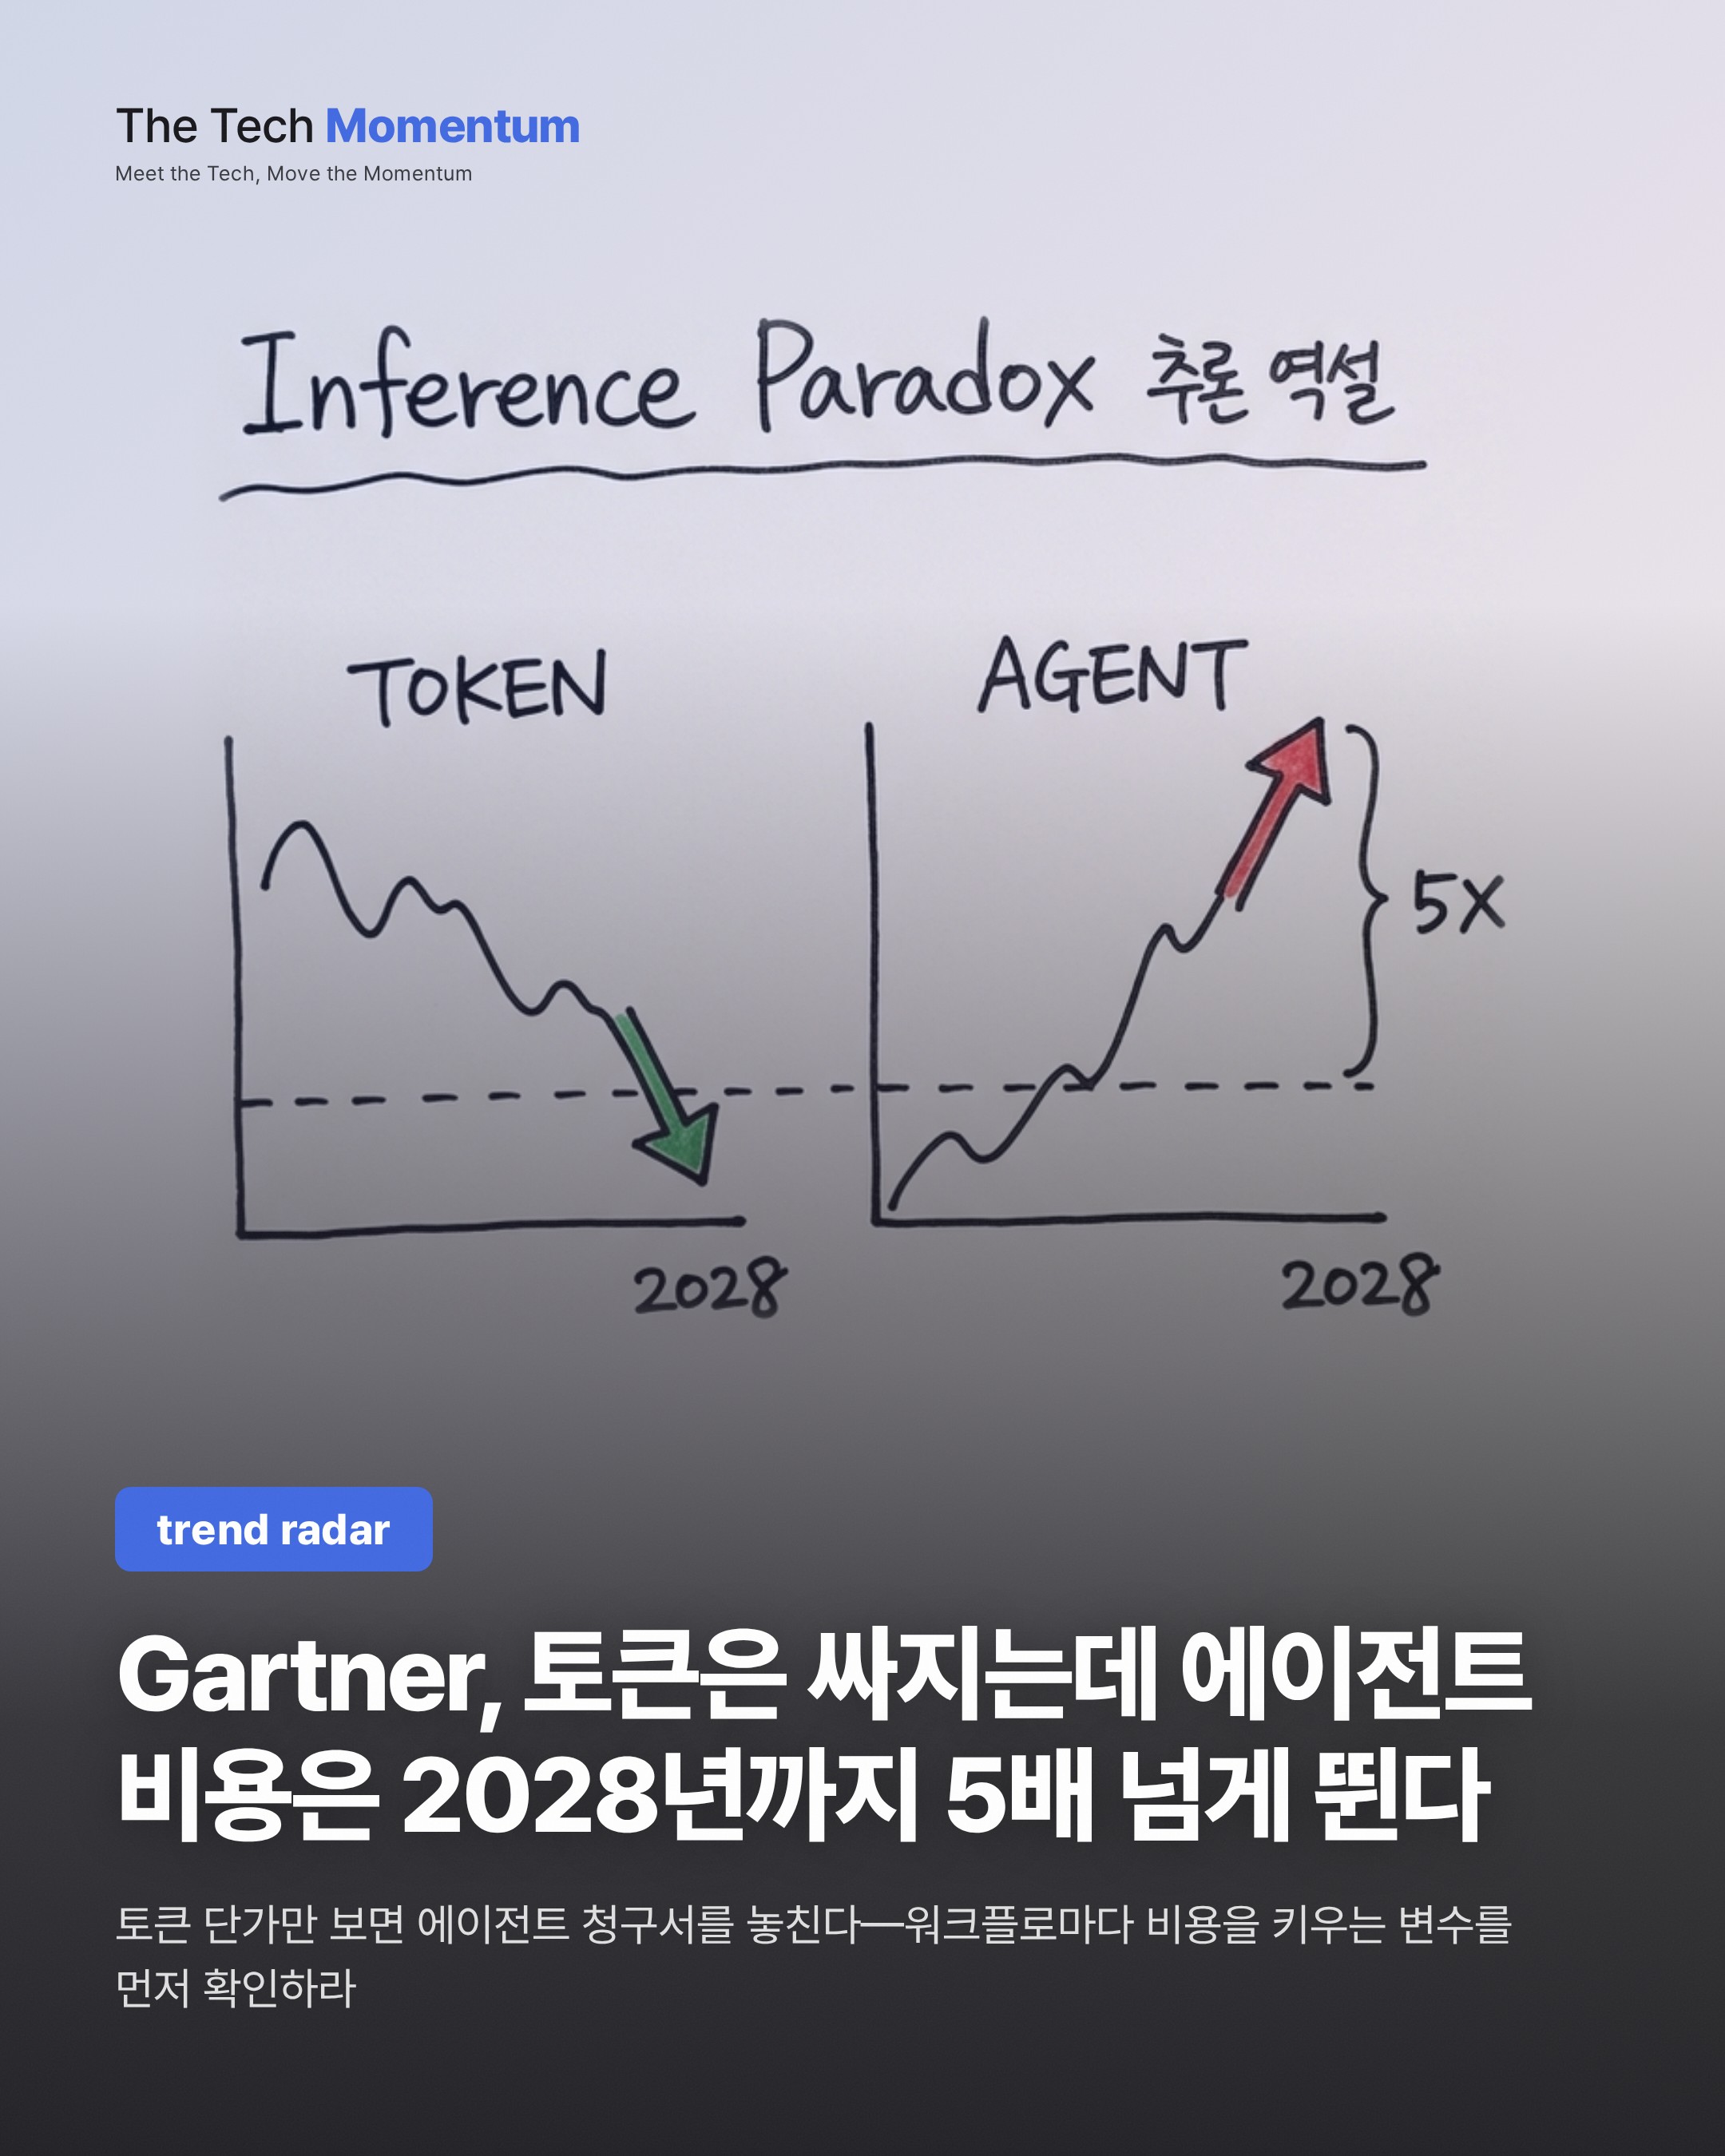
에이전트를 여러 개 붙이면 결과도 그만큼 좋아질까. 평가 기업 Vals AI의 실험에서 팀 구성은 비용만 1.8배에서 5.1배로 키웠다. 품질 개선은 대부분 측정하기 어려운 수준이었다.
실험 조건: 모델 2종, 추론 수준 2단계
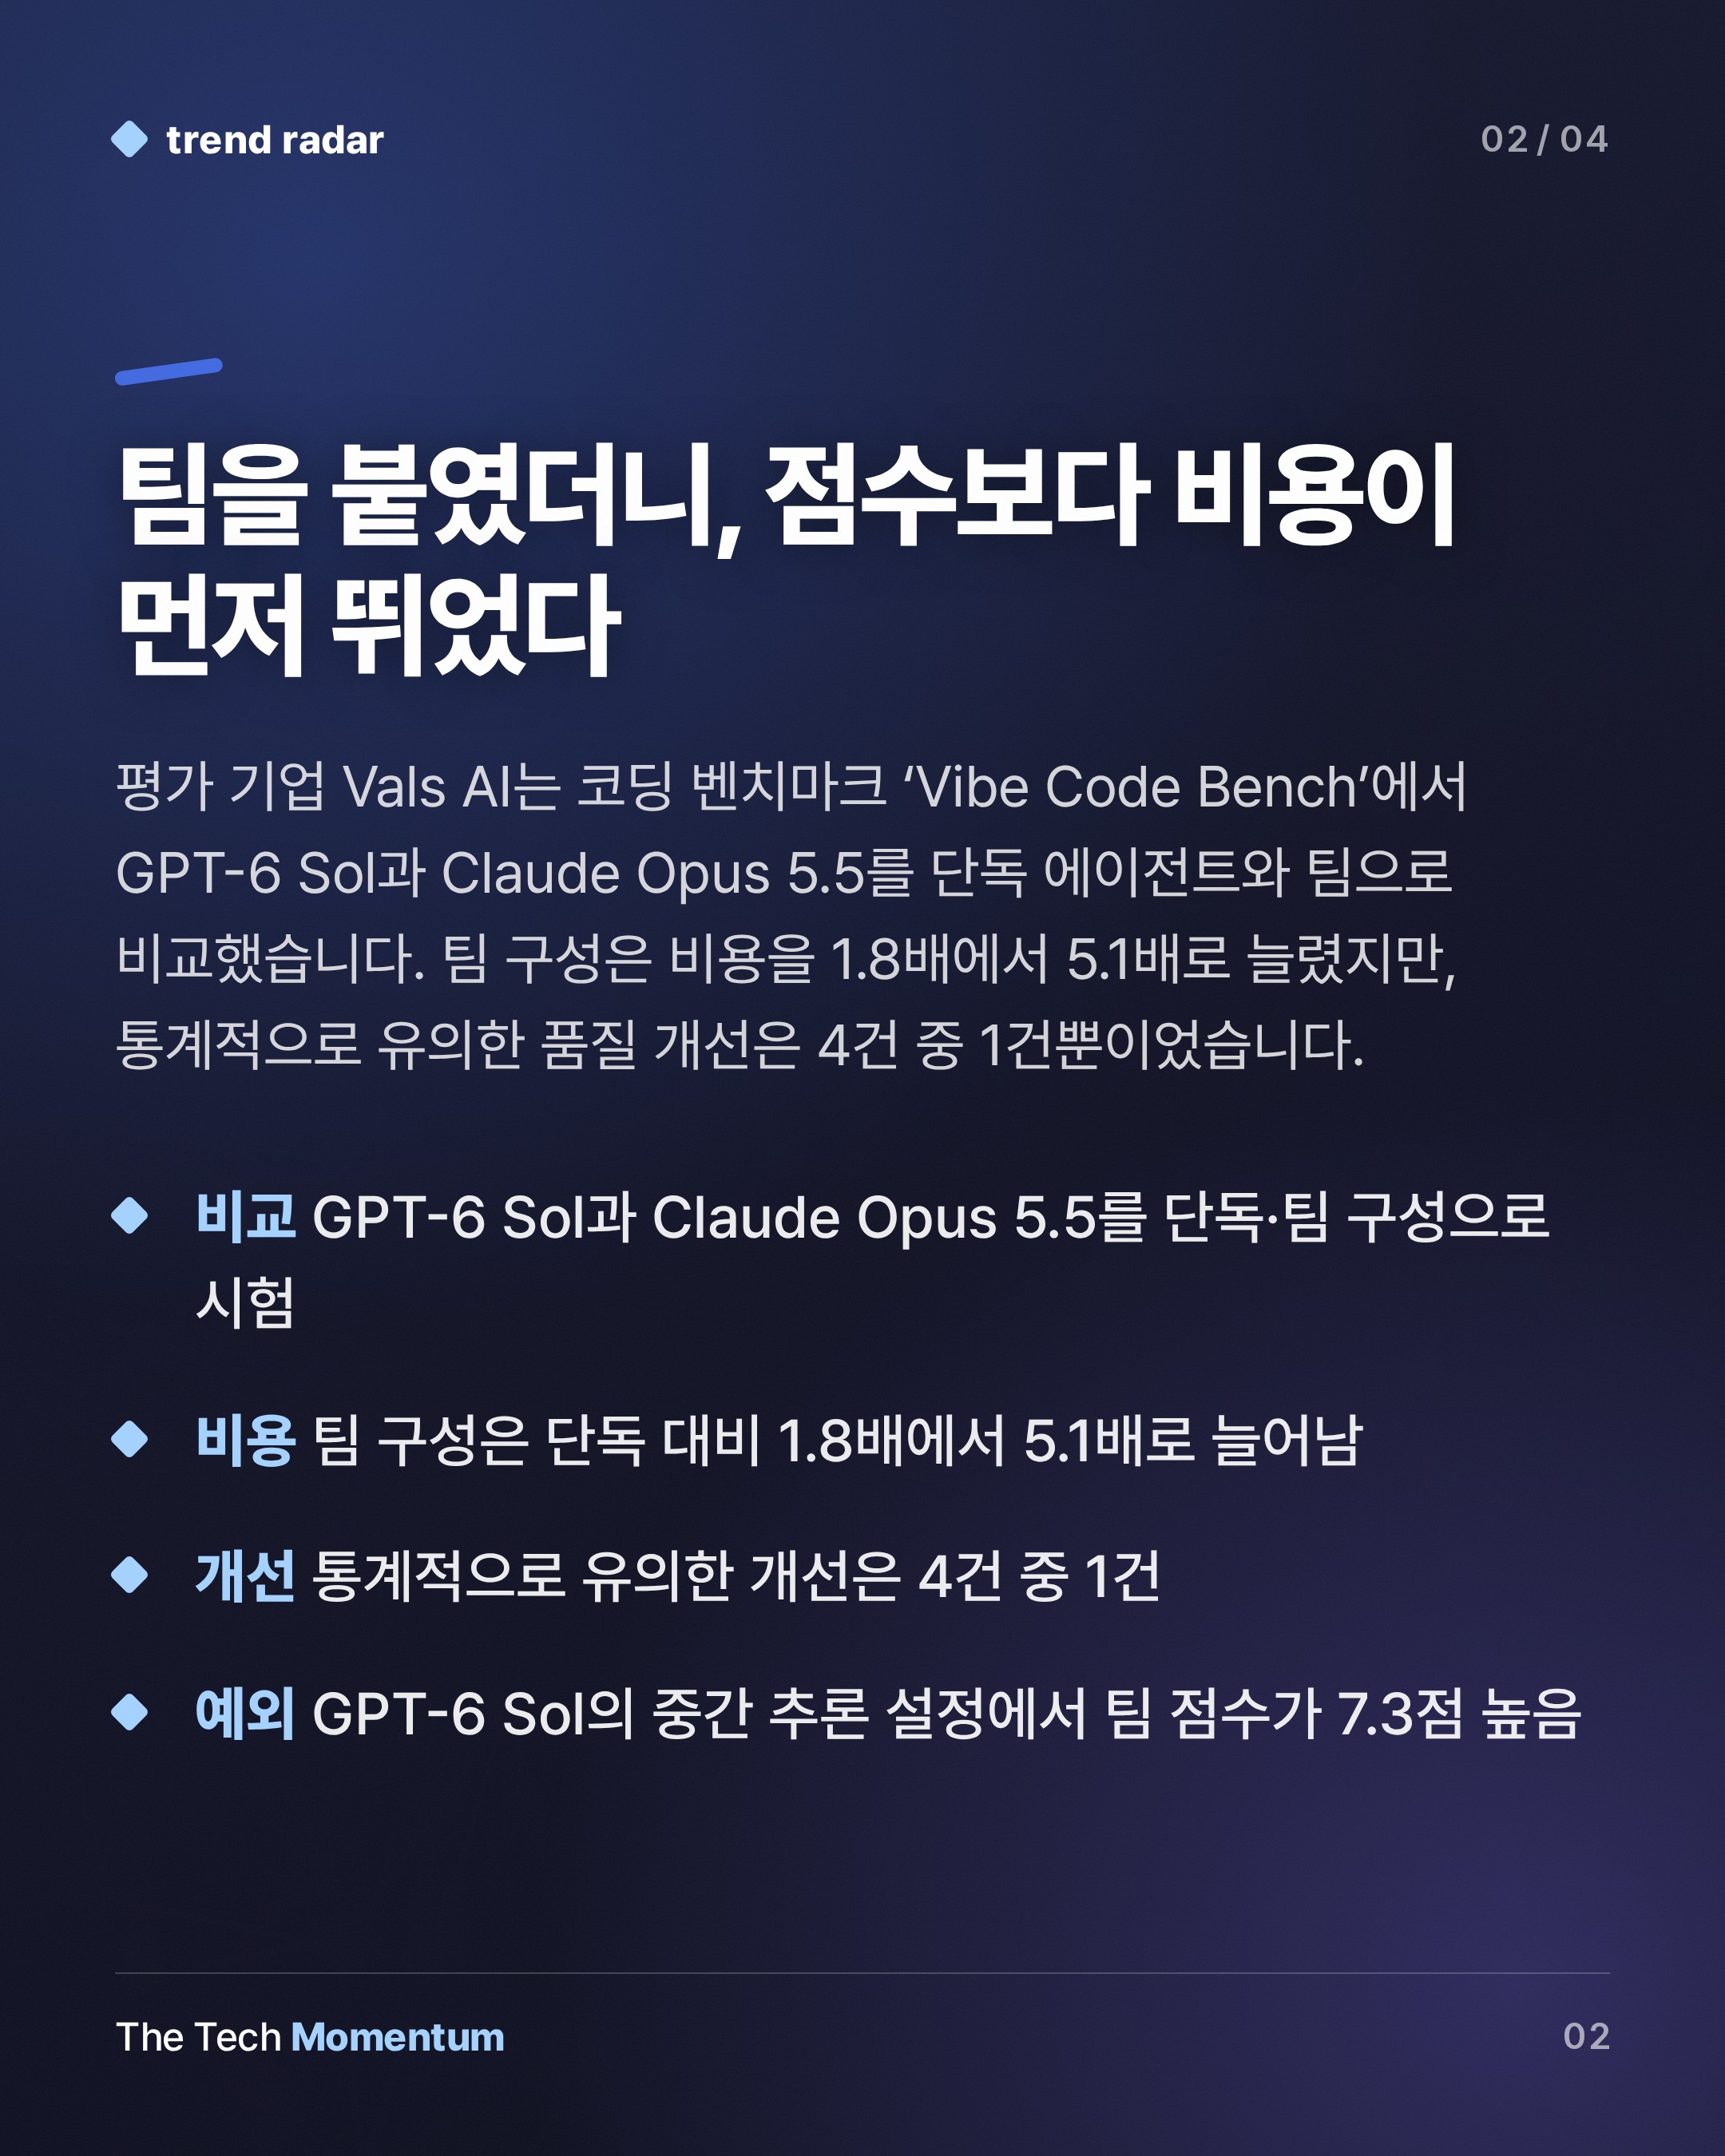
Vals AI는 "Vibe Code Bench"로 GPT-6 Sol과 Claude Opus 5.5를 시험했다. 각 모델을 단독 에이전트와 팀으로 나누고, 추론 강도도 중간과 최대 두 단계로 달리했다. 비교 조합은 모두 네 가지다.
▼ Vals AI 비교 결과 요약 (출처: Vals AI)
| 항목 | 내용 |
|---|---|
| 벤치마크 | Vibe Code Bench |
| 모델 | GPT-6 Sol, Claude Opus 5.5 |
| 구성 | 단독 / 팀 |
| 추론 수준 | 중간 / 최대 |
| 팀 비용 (단독 대비 배수) | 1.8~5.1 |
| 통계적으로 유의한 개선 | 4건 중 1건 |
개선이 나온 곳은 한 군데
통계적으로 유의한 개선은 GPT-6 Sol의 중간 추론 설정에서만 나왔다. 팀 점수가 단독보다 7.3점 높았다. 최대 추론에서는 Sol도 Opus 5.5도 팀 구성의 뚜렷한 이점이 없었다. 이 결과는 코딩 벤치마크 한 종류에서 나온 값이다.
규모를 키워도 이득은 완만하다
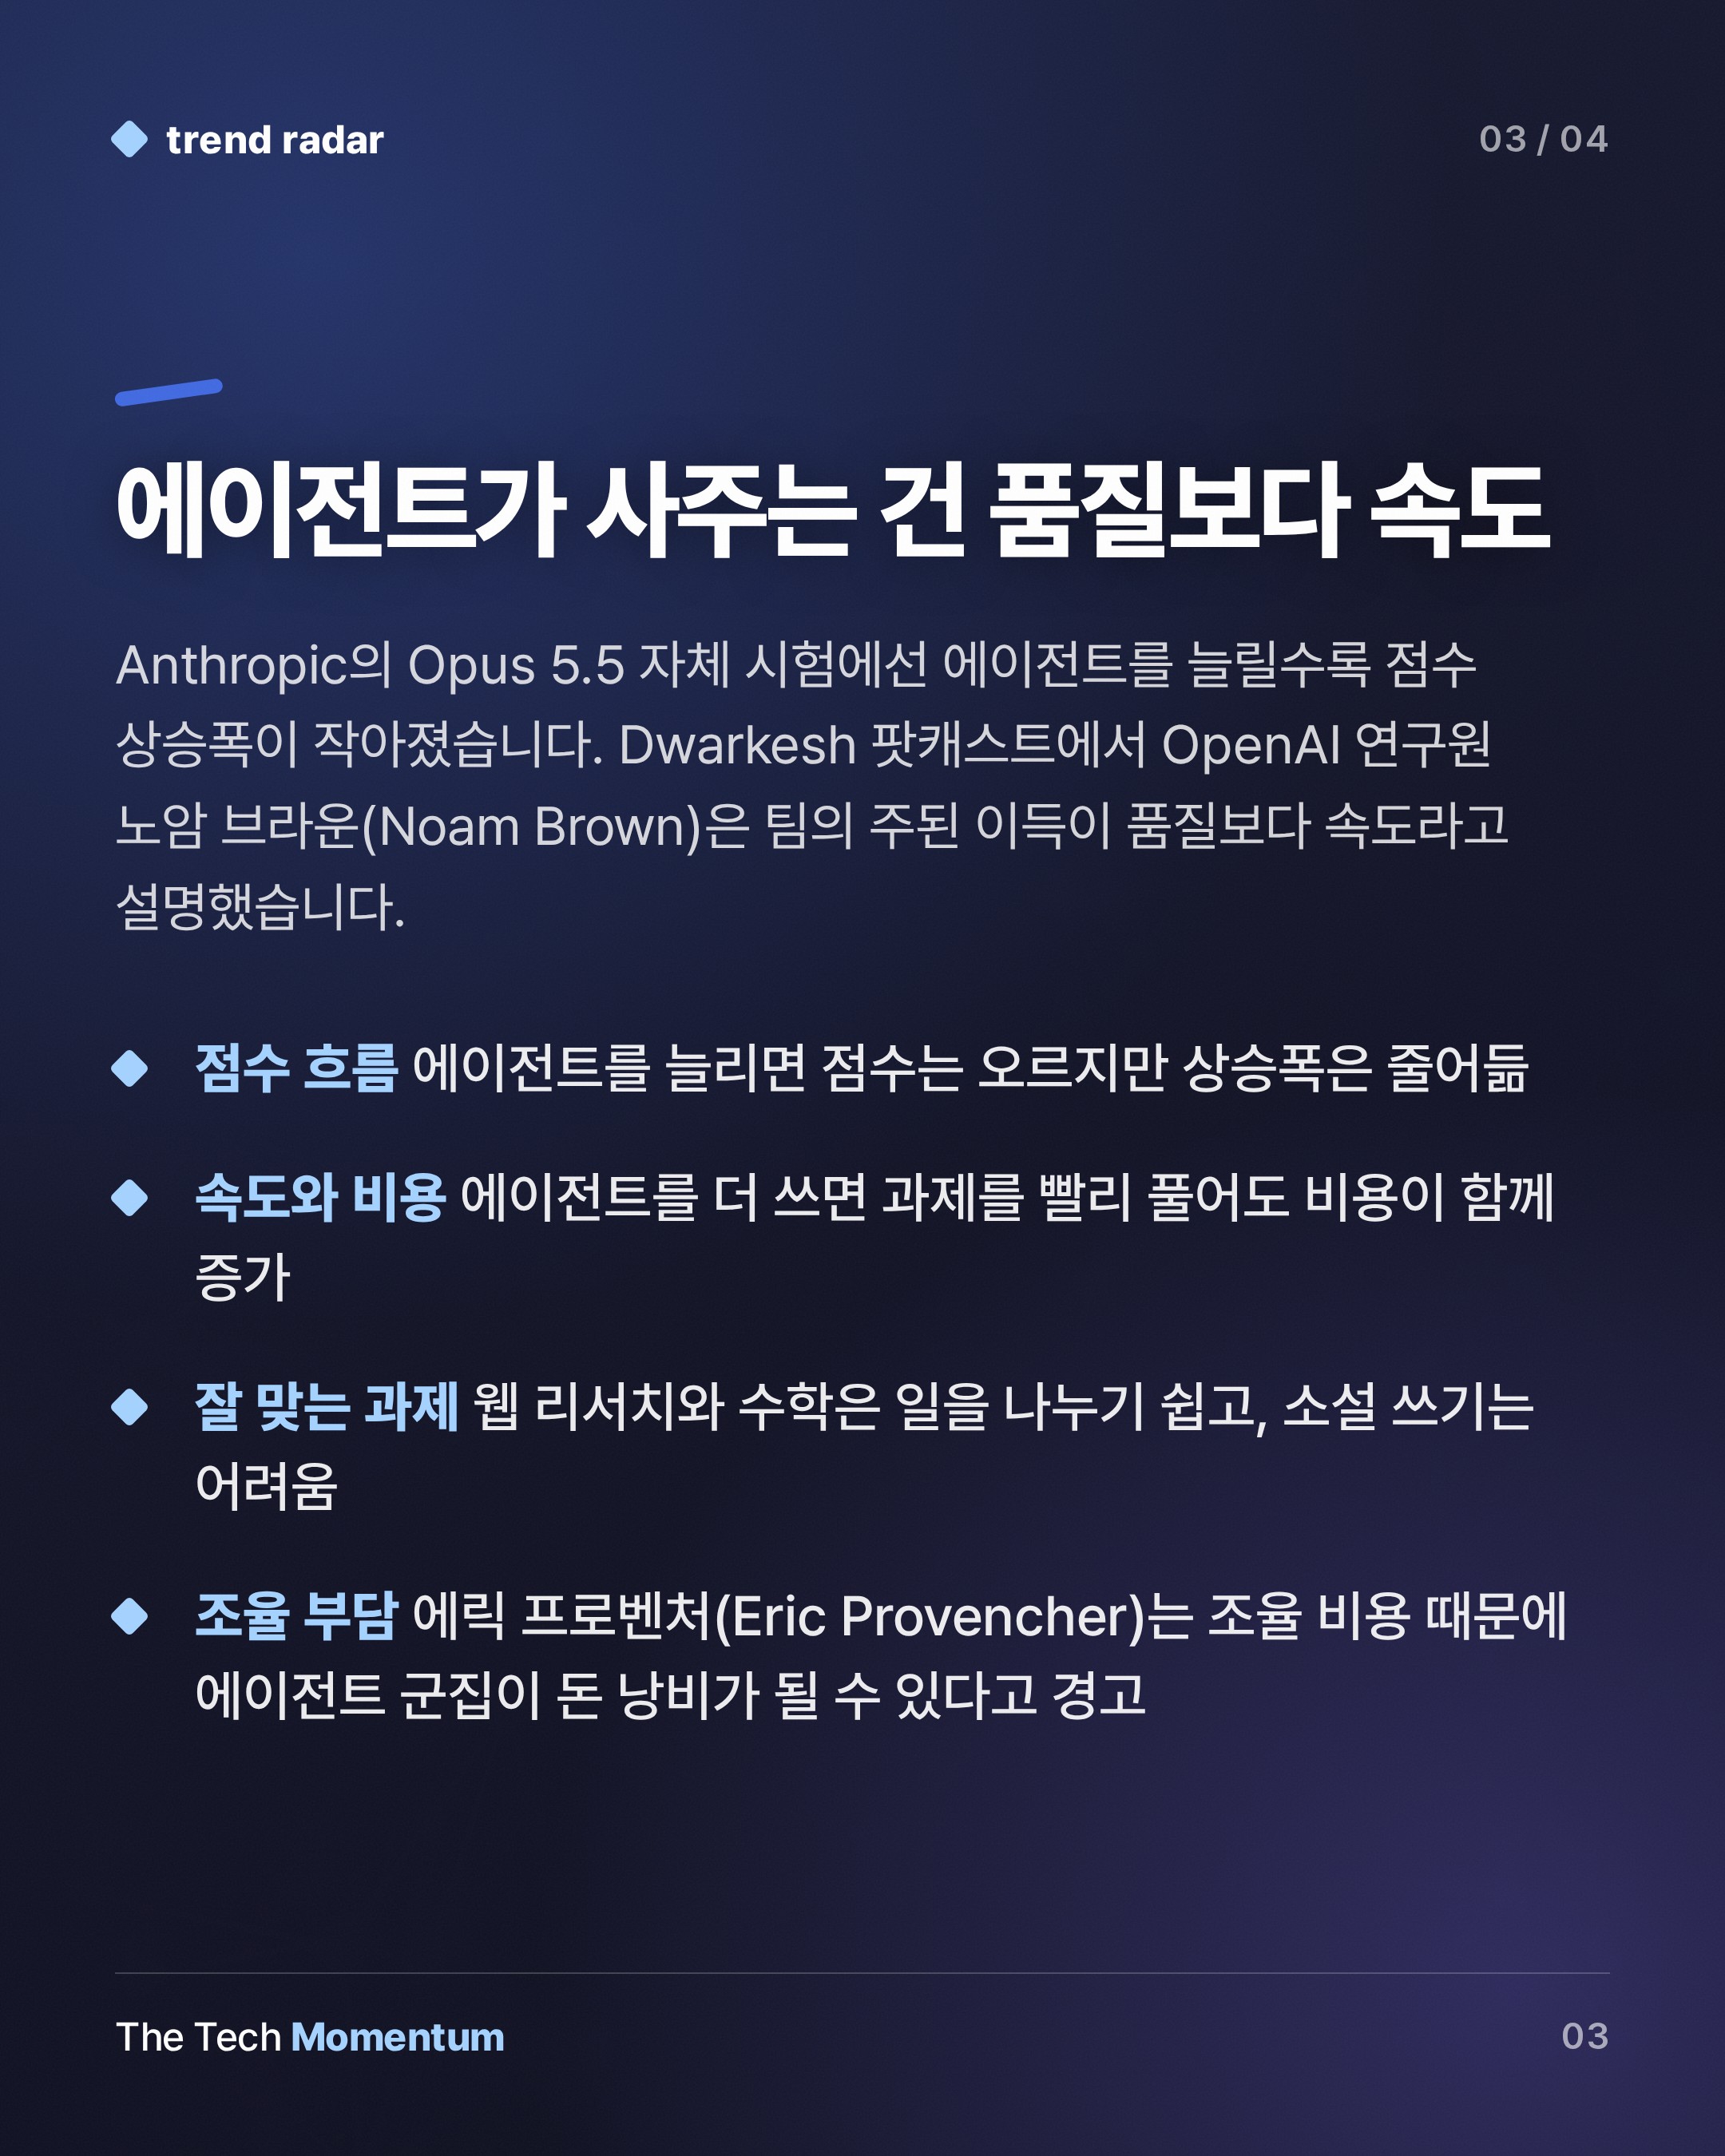
Anthropic도 Opus 5.5로 한 자체 시험 두 건에서 에이전트를 늘릴수록 품질 증가폭이 줄어드는 모습을 확인했다. 팀이 클수록 같은 성능 수준에 더 빨리 닿았지만, 24시간 뒤 점수는 10개에서 100개로 늘려도 조금 오르는 데 그쳤다. 별도의 ProgramBench 시험에서는 속도가 빨라진 만큼 토큰 사용량도 늘었다.
▼ Opus 5.5 에이전트 수별 점수 (출처: Anthropic 시스템 카드)
| 과제 | 1개 | 10개 | 30개 | 100개 |
|---|---|---|---|---|
| 지식 베이스 | 0.53 | 0.70 | 0.71 | 0.74 |
| Lean 정리 증명 | 0.39 | 0.66 | 0.66 | 0.68 |
1개에서 10개로 늘 때 점수가 크게 뛰고, 이후에는 거의 평평하다. 소스에 모델명만 나오는 Fable 5.1은 Lean 정리 증명에서 에이전트 10개 이상 구간의 향상폭이 더 컸다. 그래도 모든 시험에서 Opus 5.5보다 점수가 낮았다. 지식 베이스 과제에서는 30개에서 100개로 늘리자 점수가 오히려 조금 내려갔다.
팀이 사주는 것은 속도
OpenAI 연구원 노암 브라운(Noam Brown)은 Dwarkesh 팟캐스트에서 멀티에이전트 시스템이 주로 사 주는 것은 품질이 아니라 속도라고 확인했다. 에이전트 4개는 과제를 두 배 빠르게 풀었지만 비용도 두 배였다. 16개에서도 같은 양상이 이어졌고 효율은 조금 더 떨어졌다.
효과는 과제 성격에 크게 좌우된다. 웹 리서치와 수학은 병렬화가 잘 되지만 소설 쓰기는 그렇지 않다는 설명이다. 소설에 에이전트 1만 개를 붙이는 것은 사람 1만 명을 붙이는 것만큼 무의미하다고 했다. 에이전트를 아주 많이 늘리는 영역은 비용이 너무 커서 아직 대부분 탐색되지 않았다고도 인정했다.
OpenAI 개발자 에릭 프로벤처(Eric Provencher)도 같은 이유로 에이전트 군집 사용을 경고했다. 에이전트 간 조율이 무너지기 때문에 대체로 돈 낭비일 가능성이 크다는 주장이다. 그는 이를 조율세(coordination tax)라 불렀다.
국내 팀이 따져볼 지점
에이전트 팀 도입을 검토하는 개발팀이라면 품질 개선폭과 추가 연산 비용을 같은 표에 놓고 봐야 한다. 이번 결과로 보면 최대 추론으로 이미 돌리는 모델에는 팀 구성의 이점이 작았다. 다만 이 수치를 모든 에이전트 업무로 일반화할 수는 없다. 시험은 특정 모델 두 종과 Vibe Code Bench 조건에서 나왔고, 병렬화가 잘 되는 과제에서는 속도 이득이 비용을 정당화할 여지가 남아 있다.