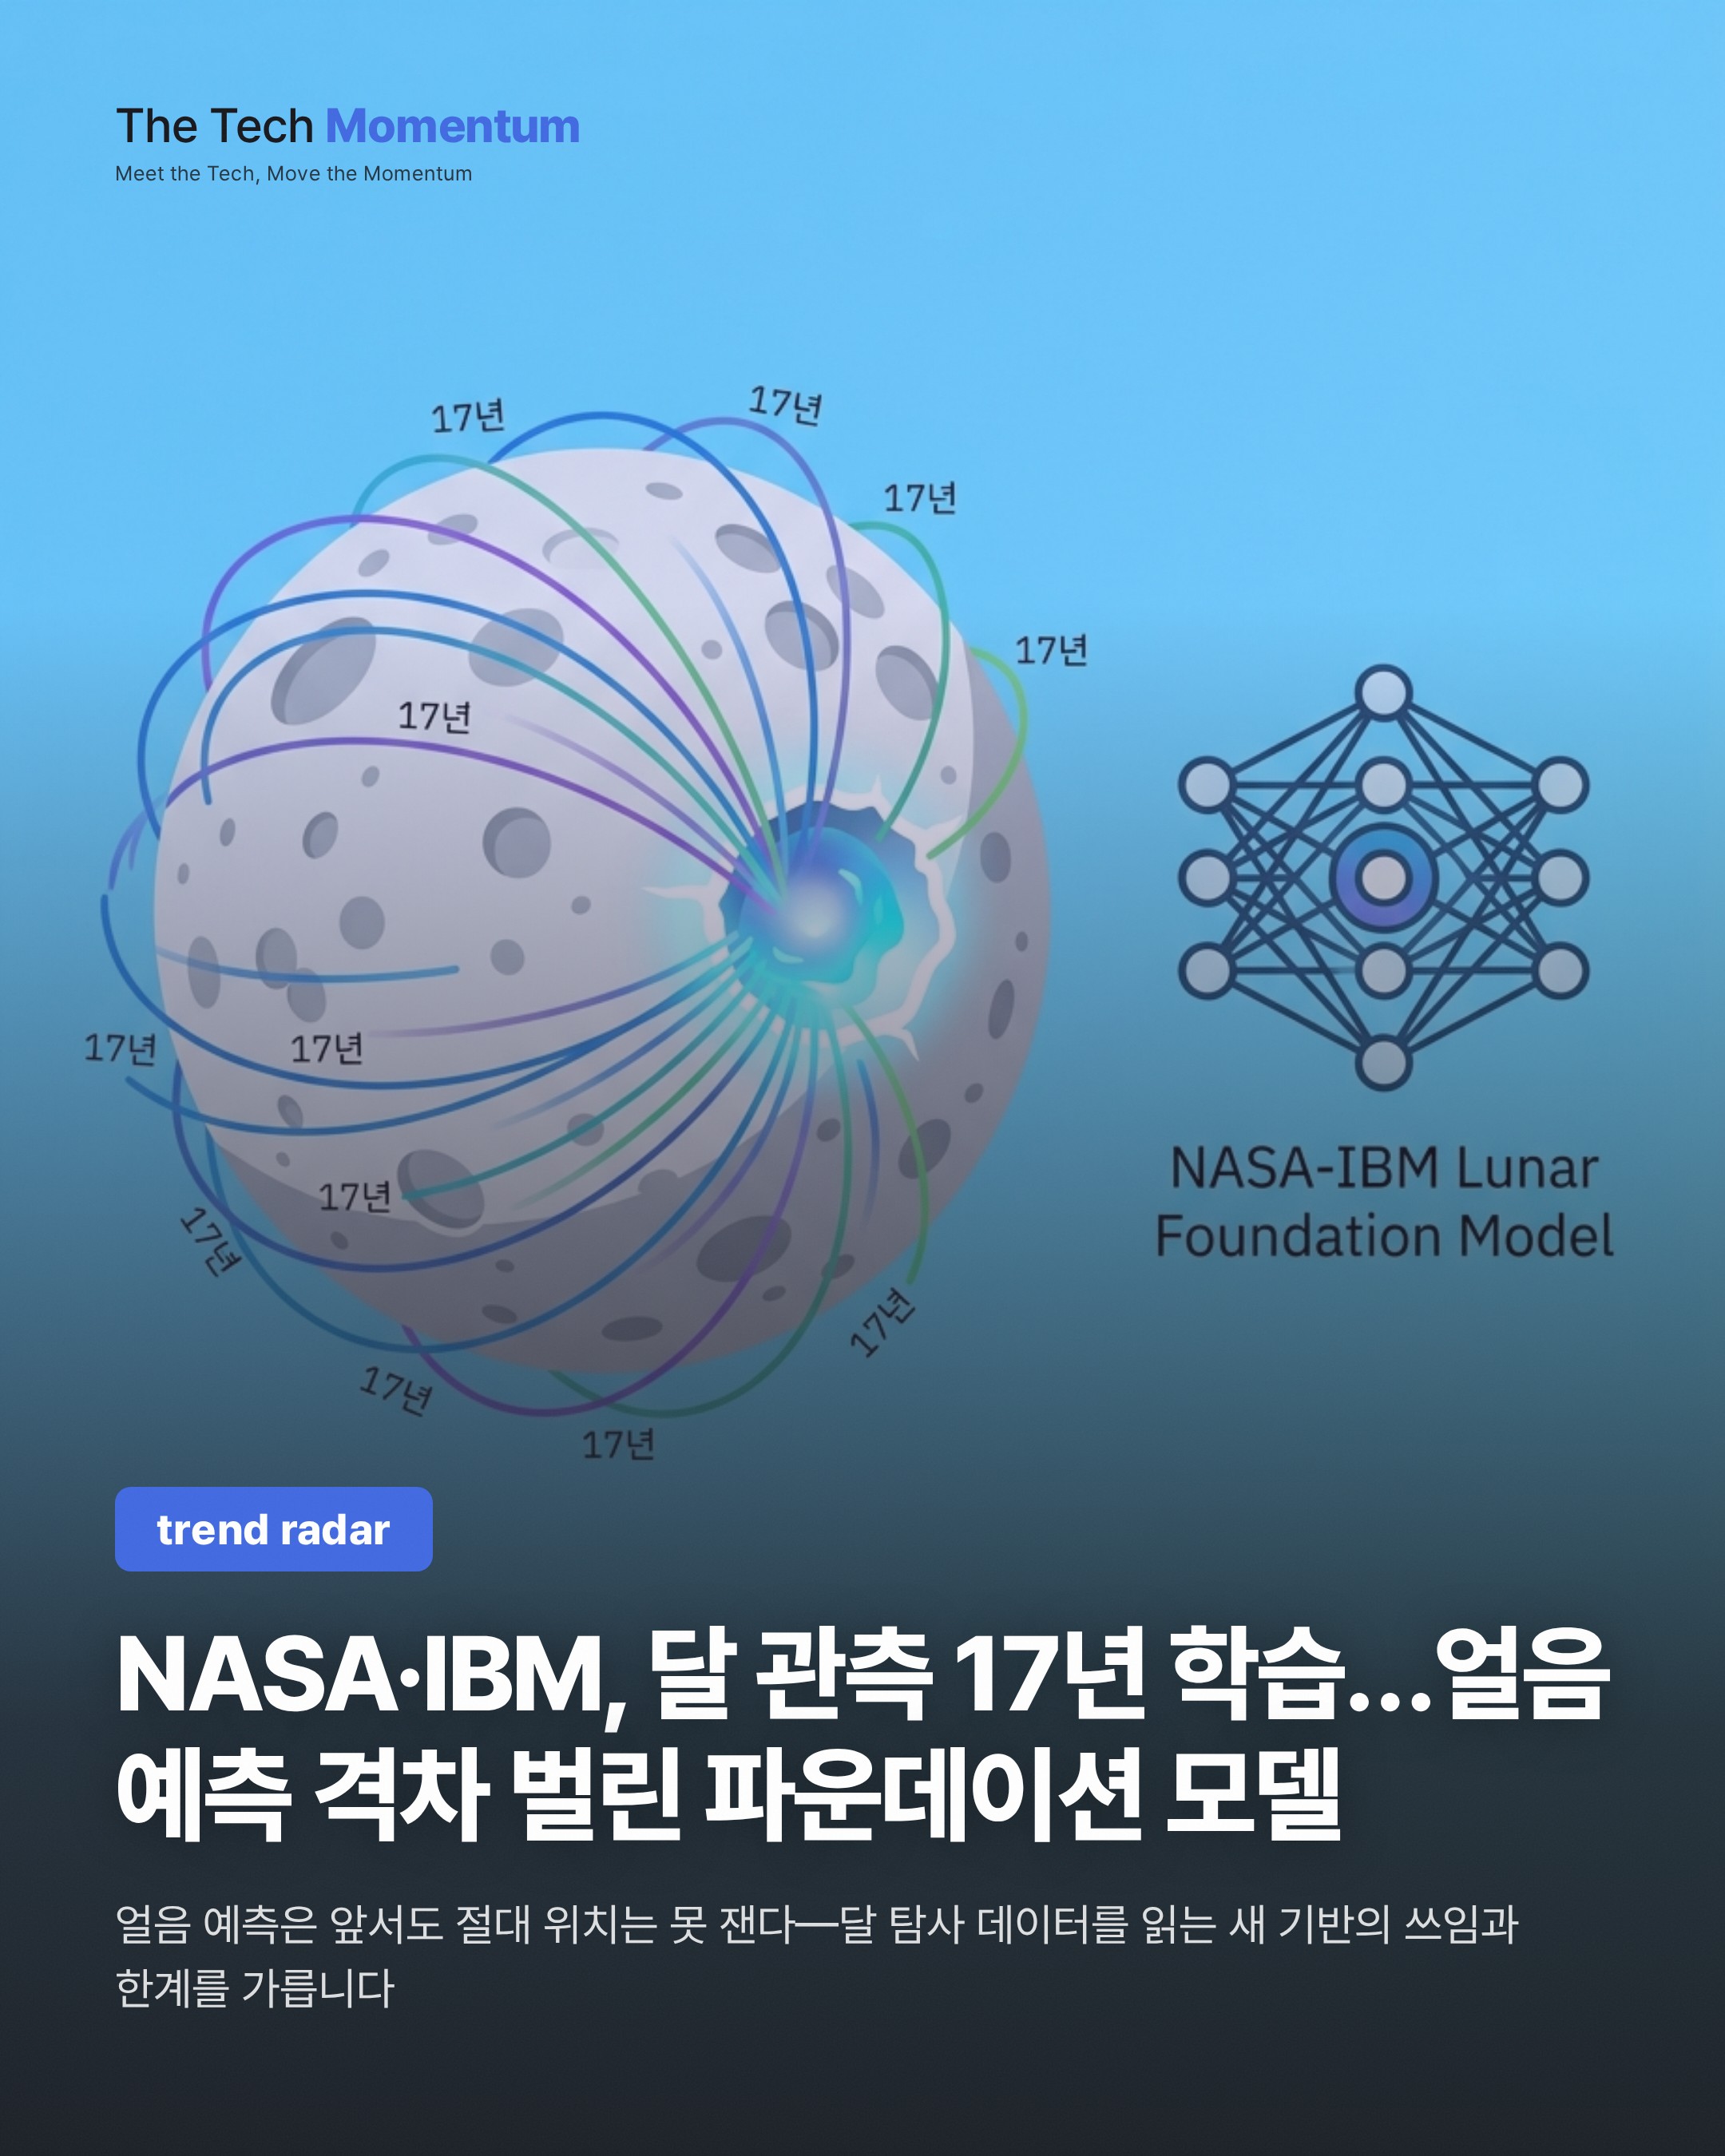
"NASA는 수십 년간 달에 대한 놀라운 과학 기록을 쌓아왔지만, 데이터를 모으는 건 일의 절반에 불과하다." NASA 최고 과학데이터 책임자 케빈 머피(Kevin Murphy)의 말이다. 데이터를 과학자가 쓰기 쉽게 만드는 일이 나머지 절반이라는 얘기다. NASA와 IBM Research이 여러 대학과 함께 내놓은 NASA-IBM Lunar Foundation Model은 그 절반을 채우려는 시도다. 두 기관은 이 모델을 달 과학 분야 최초급 오픈소스 파운데이션 모델로 소개한다.
라벨은 없고 관측 데이터만 쌓인 분야
파운데이션 모델은 라벨 없는 대규모 데이터로 먼저 학습한 뒤, 소량의 라벨 데이터만으로 개별 과제에 맞춰 쓴다. 달 연구는 관측 데이터가 넘치는데 라벨이 귀하다. 연구팀이 이 방식에 기대를 거는 이유다.
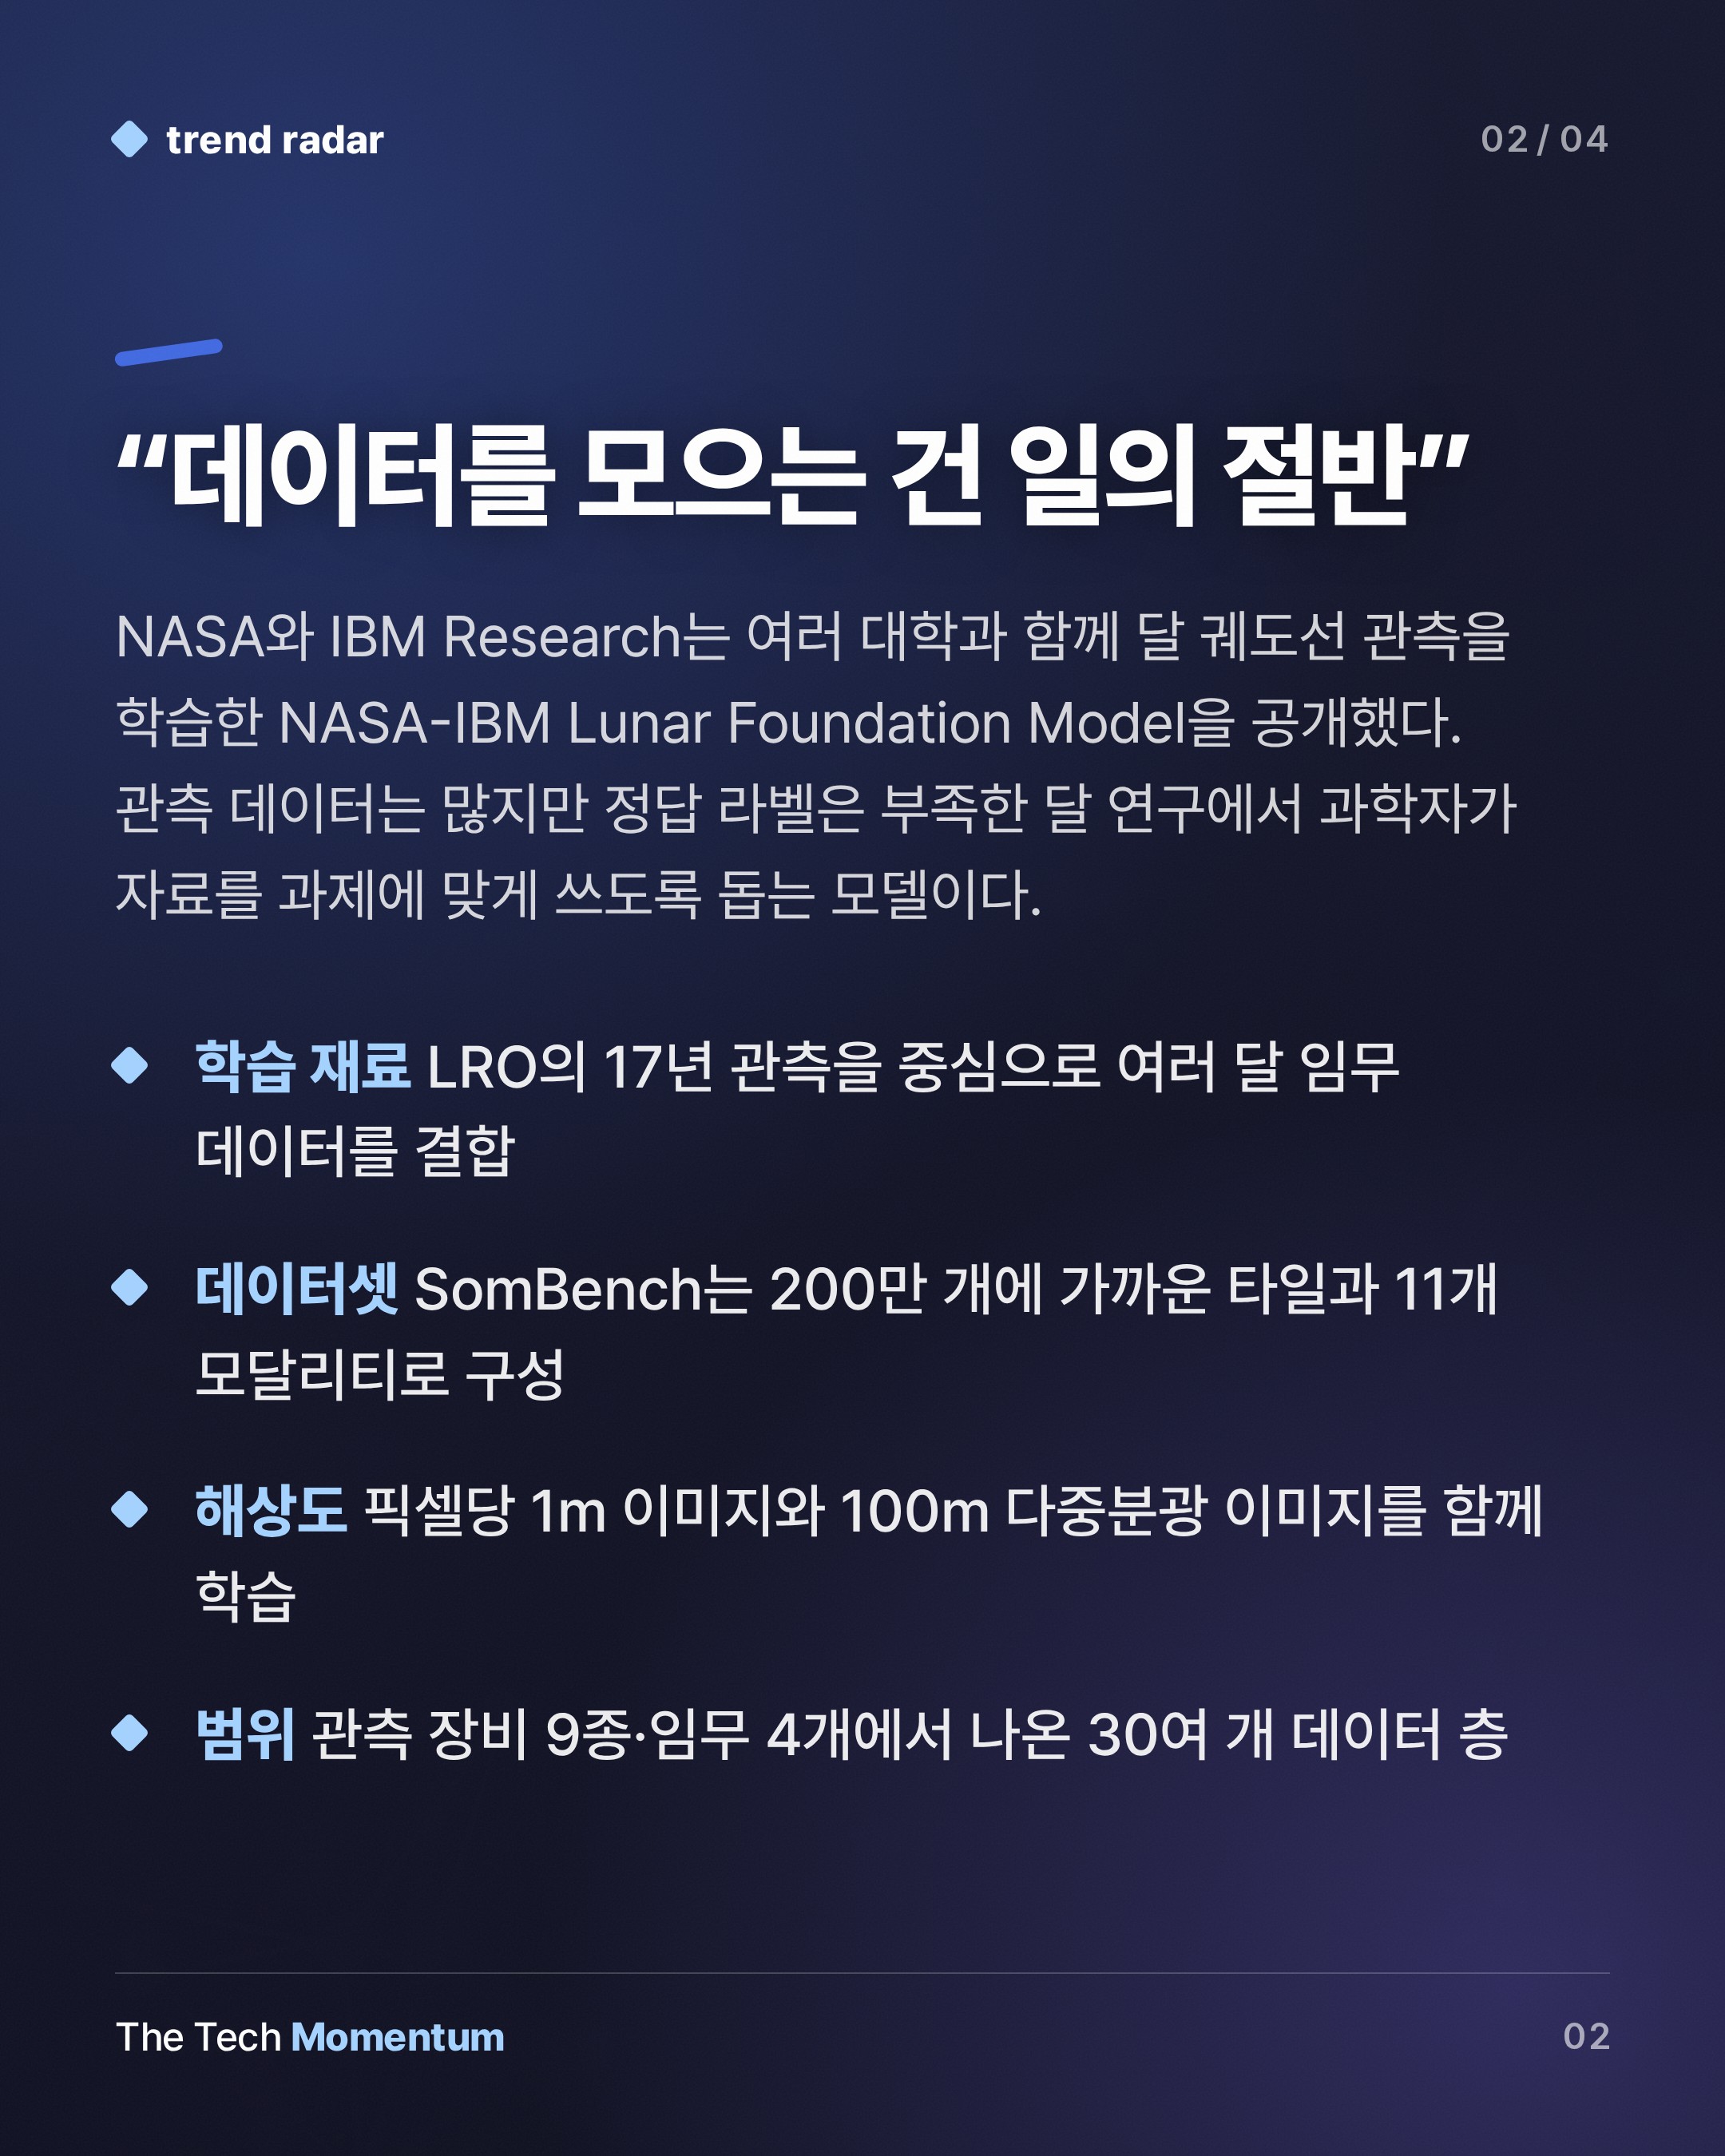
학습에는 SomBench라는 데이터셋을 썼다. 연구팀은 지금까지 가장 큰 달 멀티모달 정합 데이터라고 설명한다. 타일 묶음이 200만 개에 가깝고, 11개 모달리티와 두 가지 공간 해상도로 구성된다. 픽셀당 약 1m인 Narrow Angle Camera 고해상도 이미지가 약 100만 장, 픽셀당 100m인 Wide Angle Camera 다중분광 이미지가 96만 4,000장 남짓이다.
뼈대는 달 정찰 궤도선(LRO)의 17년 관측이다. NASA에 따르면 LRO의 데이터 양은 NASA의 다른 행성 탐사 임무를 모두 합친 것보다 많다. 여기에 중력장을 잰 GRAIL, 수소를 잰 Lunar Prospector, 광물 조성을 잰 JAXA의 Kaguya(SELENE) 데이터가 더해졌다. 합치면 관측 장비 9종, 임무 4개에서 나온 30여 개 데이터 층이다. 학습·검증·테스트 데이터가 섞이지 않도록 타일을 무작위로 나누지 않고 지도 구역 단위로 갈랐다.
조명 조건은 추측시키지 않고 알려준다
모델은 지구 관측용 멀티모달 모델 TerraMind를 기반으로 하되, 미세조정이 아니라 처음부터 학습했다. 타일마다 조명 각도, 태양 위치, 타일 범위 같은 촬영 기하 정보를 입력으로 준다. 달에서는 표면의 실제 성질보다 조명 기하가 겉모습을 더 크게 좌우한다. 연구팀은 픽셀만 보고 그 영향을 보정하게 하는 대신 정보를 직접 먹였다.
데이터 층마다 별도 처리 경로를 두는 것도 특징이다. 비교 대상 모델은 입력을 채널로 겹쳐 한꺼번에 처리한다. 무작위 초기화 대조 모델이 달 사전학습 없이도 얼음 예측에서 기준 모델 7개 중 5개를 앞선 것도 이 구조 덕분으로 연구팀은 설명한다.
얼음 예측에서 가장 크게 앞섰다
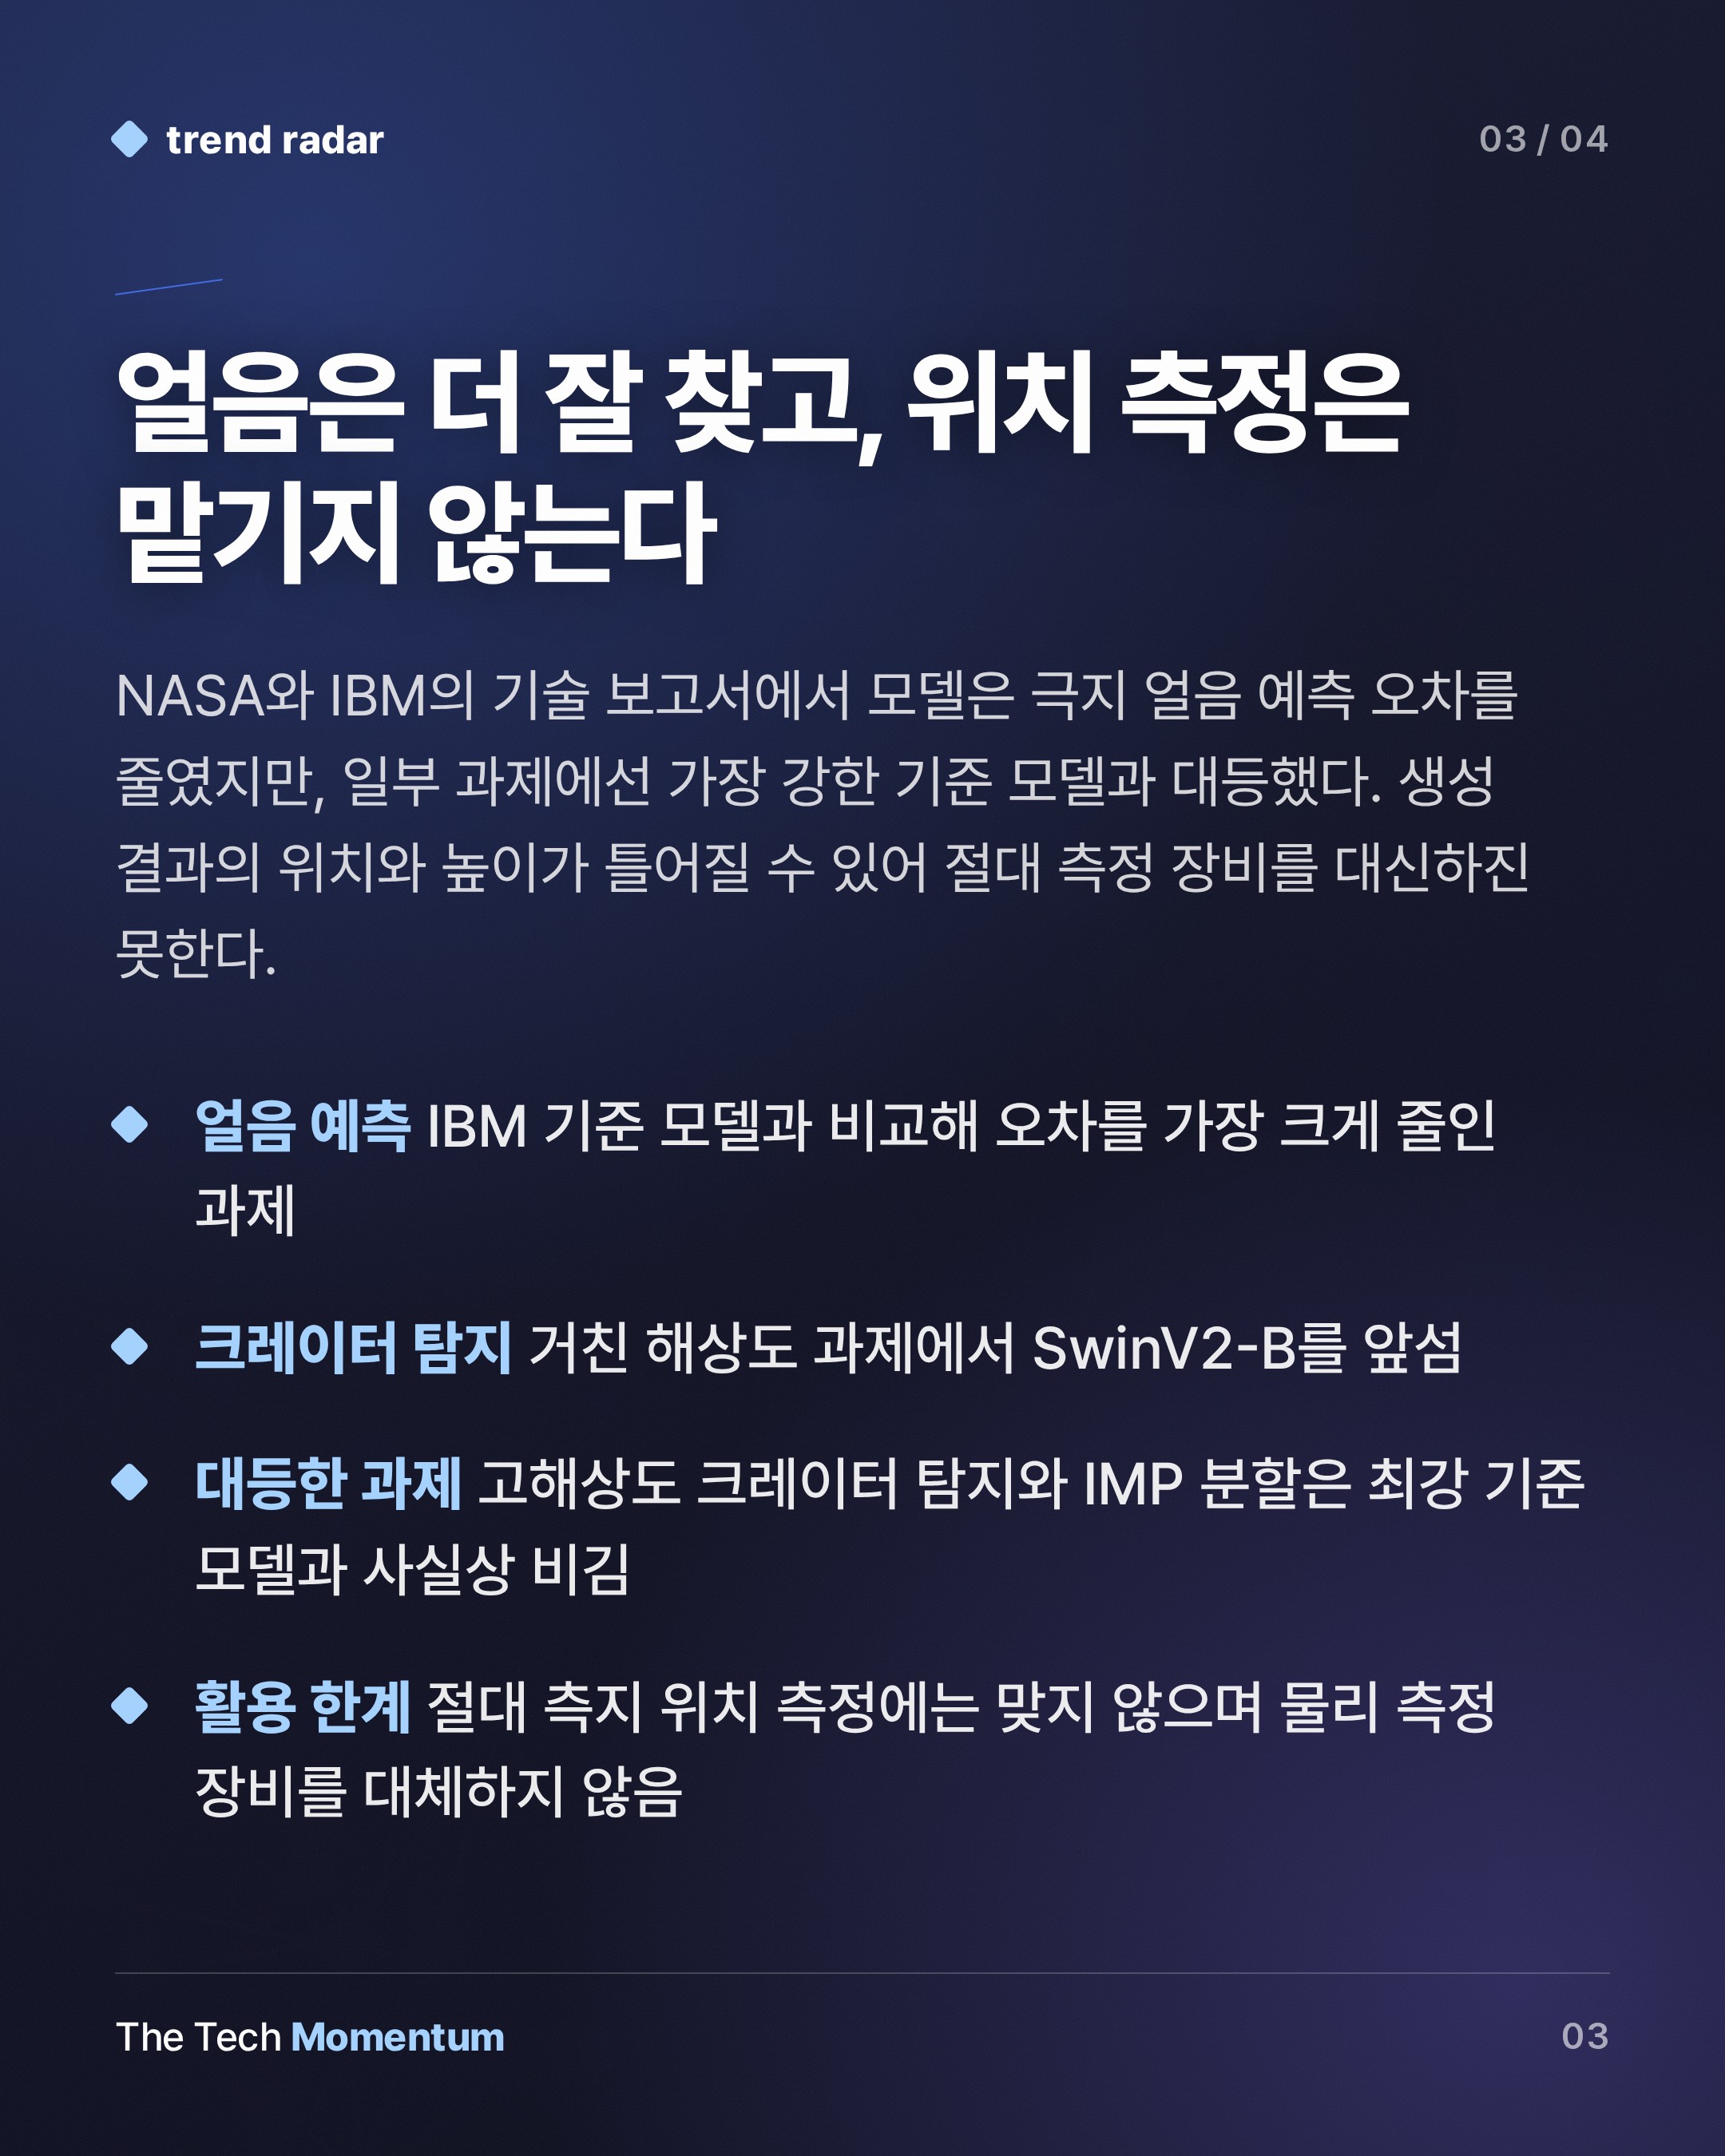
평가는 100m·1m 해상도의 크레이터 탐지, 극지 얼음 매장 예측, 불규칙 마레 패치(IMP) 분할에서 이뤄졌다. IMP는 달 냉각 시간표에 의문을 던지는 젊은 화산 지형이다. 기술 보고서에 따르면 사전학습 모델은 모든 과제에서 기준 모델과 구조가 같은 무작위 초기화 모델에 비기거나 앞섰다.
격차가 가장 컸던 곳은 얼음이다. 극지의 영구 그늘 지역은 물얼음을 수십억 년 보존할 만큼 차갑고, 물·산소·로켓 연료의 잠재 자원으로 꼽힌다. IBM에 따르면 최고 기준 모델 SwinV2-B 대비 예측 오차를 최대 22% 줄였다. 거친 해상도의 크레이터 탐지에서는 SwinV2-B를 19%가량 앞섰다. 이 수치는 학습 데이터를 절반만 쓴 조건에서 나왔고, 라벨이 적어도 성능을 낸다는 뜻으로 읽힌다.
모든 과제에서 이긴 건 아니다
미터 단위 크레이터 탐지와 IMP 분할에서는 가장 강한 기준 모델과 사실상 비겼고, 차이는 학습 회차 간 편차 안에 들었다. IBM은 IMP에서 SwinV2-B보다 3% 앞섰다고 밝혔지만, 결과는 확연한 우위보다 대등에 가깝다. 파라미터 일부만 학습하는 경량 미세조정 LoRA는 전반적으로 전체 미세조정과 비슷했고 크레이터 탐지에서는 더 나았다. 전체 미세조정이 이긴 건 가장 작은 두 과제뿐이다.
한계도 분명하다. 생성 실험에서 위도·경도가 수십 도 어긋나는 경우가 있었고, 고도 구조의 형태는 맞아도 절대 높이값이 틀어지기도 했다. 연구진은 절대 측지 위치 측정에는 맞지 않으며, 물리 측정 장비를 대체하지 않는 재사용 기반이라고 선을 긋는다. 각 기법의 기여를 따로 떼어 본 통제 실험은 아직 남아 있고, 일부 테스트 데이터셋은 작다.
지구에서 달로 넓어진 모델 계보
모델은 Hugging Face에, 코드는 GitHub에 공개됐고 오픈소스 툴킷 TerraTorch에도 통합됐다. 사전학습용 데이터셋과 벤치마크도 함께 풀렸다.
NASA와 IBM은 2022년 초부터 우주법 협정(Space Act Agreement) 아래 파운데이션 모델을 함께 만들어왔다. 2023년 8월에는 미국 본토 전역의 Landsat·Sentinel-2 영상으로 학습해 홍수와 산불 지도에 쓴 첫 Prithvi 모델을 Hugging Face에 올렸다. 이번 모델의 토대 TerraMind는 IBM이 2025년 ESA, 독일 율리히 연구센터와 지구 관측용으로 개발한 것이다. 비슷한 접근으로 Google Deepmind는 AlphaEarth Foundations로 광학 위성 영상, 레이더, 라이다, 기후 시뮬레이션을 지표면의 압축 임베딩으로 묶고 있다.
한국 독자에게는 데이터 쪽이 눈에 들어온다. 17년 치 관측을 정합하고 ML용으로 정리해 공개하는 작업이 모델 못지않은 자산이 됐다.