2022년 11월, ChatGPT가 등장하면서 세상이 바뀌었다. 거대언어모델(LLM)과 대화하는 방법이 생기자 AI는 단숨에 일상으로 파고들었다. 그로부터 4년 가까이 지난 지금, 로봇 산업은 같은 질문 앞에 서 있다. '우리의 ChatGPT 모멘트는 언제인가.'
Nvidia Inception의 피지컬 AI 총괄 Les Karpas는 오는 10월 13~15일 샌프란시스코 Moscone West에서 열리는 TechCrunch Disrupt 2026 무대에서 그 답을 직접 풀어낼 예정이다. 세션 제목은 '로봇은 ChatGPT 모멘트를 기다리고 있다. 무엇이 가로막고 있는가'다.
인터넷이 없는 세계의 학습
Karpas의 진단은 단순하지만, 해결은 복잡하다. OpenAI와 Anthropic이 LLM을 훈련할 때는 인터넷 전체가 데이터셋이었다. 자율주행 분야도 Waymo가 수년간 도로 주행 거리를 쌓으며 방대한 데이터를 축적했다. 그러나 범용 로봇에게는 그런 규모의 물리적 상호작용 데이터가 존재하지 않는다.
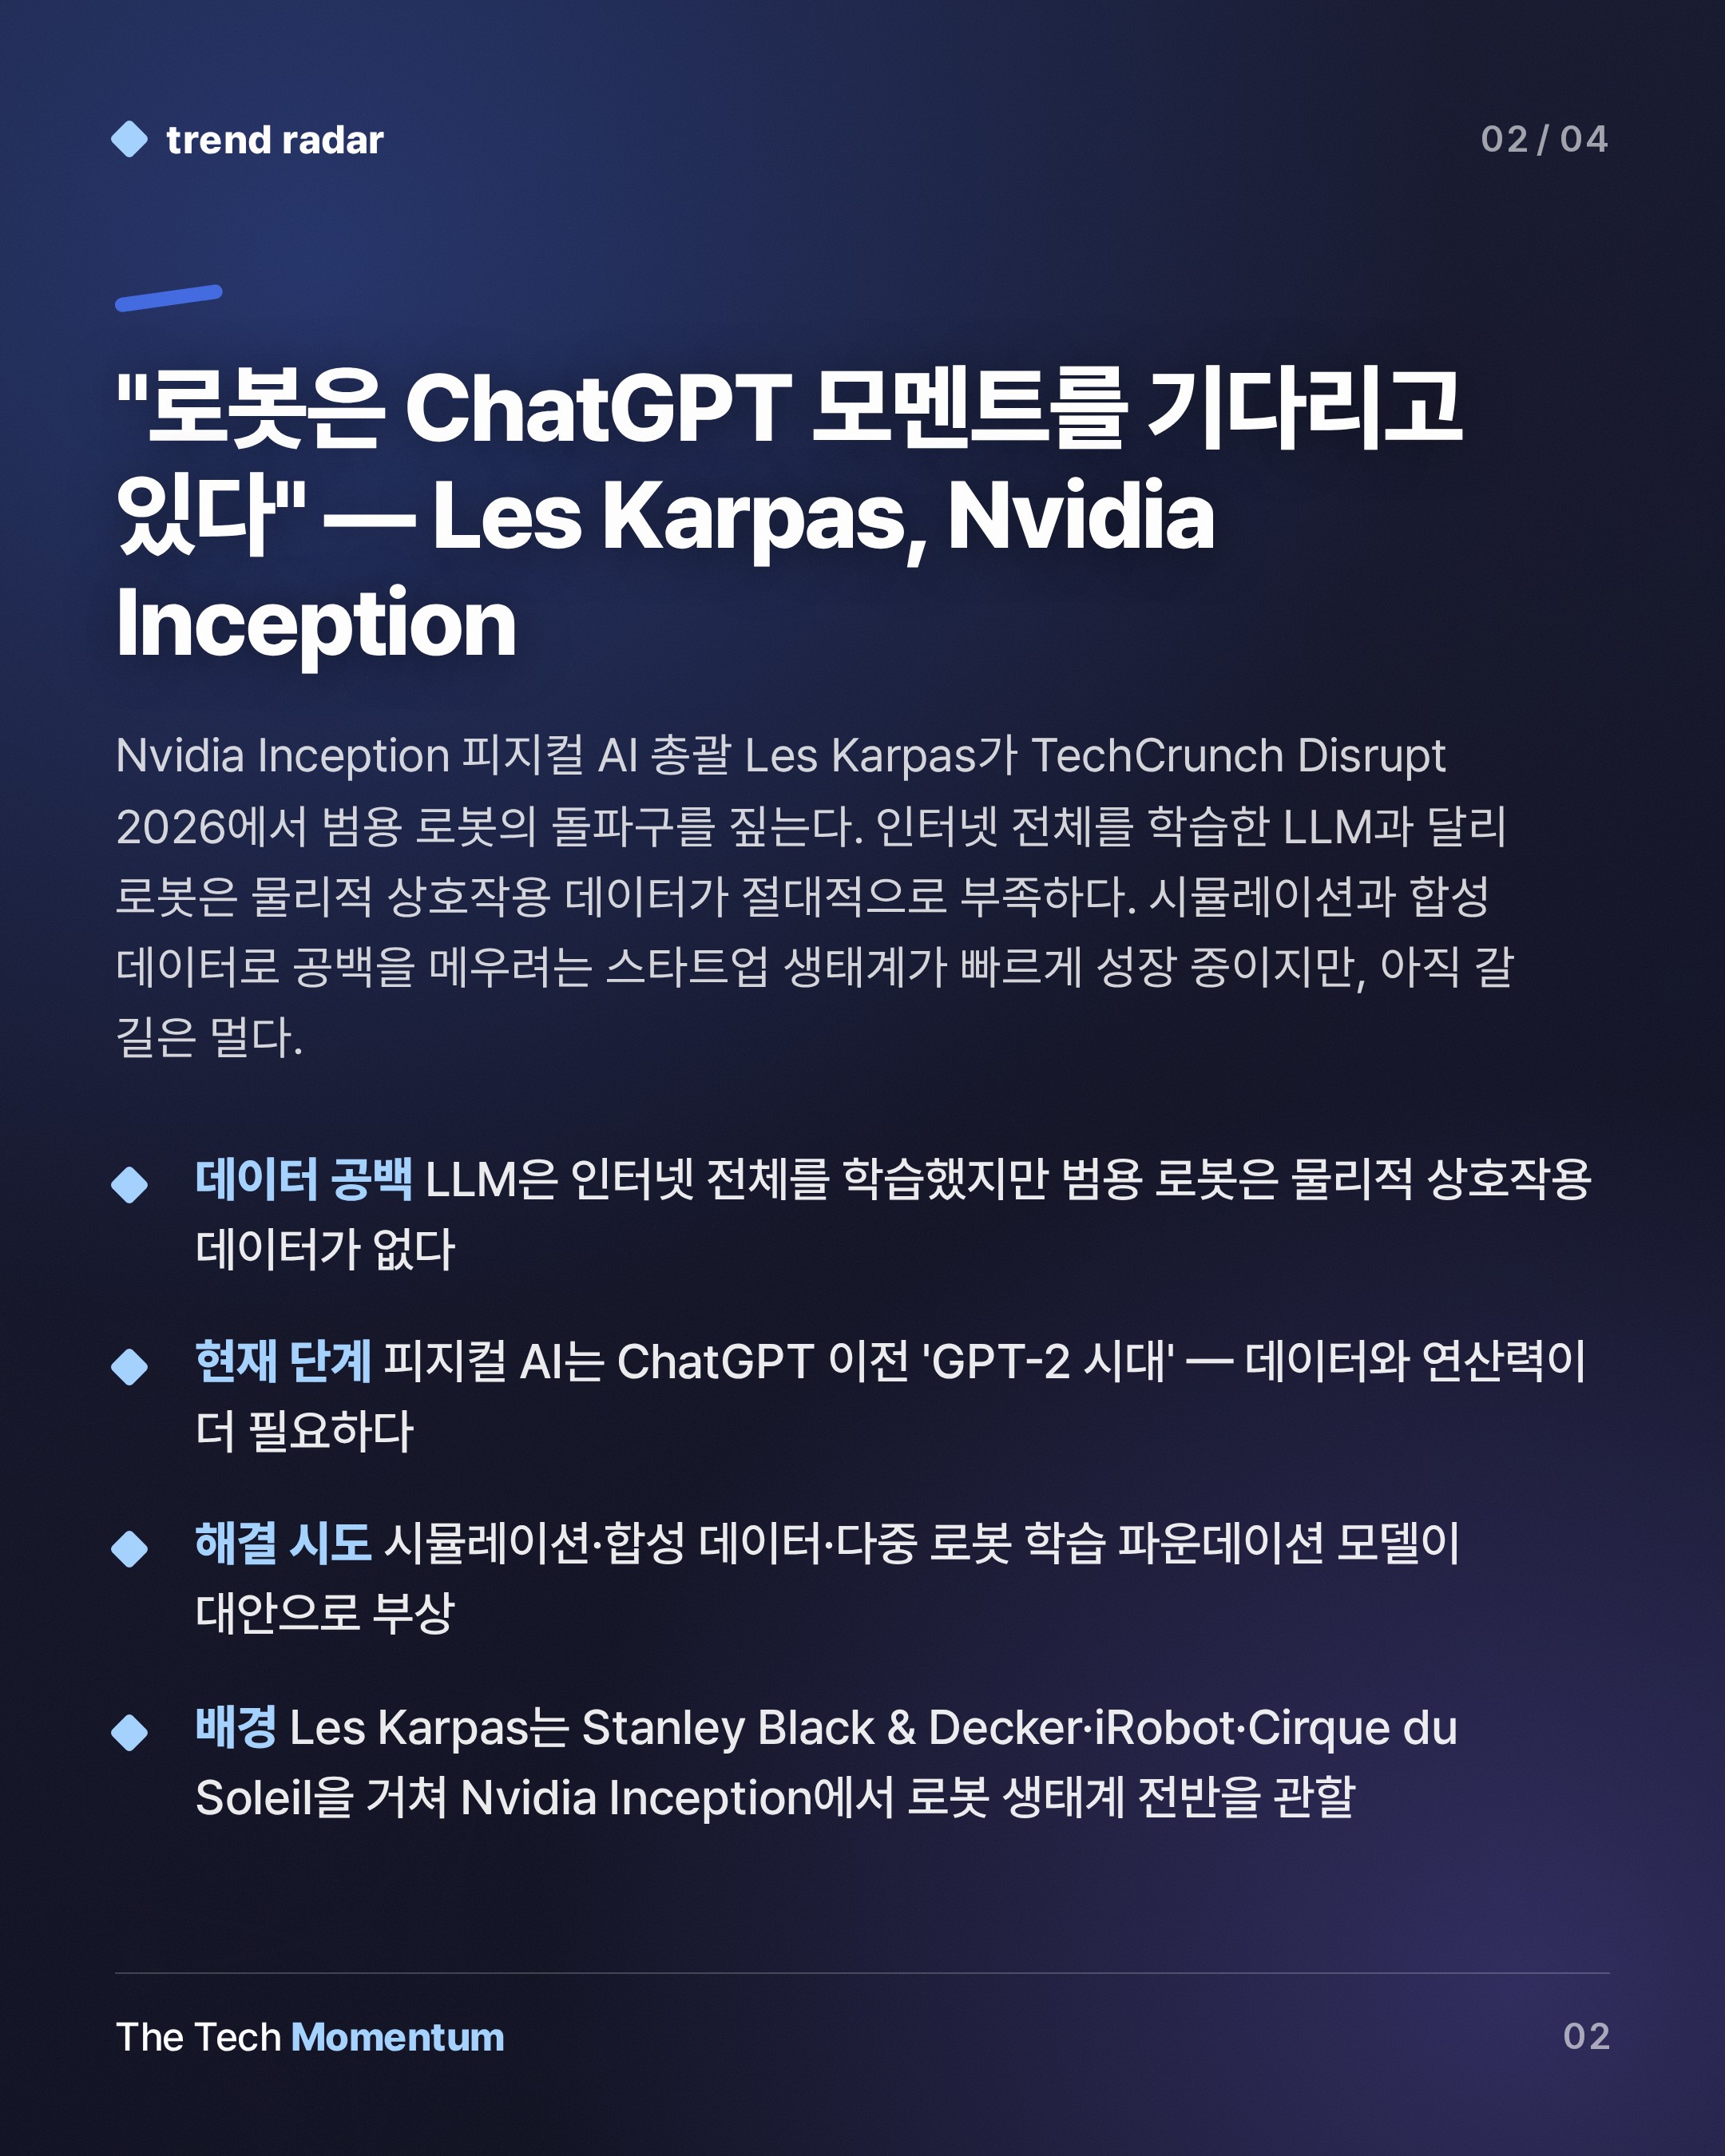
이 공백을 메우려는 스타트업 생태계가 빠르게 커지고 있다. 시뮬레이션, 합성 데이터, 그리고 여러 로봇 형태를 동시에 학습시키는 파운데이션 모델이 그 도구다. 피지컬 AI 시뮬레이션 스타트업 Antioch의 공동창업자 Harry Mellsop은 피지컬 AI가 현재 'GPT-2 시대'에 있다고 표현했다. ChatGPT 이전 단계, 즉 데이터와 연산력이 더 필요한 바로 그 시점이라는 뜻이다.
데모는 인상적이지만, 현장은 다르다
중국 서비스 로봇 기업 OrionStar의 회장 Fu Sheng(푸 성)은 이 격차를 '마지막 1%'로 표현했다. 성공률 99%짜리 로봇은 100번 중 한 번 실패한다. 공장 라인에서 하루에 수백 번 작업을 반복하는 로봇이라면 그 한 번의 실패가 치명적이다. 인상적인 데모와 상업적으로 신뢰할 수 있는 로봇 사이의 거리가 바로 여기에 있다.
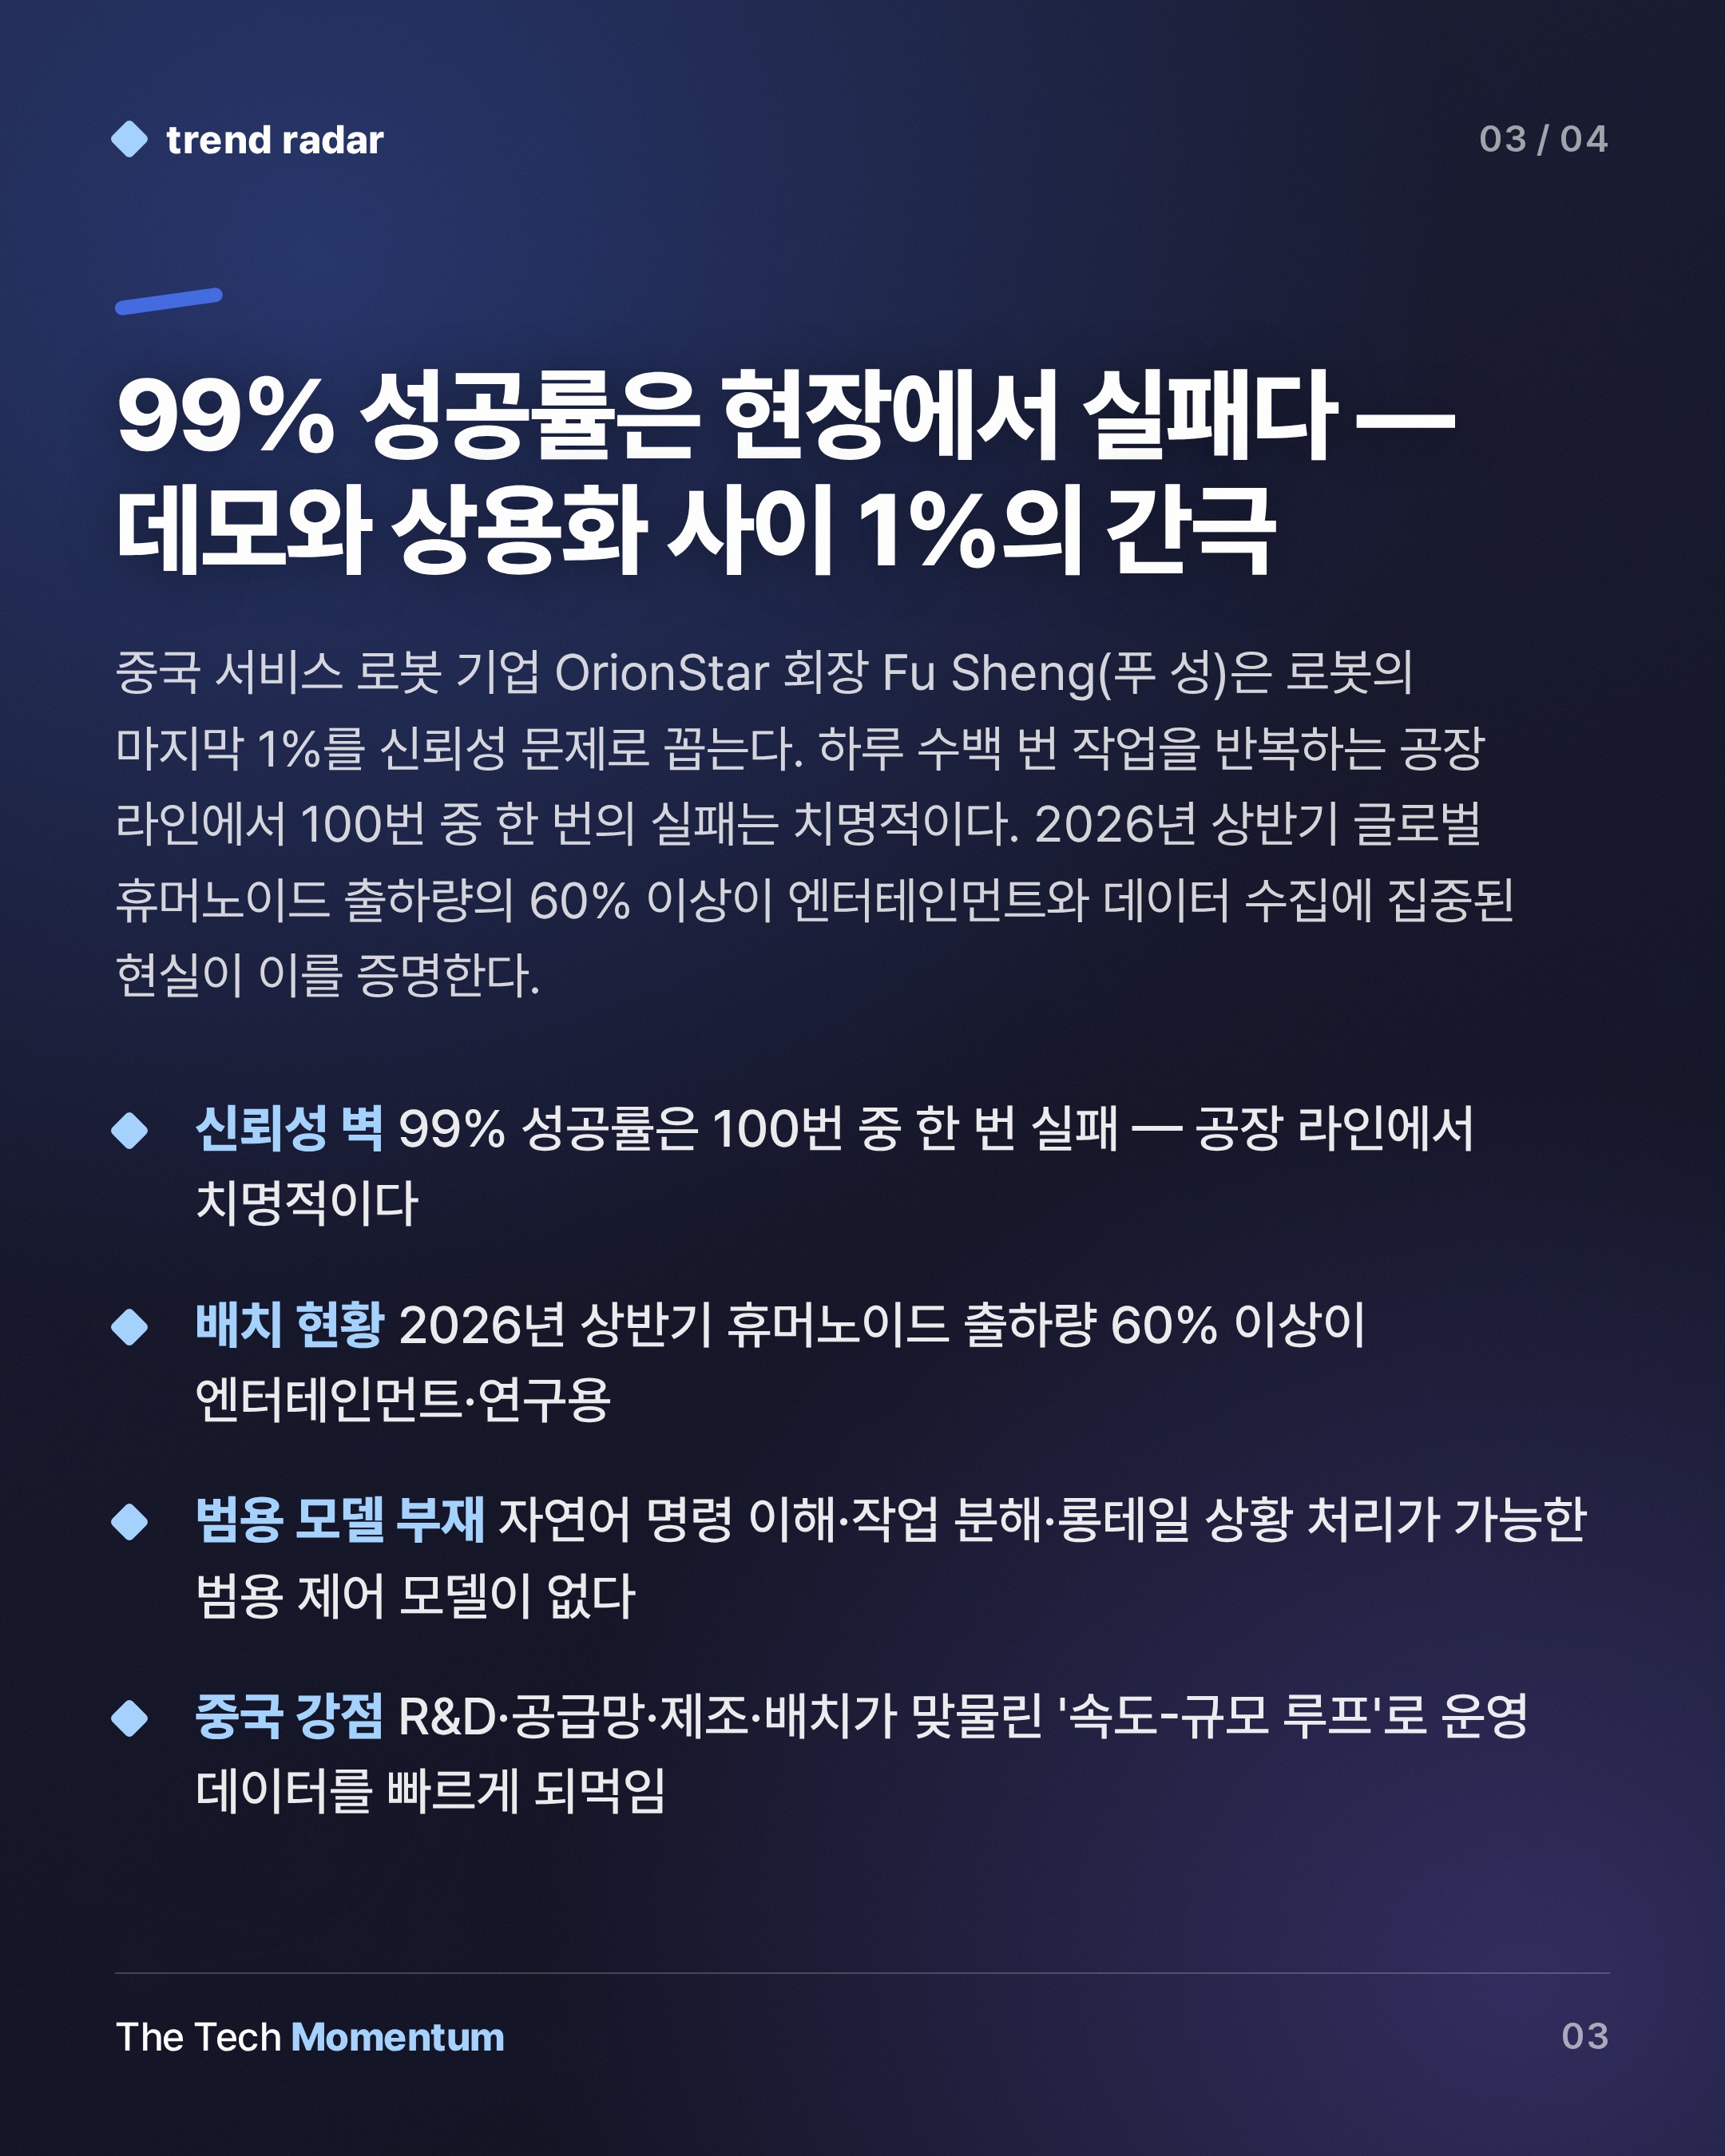
실제 배치 현황도 이를 뒷받침한다. 2026년 상반기 글로벌 휴머노이드 출하량의 60% 이상이 엔터테인먼트·공연(33.6%)과 데이터 수집·연구(27%)에 집중됐다. 스마트 제조와 물류 창고를 합쳐도 20%에 못 미친다. 많은 로봇이 아직 현장에서 일하는 대신 학습 데이터를 모으거나 시연을 하고 있다는 의미다.
범용 모델이 열쇠다
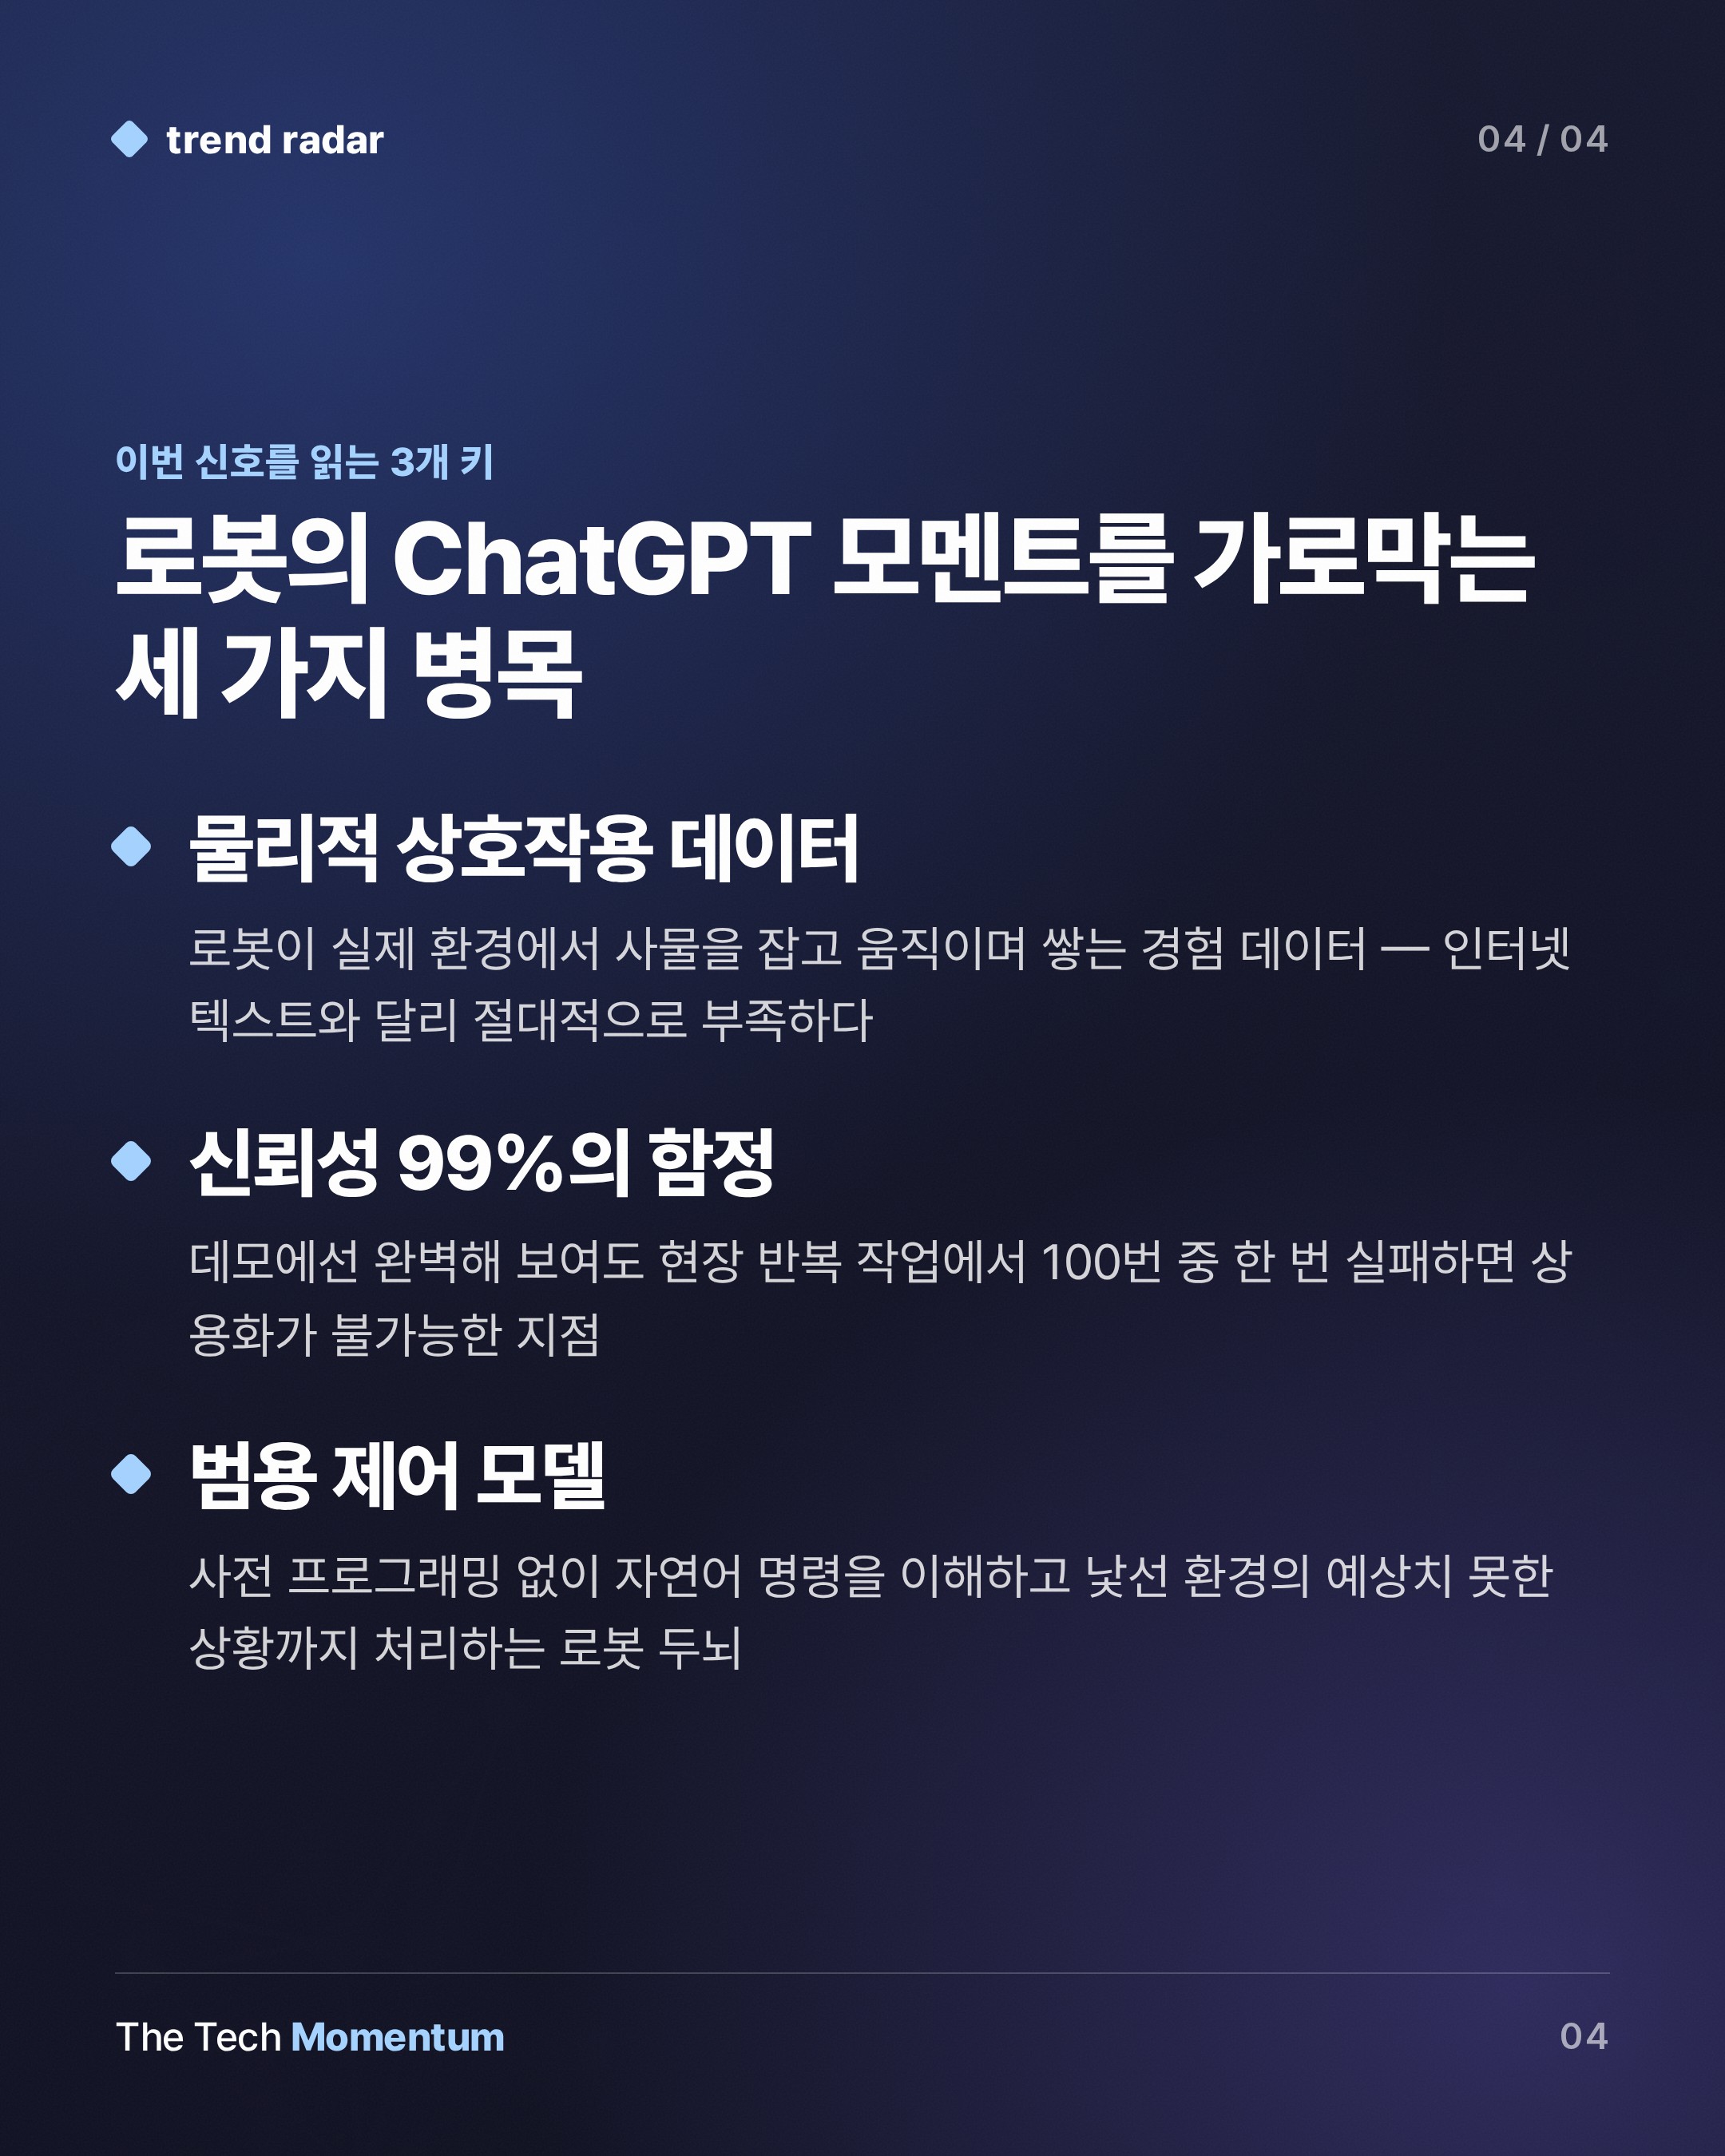
Pangoal Institution의 선임 연구원 Jiang Han은 진정한 ChatGPT 모멘트를 이렇게 정의한다. 로봇이 자연어 명령을 이해하고, 복잡한 작업을 단계별로 분해해 수행하는 범용 구현 지능 모델. 사전에 프로그래밍된 동작에 의존하지 않는 로봇이다. 핵심 병목은 낯선 환경의 '롱테일 상황'을 처리하는 능력이다. 로봇은 예상치 못한 일이 생기면 아직도 실패한다.
Karpas가 이 질문에 답할 적임자인 이유는 그의 이력에 있다. Stanley Black & Decker, iRobot, Cirque du Soleil 등을 거치며 건축가, 제조 엔지니어, 스타트업 CEO, 기업 벤처 캐피털리스트를 두루 경험했다. Nvidia Inception에서는 로봇·자동차·제조·모빌리티·스마트시티에 걸친 스타트업 생태계 전체와 접점을 갖는다. 데이터 공백을 해결하려는 스타트업들이 바로 그가 매일 만나는 사람들이다.
속도-규모 루프, 그리고 남은 과제
Galbot의 최고전략책임자 Yuli Zhao는 중국의 강점을 '속도-규모 루프'로 설명한다. R&D·공급망·제조·통합·배치가 촘촘히 맞물려 운영 데이터를 다음 개발 사이클로 빠르게 되먹이는 구조다. 2026년 상반기 글로벌 휴머노이드 출하량 기준 상위 5개사가 모두 중국 기업이었다는 사실은 이 루프는 실제로 작동하고 있다.
그러나 Jiang Han이 지목한 과제, 즉 데이터 공백·신뢰성·범용 제어 모델 부재는 어느 국가의 로봇 산업도 피해 갈 수 없는 보편적 문제다. 하드웨어 우위를 갖춘 기업이라도 물리적 상호작용 데이터를 어떻게 축적하고 범용 모델로 연결하느냐는 별개의 과제로 남는다. Karpas가 Disrupt 무대에서 풀어낼 답이 로봇 산업 전체에 주목받는 이유다.