목표물 위치 찾기 100%. 필요한 조작을 이해하는 비율 99.6~100%. 그런데 과제 전체를 끝낸 비율은 절반 언저리에 머물렀다. 중국 다롄이공대(Dalian University of Technology) 연구팀이 공개한 VA-Bench가 드러낸 간극이다. 논문은 arXiv(2609.19554)에 올라왔고, 중국어 해설은 Sina Tech가 실었다.
보는 것과 하는 것을 따로 잰다
VA-Bench는 범용 멀티모달 거대언어모델이 본 것을 로봇팔 동작으로 바꿀 수 있는지 평가한다. 관찰, 추론, 실행, 수정의 전 과정이 대상이다.
시험 방식은 까다롭다. 모델은 성공 시연 영상을 먼저 본다. 물체 좌표, 전문가 궤적, 정밀한 동작 값은 주어지지 않는다. 시험 중에는 상호작용 횟수를 써서 카메라 시점을 스스로 바꿀 수 있다. 명령은 모델이 직접 내린다. 축별 이동 거리는 밀리미터 단위, 회전은 각도, 그리퍼를 여닫을 시점까지 지정한다. 고정된 제어기는 모델이 말한 대로만 움직인다.
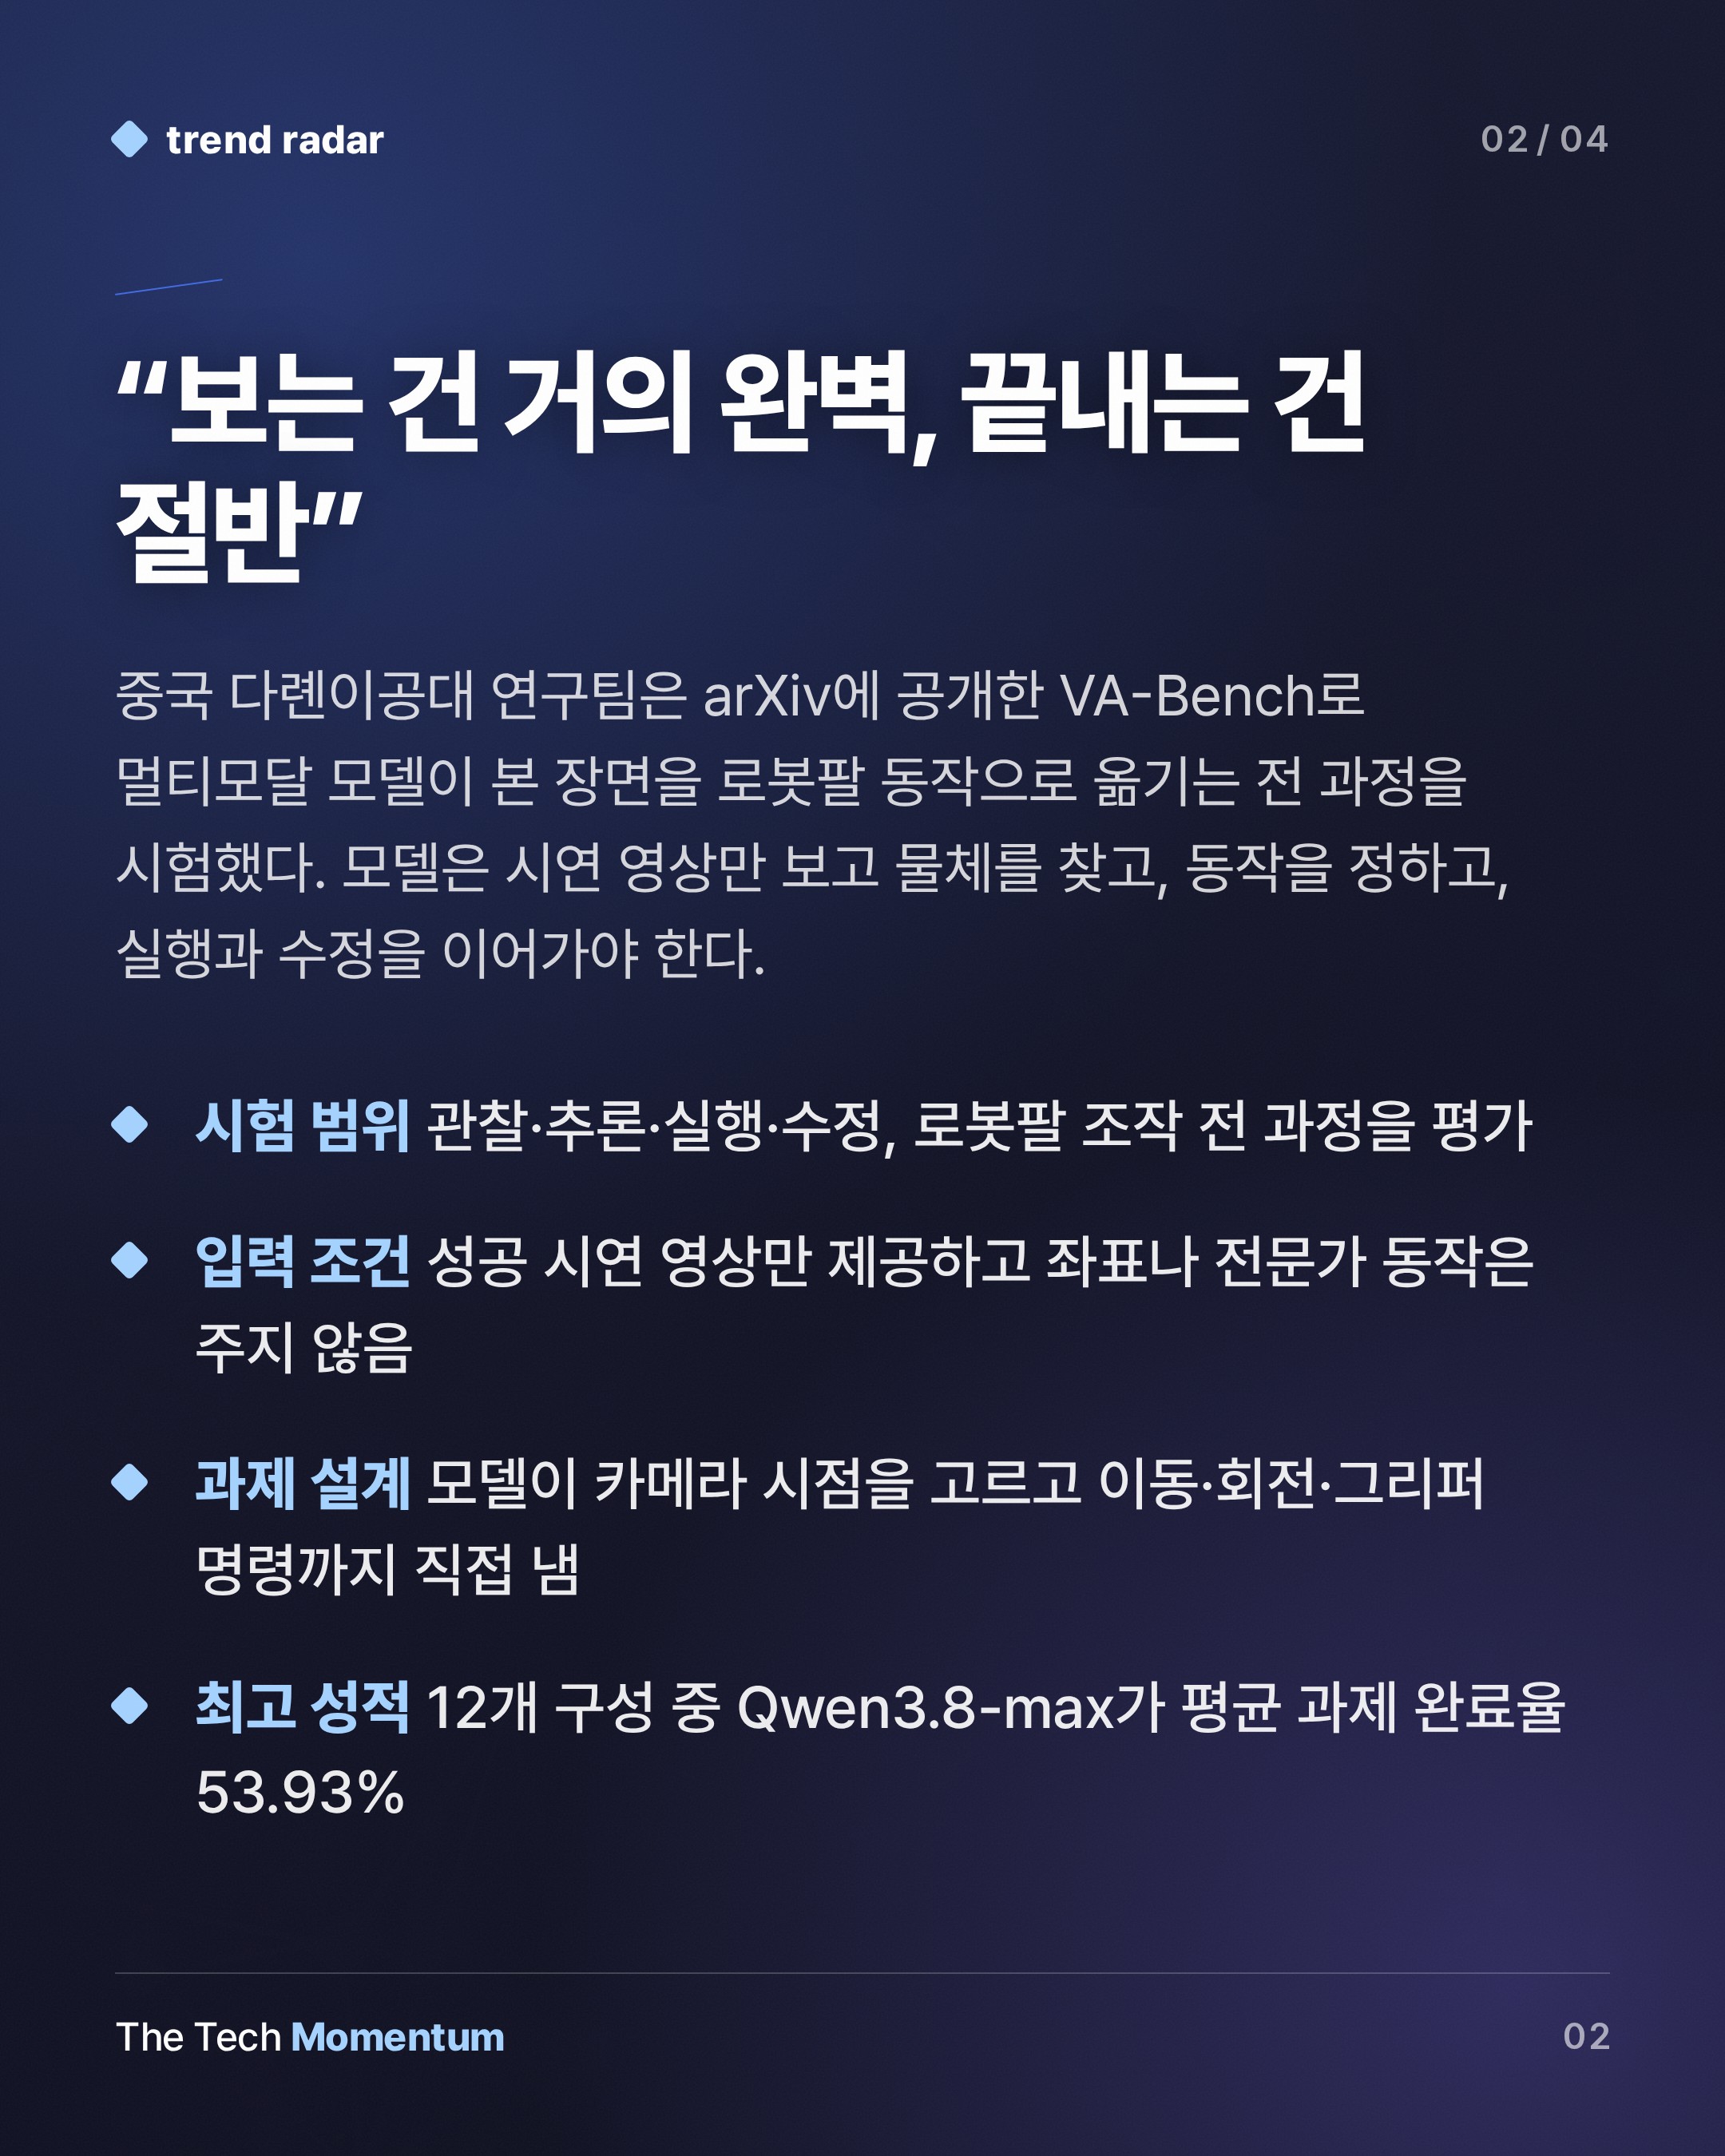
과제는 14종이다. 단일 팔 11종, 양팔 3종이고, 종마다 물리 검증을 거친 시뮬레이션 장면이 20개씩 있어 기본 장면은 280개다. 형태·배치를 바꾼 변형 장면과 물체 5개를 다루는 장기 과제도 더했다. 각 조건은 세 번씩 돌렸다.
1위도 평균 53.93%
12개 모델 구성 가운데 1위는 Alibaba의 Qwen3.8-max로 평균 53.93%를 기록했다. 해외 참조 모델인 Opus-5가 52.86%, GPT-5.6-sol이 51.55%로 뒤를 이었다. 세 모델의 격차는 2.38포인트 안이라 연구진도 신뢰할 만한 순위는 주장하지 않는다. 나머지 조건은 모두 23.10% 이하였다.
상위 모델의 부분 과제 완료율은 65.9~68.6%다. 처음부터 막히기보다 어느 정도 진행하다 무너지는 경우가 많다는 뜻이다.
오류는 알아채도 고치지 못한다
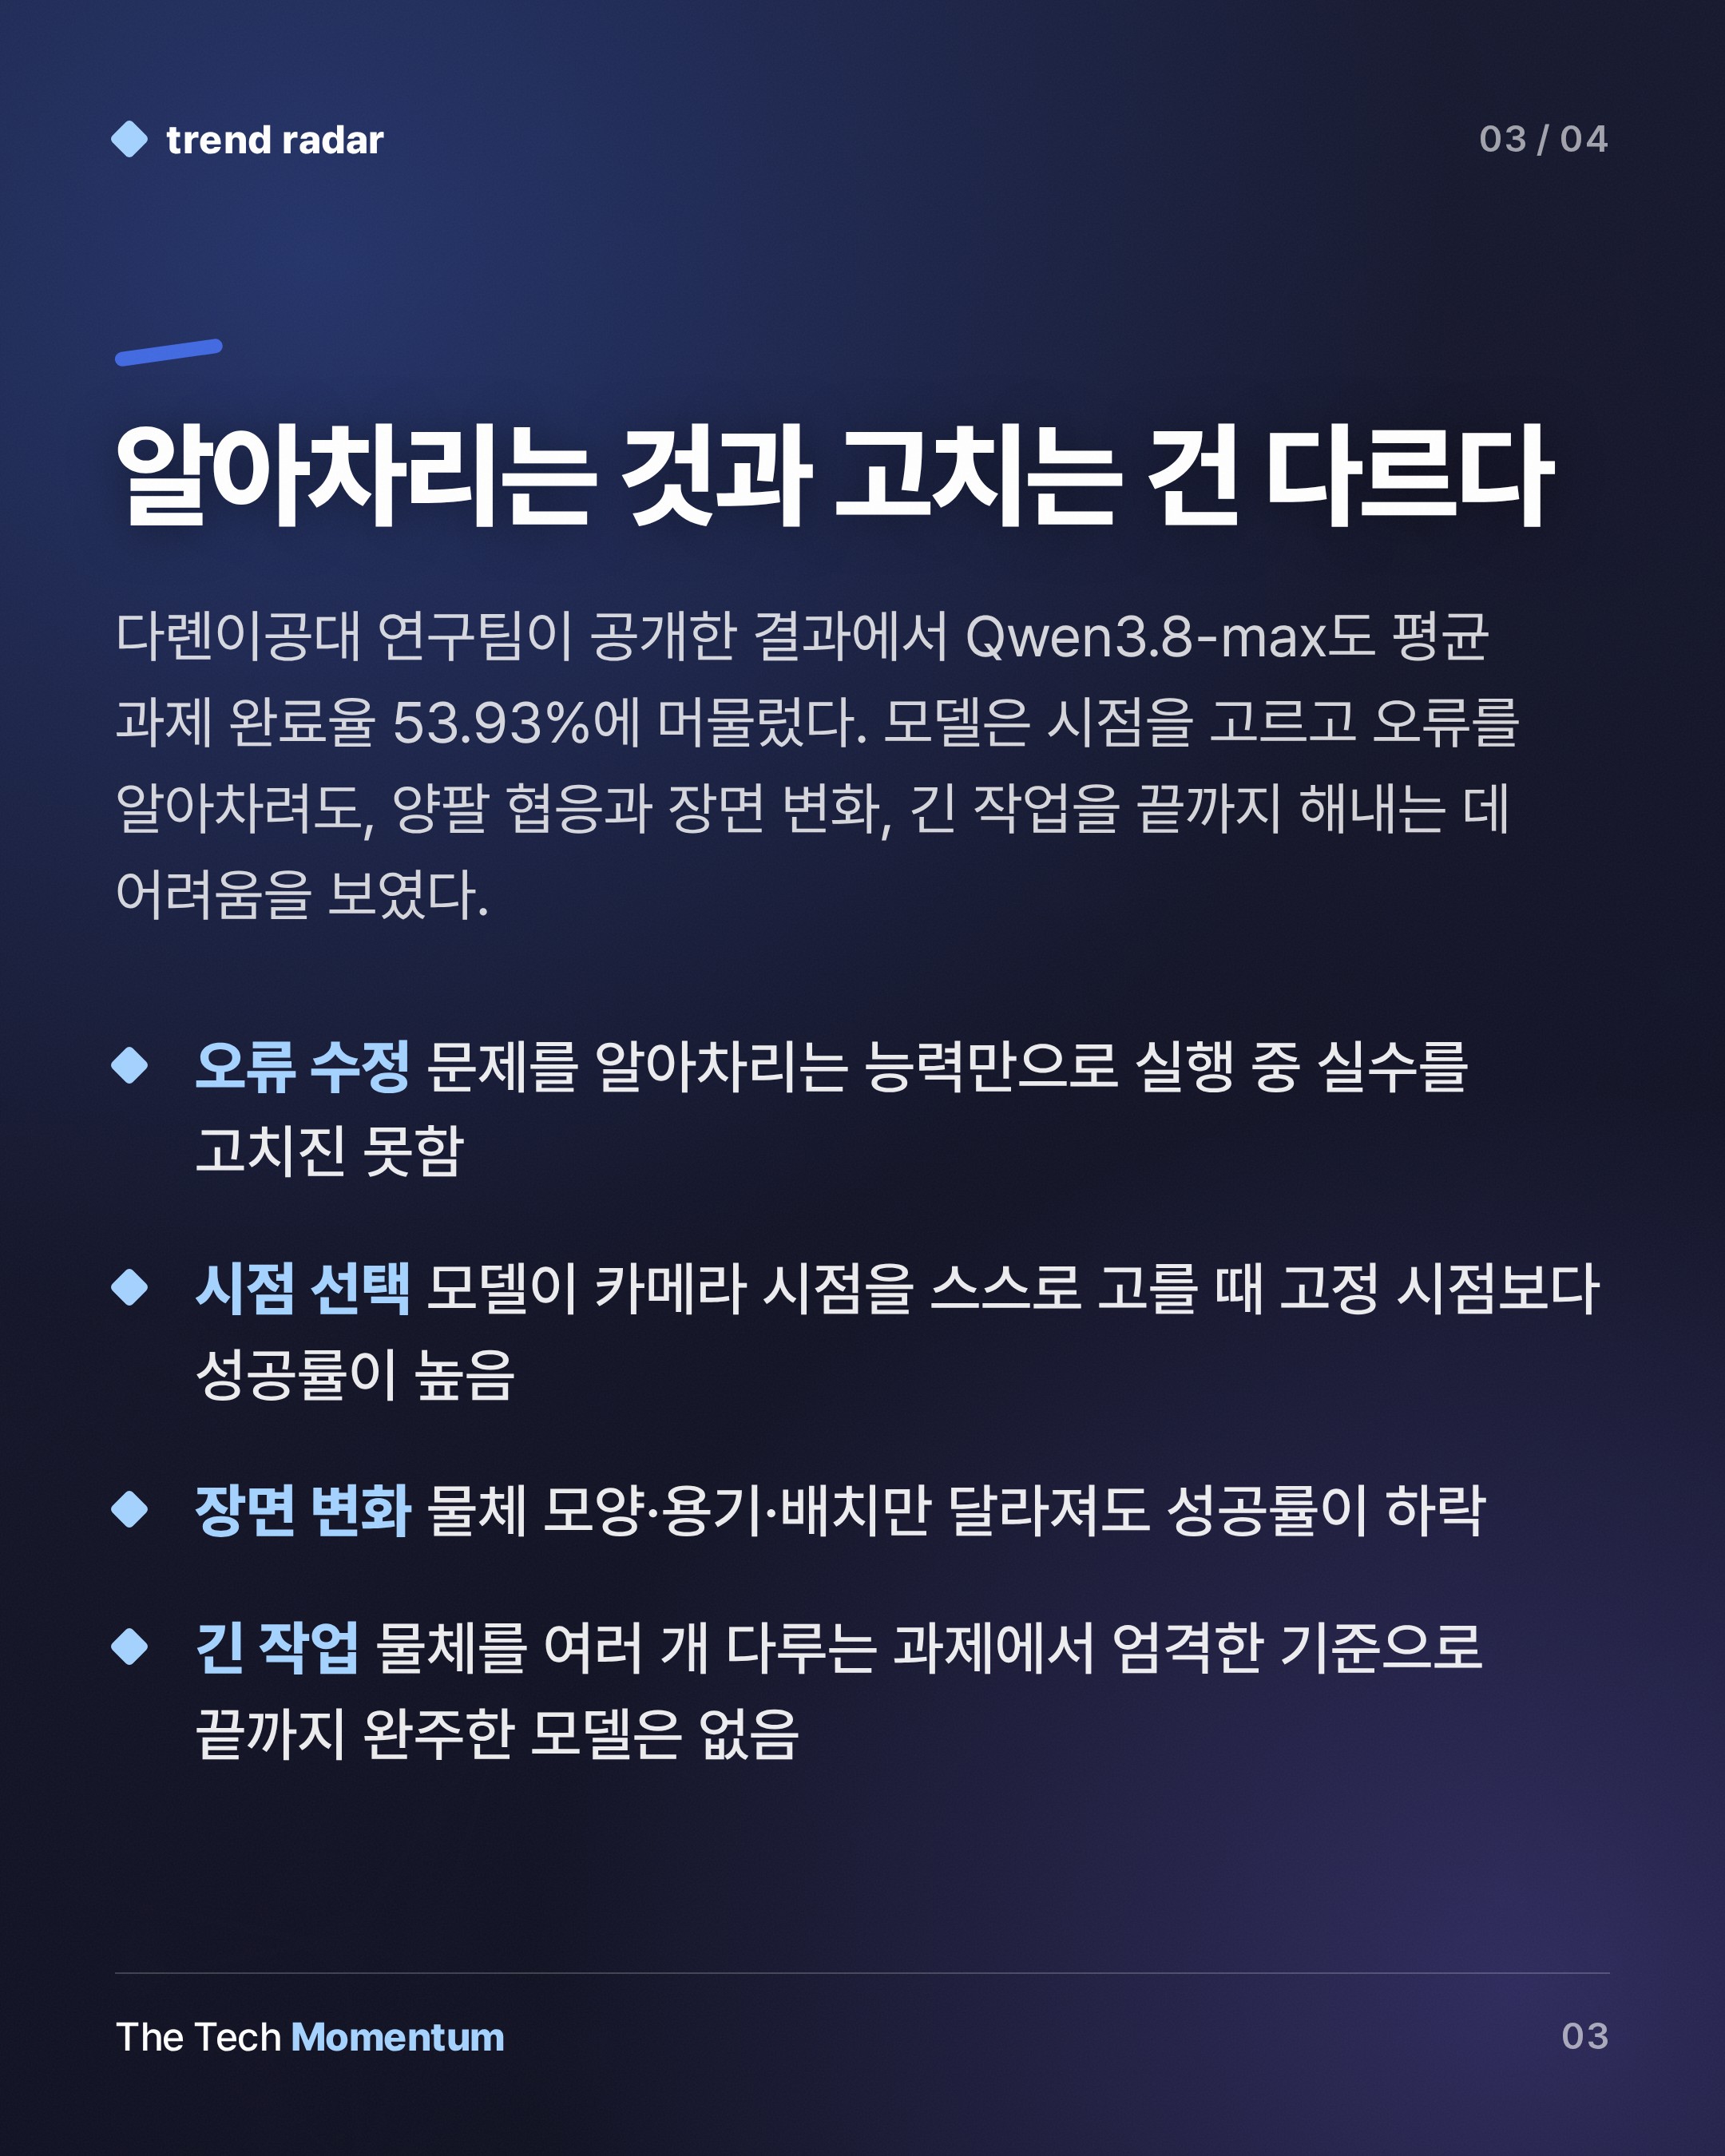
눈에 띄는 격차가 둘 있다. Qwen3.8-max는 오류의 73.6%를 알아챘지만 실행 중 바로잡은 비율은 46.7%에 그쳤다. 성공률은 단일 팔 65.61%, 양팔 11.11%로 갈렸다. 양팔 과제는 물체를 팔마다 배정하고 상대 위치까지 맞춰야 한다.
카메라는 많다고 좋지 않았다. Qwen3.8-max는 스스로 시점을 고를 때 280개 장면 중 57.50%를 성공했고, 고정 시점 5개를 줬을 때는 27.86%였다. 비교에 쓴 4개 모델 모두 능동 관찰이 없으면 성적이 내려갔다.
일반화도 약점이다. 과제는 같게 두고 물체 모양, 용기, 배치만 바꾸자 참조 모델 하나는 80.00%에서 47.86%로 30포인트 넘게 떨어졌다. Qwen3.8-max는 77.86%에서 67.86%로 내려갔다. 물체 5개를 다루는 장기 과제에서 Qwen3.8-max는 100개 중 61개를 제자리에 놓았지만, 엄격한 기준으로 한 에피소드를 완주한 모델은 하나도 없었다.
같은 주, 다른 잣대
이번 주 발표된 SuperCLUE 체화 두뇌 순위는 지각, 추론, 계획을 점수화한다. VA-Bench는 그 판단이 실제 물리 동작의 성공으로 이어지는지를 본다.
VA-Bench는 시점 선택, 오류 수정, 양팔 협응을 수치로 나눠 보여준다.
상위 모델도 과제 절반을 끝내는 수준이다. 양팔 과제 성공률은 11.11%, 장기 과제 완주는 0건이다.