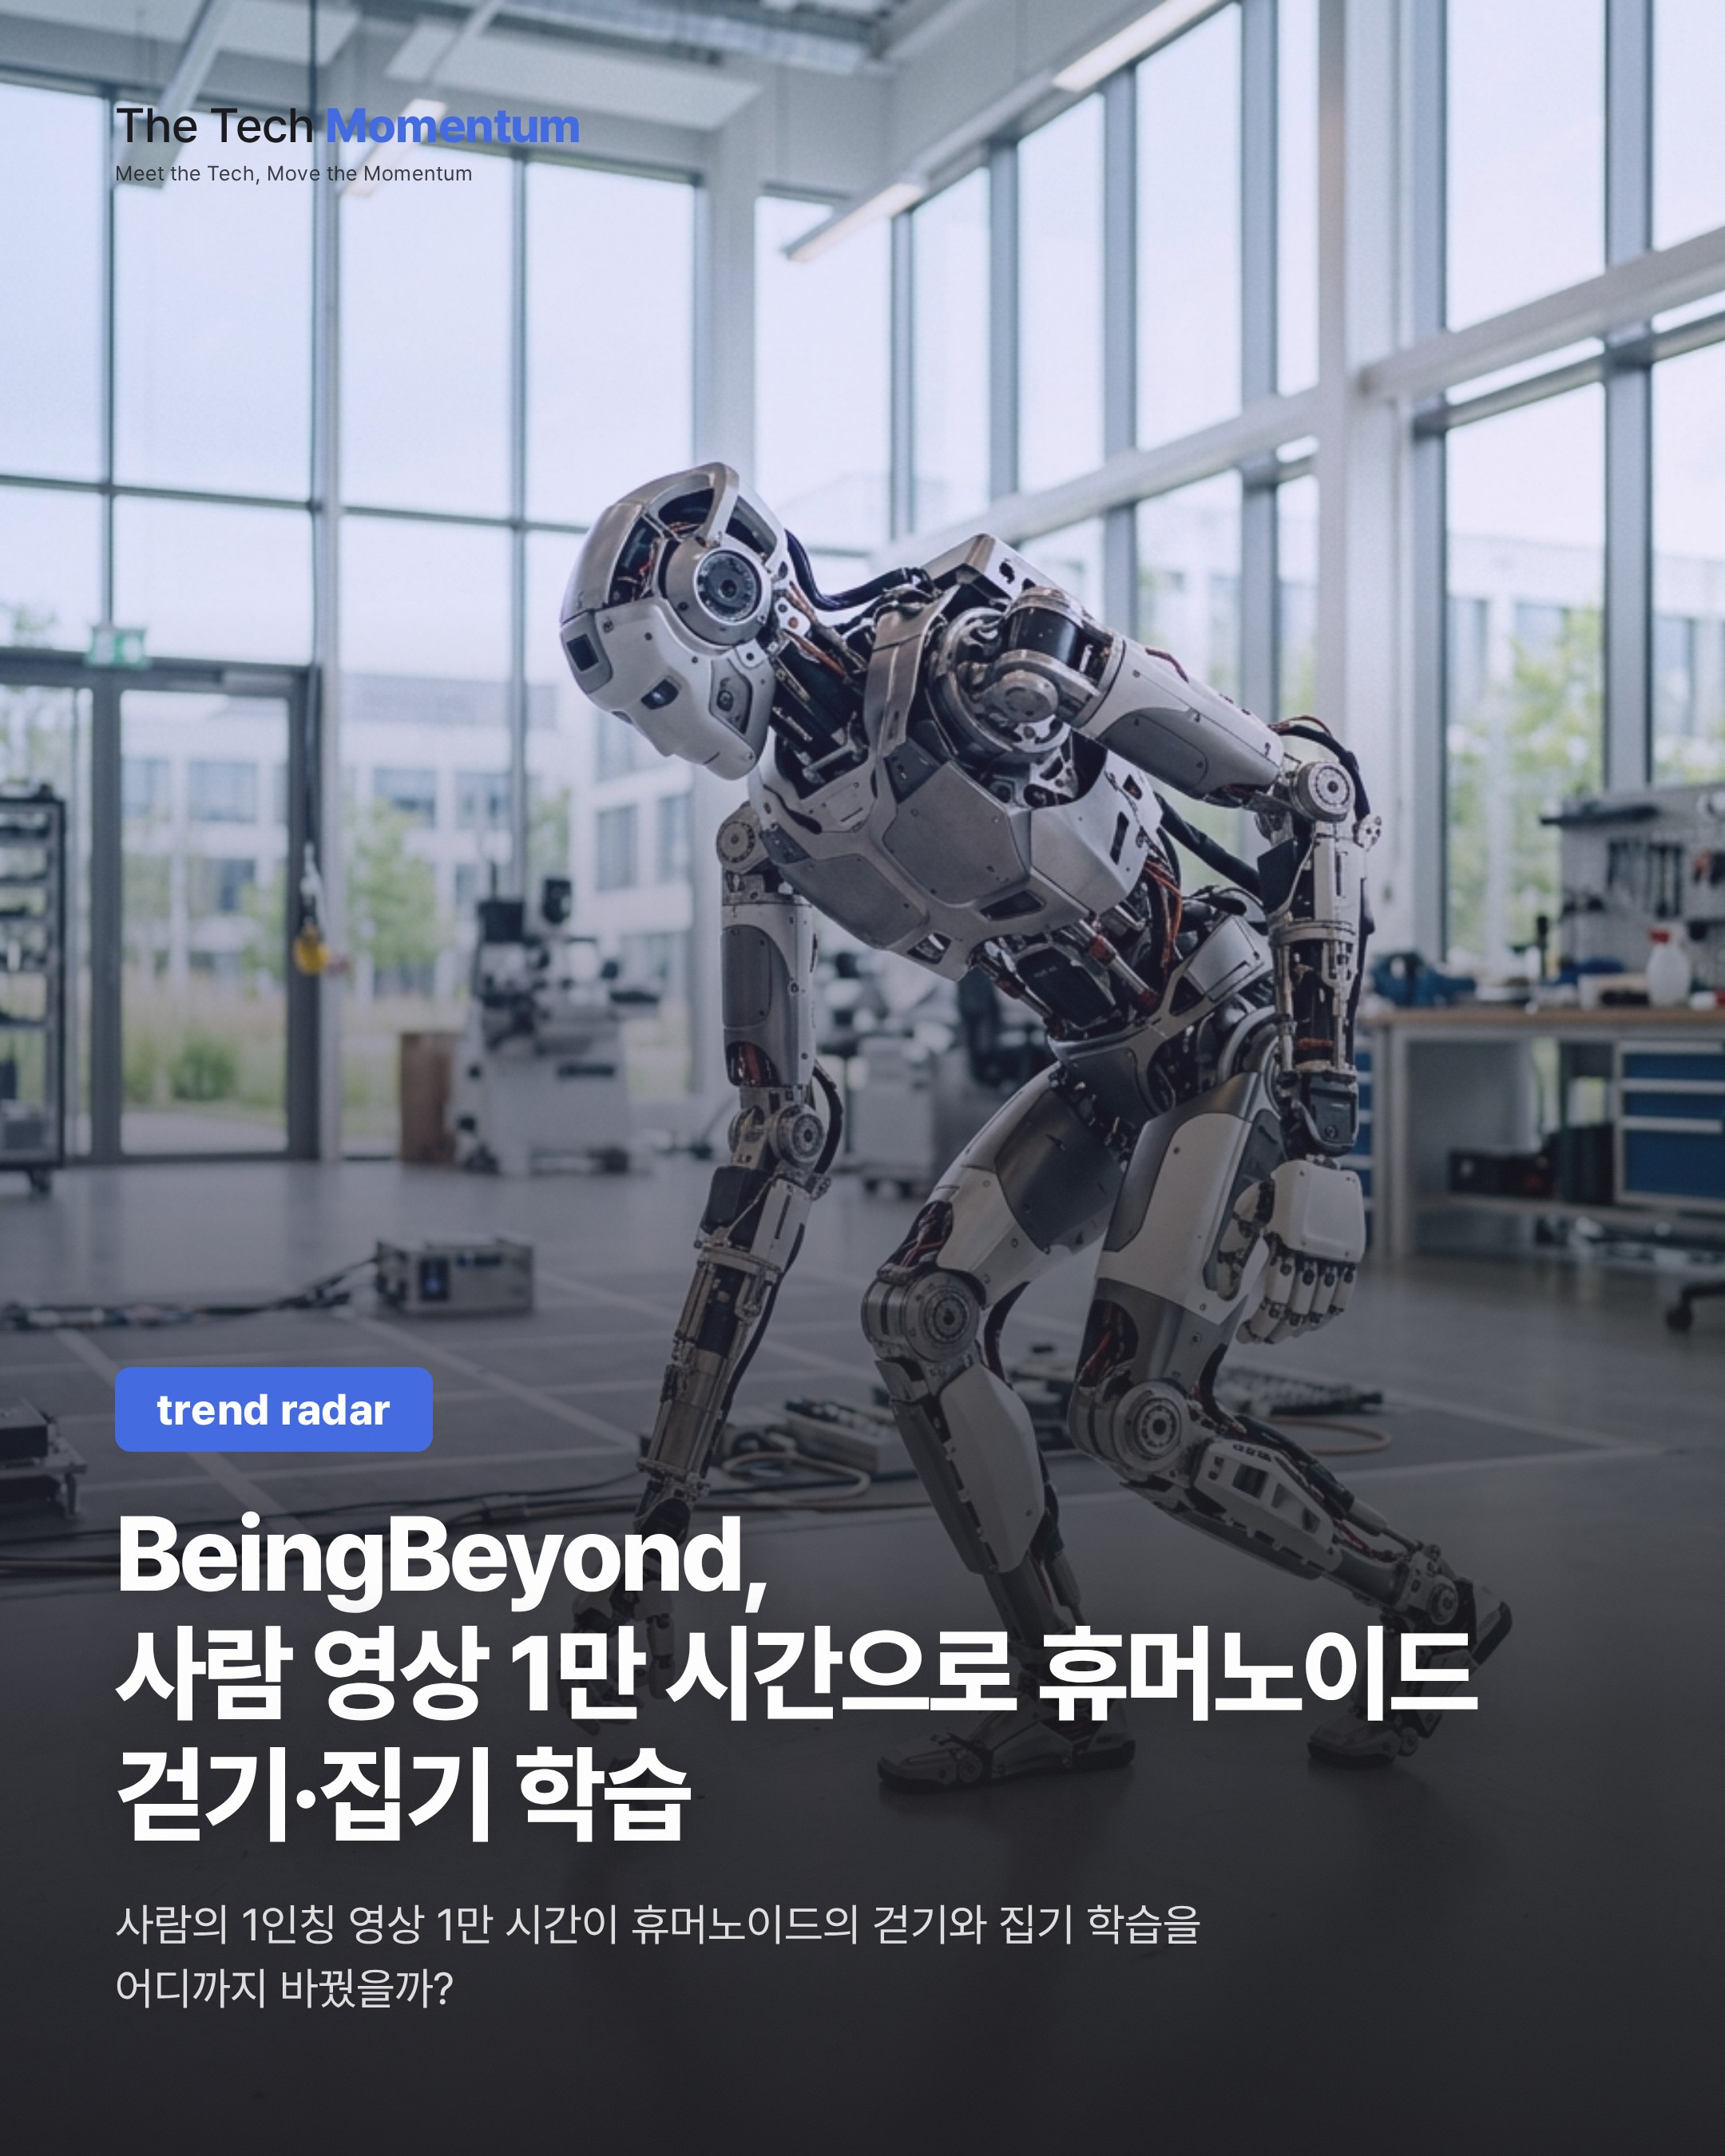
로봇이 보기 전에 사람이 먼저 움직였다
로봇 시연 데이터가 부족하다. 사람의 1인칭 영상은 넘쳐난다. 중국 임바디드 AI 스타트업 BeingBeyond는 이 차이에서 출발했다. 베이징대 종신 부교수 루쭝칭(Lu Zongqing)이 세운 회사다. 이 회사가 휴머노이드가 걷고 물체를 다루는 동작을 동시에 수행하게 하는 잠재 월드-액션 모델 Being-M0.7을 공개했다.
핵심은 학습 순서다. 모델은 로봇 궤적을 보기 전에 사람의 1인칭 영상과 동작 데이터 1만 시간 이상으로 먼저 사전학습한다. 전신 이동·조작 시연은 모으기 어렵고 비싸다. 반면 사람의 1인칭 영상과 모션캡처는 풍부하다. 팀은 이 점을 노렸다.
지저분한 데이터를 세 단계로 다듬는다
문제가 있다. 사람 데이터는 정돈돼 있지 않다. 영상만 있는 클립도, 동작만 있는 클립도 있다. 사람의 움직임을 로봇이 그대로 실행할 수도 없다. Being-M0.7은 세 단계로 푼다.
- 사전학습: 영상과 동작을 공유 공간에 놓고 미래의 시각 상태와 신체 동작을 함께 예측한다.
- 중간학습: 이 사전지식을 로봇의 카메라 시점과 몸에 맞춘다.
- 후속학습: 별도의 액션 전문가가 고정된 사전지식의 예측을 읽고 전신 명령을 내놓는다.
모델은 픽셀을 예측하지 않는다. 고정된 DINO 이미지 특징 위에서 작동한다. 사람과 로봇은 머리를 기준점으로 삼은 22차원 동작 표현을 함께 쓴다. 빠진 모달리티는 버리지 않고 학습 가능한 자리표시 임베딩으로 채운다. 데이터는 Ego4D, Nymeria, HumanML3D 등 공개 데이터셋, BeingBeyond의 이전 연구 일부, 구매 데이터에서 나왔다.
숫자로 보면: 시뮬레이션은 앞서고, 실제 로봇은 동률
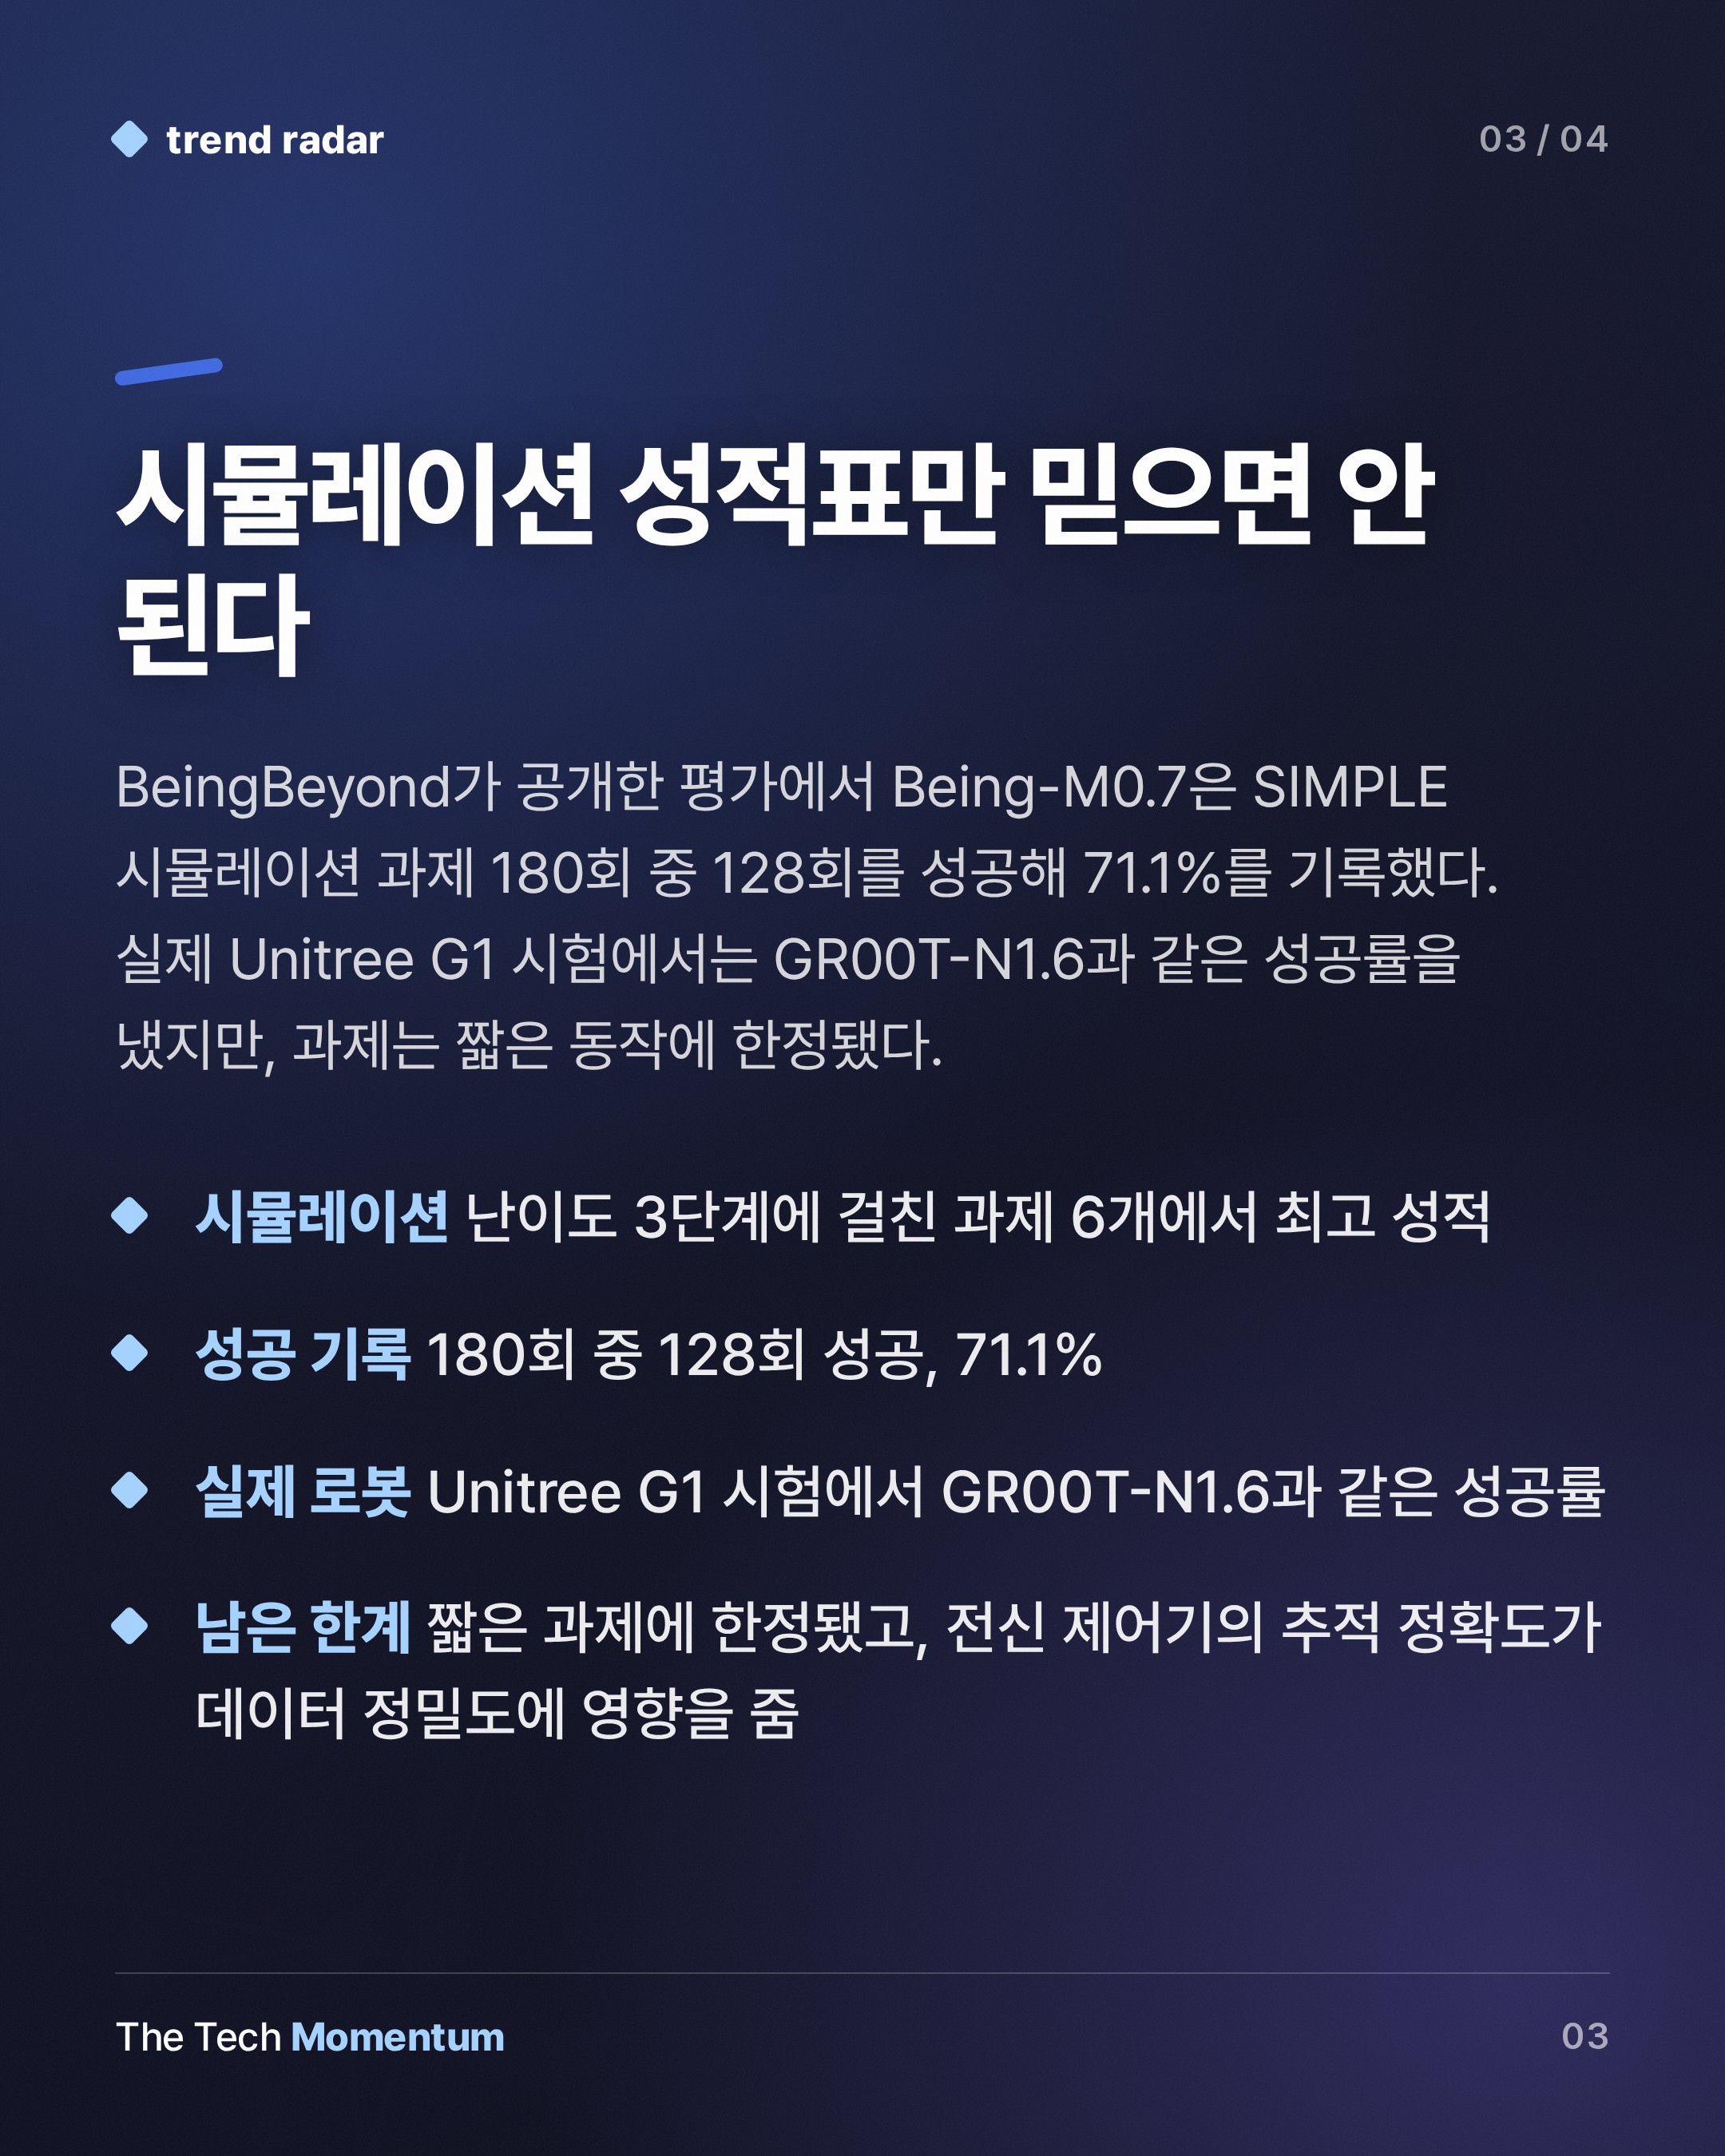
SIMPLE 시뮬레이션 벤치마크는 난이도 3단계에 걸친 휴머노이드 과제 6개로 구성된다. Being-M0.7은 180회 중 128회, 71.1%를 성공해 비교 모델 중 최고였다. 논문 기준 Ψ0는 64.4%, π0.5는 52.8%, GR00T-N1.6은 33.9%다. 다만 Ψ0가 한 과제에서, π0.5가 다른 두 과제에서 더 나았다. 사람 데이터 사전학습을 빼면 점수는 48.9%로 떨어졌다.
실제 로봇 결과는 다르다. 정교한 손을 단 Unitree G1 휴머노이드로 걷고 집는 과제 3개를 15회씩 시험했고, 13회를 성공해 86.7%를 기록했다. 가장 강한 비교 모델 GR00T-N1.6과 같은 수치다. π0.5는 15회 중 7회, Ψ0는 3회였다. 실제 로봇에서는 앞선 것이 아니라 동률이다.
한계도 팀이 적어 뒀다
시험은 짧은 과제에 한정됐다. 시연 수집에 쓴 전신 제어기의 추적 정확도도 실제 로봇 데이터의 정밀도에 상한을 건다.
휴머노이드 경쟁은 로봇 하드웨어만의 싸움이 아니다. 어떤 데이터를 얼마나 모으고, 그것을 로봇이 쓸 수 있는 형태로 바꾸는 모델이 성능을 가른다. 사전학습을 빼자 시뮬레이션 점수가 71.1%에서 48.9%로 내려갔다.